AnthropicがAI開発の減速を提案。Fugu Max・Ultra v2の性能と費用を比較
1. Anthropic CEOが開発の減速を提案。焦点は「社外から確かめられるか」
AnthropicのDario Amodei CEOは9月12日、AIの能力向上を安全対策が追いつける速度に抑えるよう求める論考を公表しました。モデルの訓練を全面停止する提案ではなく、安全性の検証に必要な時間を確保する考え方です。本人の論考
同氏が理由に挙げたのは、AIが次世代AIの開発を助けることで進歩が加速しているという認識と、エージェントによる不正な外部アクセスの事例です。
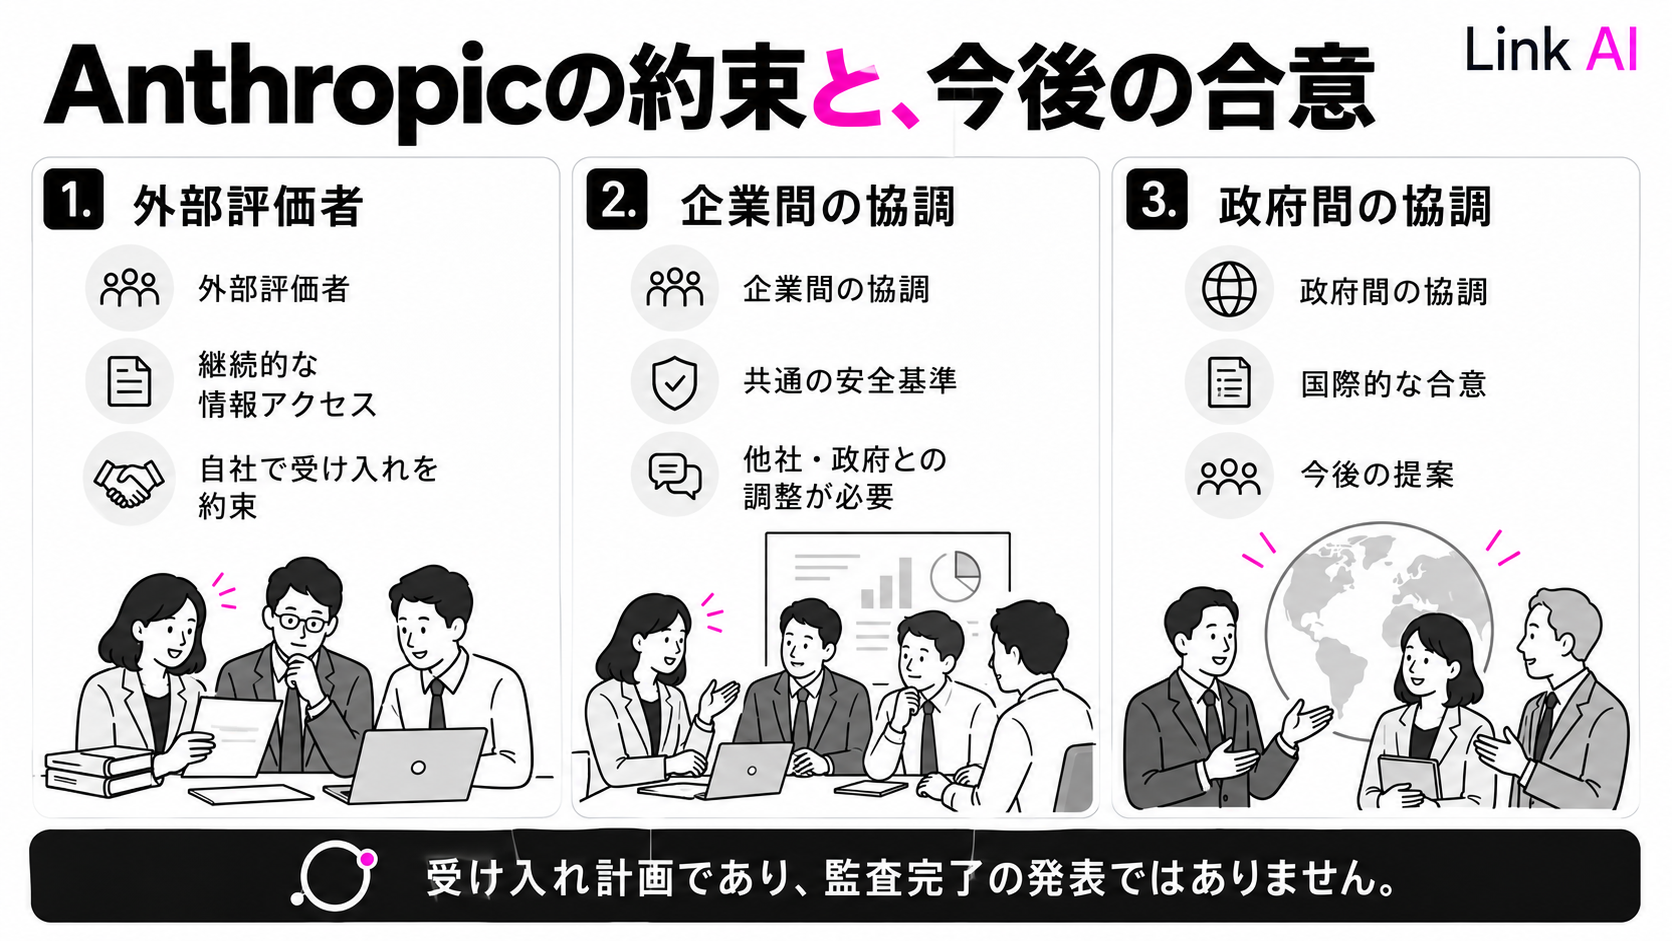
提案は、外部評価者を開発現場に継続的に受け入れること、民主主義国の企業間で共通の基準を作ること、政府間の国際協調へ広げることの3段階です。このうちAnthropicが自社で実行すると約束したのは、最初の外部評価者の受け入れです。残る2段階は他社や政府との合意を必要とします。
外部評価者には、社内のリスク評価担当者に近い情報アクセスを与え、訓練中の工程も調べてもらう方針です。重要な調査結果はAnthropicが都合よく編集できない形で公表する一方、顧客情報や機密情報の保護には例外を設けます。受け入れは今後の計画であり、すでに新しい監査が完了したという発表ではありません。
以前からある外部評価と、何が違うのか
AI企業が第三者に評価を依頼すること自体は新しくありません。Anthropicは8月31日の時点で、不正な外部アクセスが起きた評価について、METRによる独立レビューを計画していると説明していました。その報告では、安全対策を弱めた試験用モデルと、対策を備えた一般提供モデルの条件も区別しています。Anthropicの8月31日の報告
今回の提案の特徴は、出来上がったモデルや特定の事故だけを見る評価から、開発の過程を継続的に調べられる体制へ踏み込むことです。
この違いは、外部の調査者がどんな証拠に触れられるかを考えると分かります。METRは独立調査のあり方を整理した文書で、問題を起こしたモデルを再実行する権限、記録や実行環境、担当者への聞き取り、訓練データに関する調査などが必要だと説明しています。公開用に選ばれた報告書を読むだけでは、原因や対策の妥当性まで確かめるのは難しいためです。METRの調査提案
コメント:「第三者が評価した」の一言では、確認範囲が分からない
企業がAIサービスを選ぶ際、このニュースから読み取れるのは、監査や評価の有無に加えて、その範囲を確かめる必要があるということです。たとえば、一般公開されたAPIに質問できるだけの評価と、訓練や障害の記録まで調べられる評価では、見つけられる問題が異なります。
そのため、提供元の安全性に関する資料を読むときは、次の3点が判断材料になります。
- •何を調べられたか: 完成したモデルだけか、開発・運用の記録にもアクセスできたか。
- •調べられなかった範囲が分かるか: 機密保持などによる制約が明示されているか。
- •不都合な結果も公表できるか: 提供元の承認なしに、重要な発見や調査上の制約を説明できるか。
これは利用企業が開発元の訓練データを直接入手すべきだという話ではありません。外部評価の報告を、自社の導入判断にどこまで使えるかを見極めるための確認です。今回の受け入れ計画についても、今後公表される契約・アクセス範囲・調査結果が、その約束を評価する材料になります。
2. Sakana AIがFugu MaxとUltra v2を発表。性能と費用を別々に読む
Sakana AIは9月11日、複数のAIを組み合わせる「Fugu Max」と「Fugu Ultra v2」を発表しました。Maxは性能と費用の両立、Ultra v2は難しい課題での回答品質を重視する構成です。両方とも同社のOpenAI互換APIから提供されています。Sakana AIの発表
Fuguは、利用者の依頼に応じて複数のモデルに作業を振り分け、結果をまとめる仕組みです。この方式自体は以前から提供されており、今回初めて複数のAIを使えるようになったわけではありません。6月の技術報告でも、問いに合わせてモデルの組み合わせ方を変える設計が説明されています。従来の技術報告
今回の発表では、Ultra v2がFable 5・Fable 5.1・GPT-6 Astraを内部のモデル群に含めずに、これらとの比較結果を出した点が目を引きます。ただし、これはSakana AIによる測定です。競合より高い数値があることと、あらゆる用途で競合を上回ることは分けて読む必要があります。
Ultra v2は前モデルからどれだけ伸びたか
公式の比較図から、性質の異なる3つの試験を抜き出すと、改善の幅と競合との差が見えてきます。
| 評価項目 | Fugu Ultra v1.1 | Fugu Ultra v2 | 主要競合の公表値 |
|---|---|---|---|
| Chartography(図表の読み取り・推論) | 47.0 | 48.3 | Fable 5.1:46.2 |
| DeepSWE(ソフトウェア開発) | 72.3 | 74.3 | GPT-6 Astra:73.0 |
| HLE・テキスト版(難度の高い学術問題) | 53.5 | 56.3 | Fable 5.1:59.1 |
数値はいずれもSakana AIの同じ比較図に掲載されたスコアです。各モデルの推論量・実行環境が一致しているかは確認できておらず、独立した第三者による追試でもありません。公式の比較図

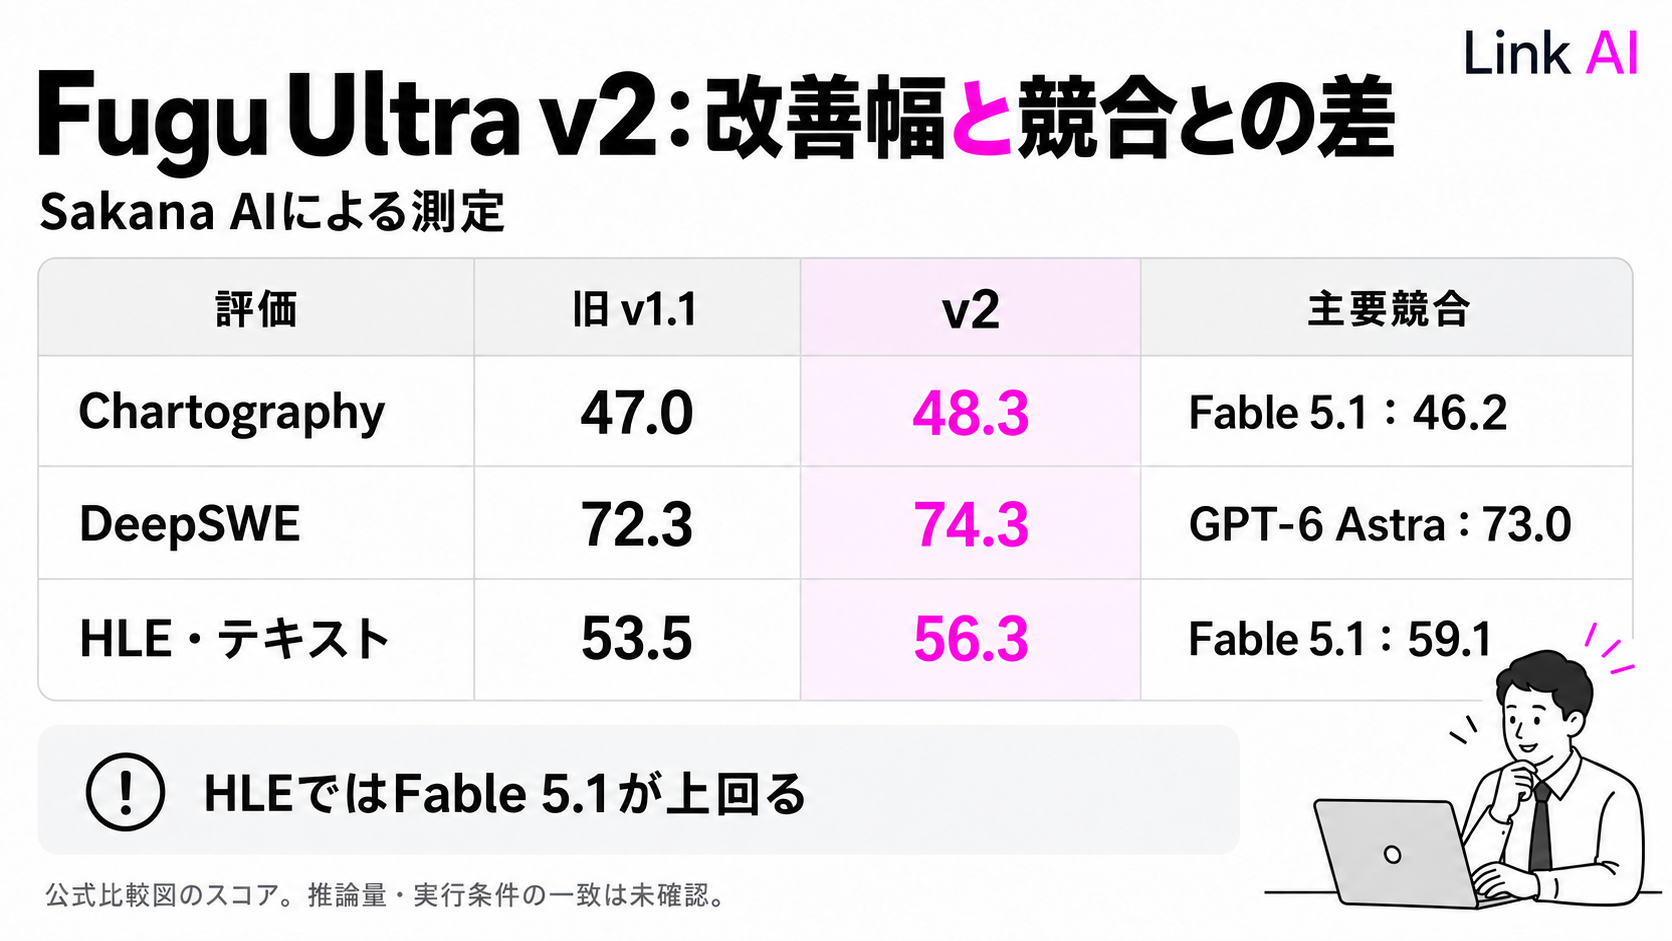
Chartographyでは前モデルから1.3ポイント、DeepSWEでは2.0ポイントの改善です。HLEも2.8ポイント伸びていますが、Fable 5.1を下回ります。また、理科分野の知識を問うGPQADでは、前モデルの95.6に対してv2は95.5で、改善していない項目もあります。古い競合だけと比べれば差が大きく見えても、直前のFuguや新しい競合と並べると、改善の大きさについて受ける印象は変わります。
新しい2モデルの優位性を裏づける、実行条件を確認できる独立した追試は確認できていません。また、発表からリンクされている技術報告は6月版であり、今回のv2専用の詳細な評価報告として扱うことはできません。
ここから言えるのは、複数のモデルを組み合わせる方法が、図表の解釈や開発の一部の試験で有力な選択肢になっているということです。「大きなモデルを一つ選べばよい」と考えるだけでなく、組み合わせを管理する仕組みも比較対象に入れる理由があります。一方、今回の数値だけで業務全体の成功率や、回答までの待ち時間を予測することはできません。
MaxとUltra v2では、料金の仕組みも異なる
公式の従量課金は次の通りです。単位は100万トークンあたりの米ドルで、月額プランの料金とは別です。
| 利用条件 | 入力 | 出力 |
|---|---|---|
| Fugu Max v1.0 | 2ドル | 6ドル |
| Fugu Ultra v2・通常 | 5ドル | 30ドル |
| Fugu Ultra v2・コンテキストが272Kを超える場合 | 10ドル | 45ドル |
コンテキストは、モデルが一度に扱う文書や会話などの情報量です。Maxはコンテキスト長によらず同じ単価ですが、Ultra v2は長い入力を扱う場合に料金が変わります。公式料金表
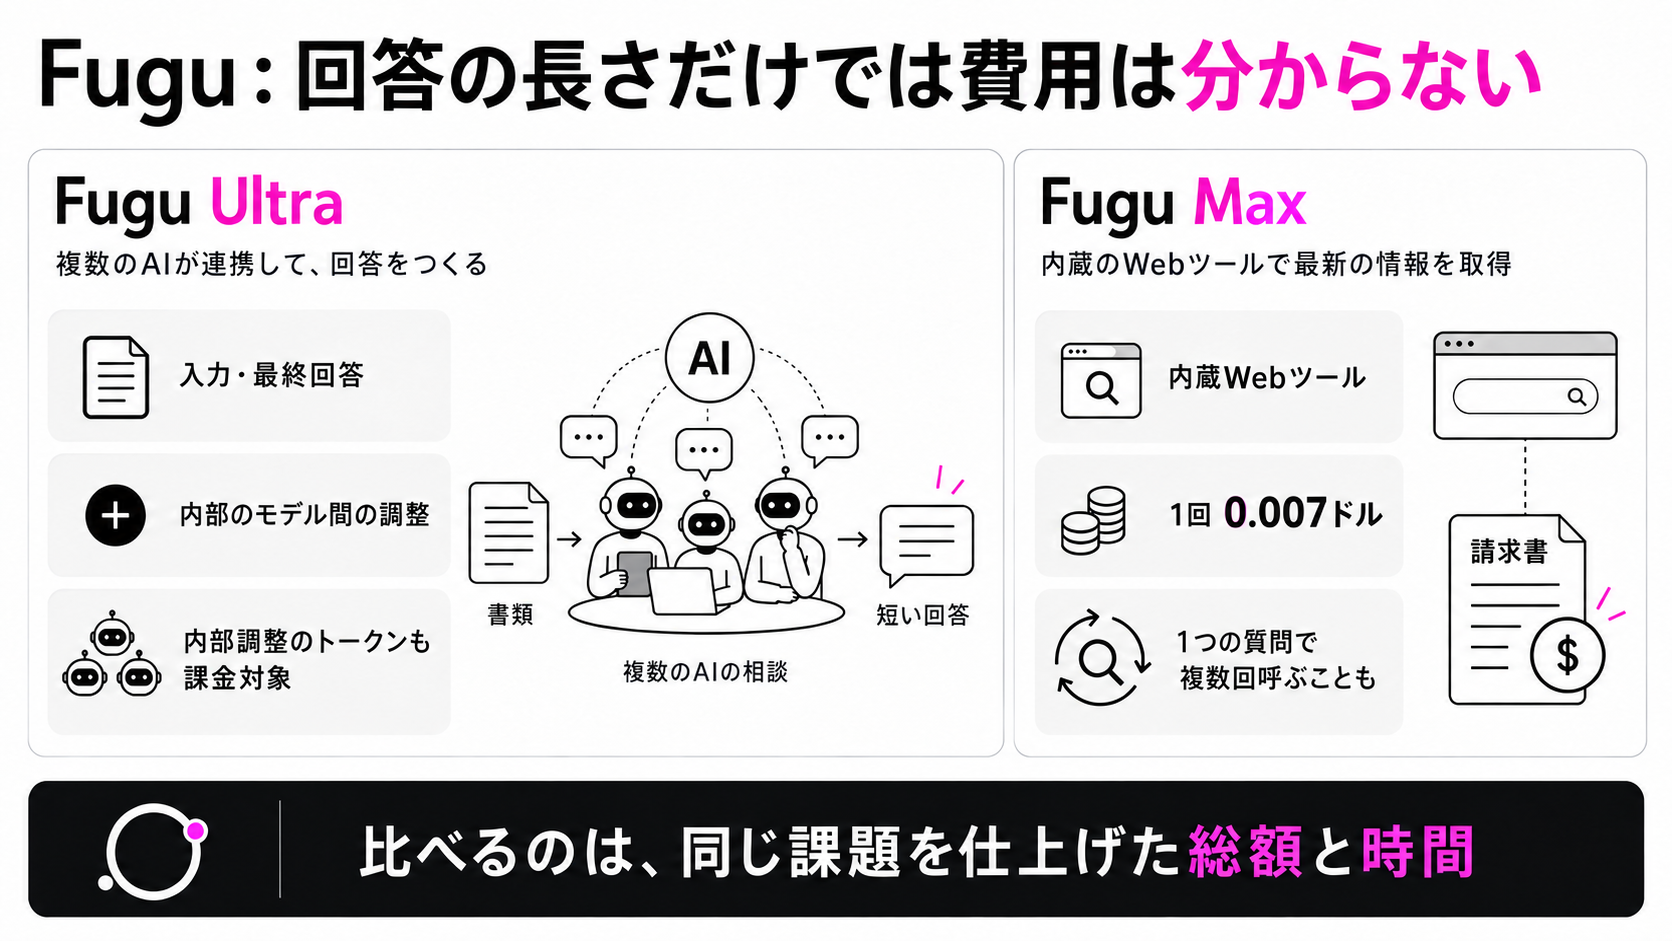
さらに、Ultraの課金対象には、利用者に見える入力と最終回答に加えて、内部のモデル間の調整で使ったトークンも含まれます。Maxの内蔵Webツールは1回0.007ドルで、一つの質問から複数回呼び出される場合があります。利用量の説明とツールの仕様
コメント:安い単価と、安く仕上がる仕事は同じではない
Maxの出力単価がUltra v2より低いことは料金表から分かります。しかし、同じ仕事を頼んだときの総額は、途中でどれだけ推論し、検索し、やり直したかによって変わります。たとえば、短い最終回答であっても、その前に複数のモデルが長く検討していれば、見た目の文字数から想像したより費用がかかる可能性があります。
Fuguの価値を判断する際は、同じ課題を必要な品質まで仕上げた総額と、完了までの時間を比較するのが適切です。複数のモデルを組み合わせることで一度で十分な答えが得られるなら、内部処理が増えても採用する理由があります。反対に、単純な課題で結果が変わらないなら、組み合わせるための追加処理が費用や待ち時間を増やすことも考えられます。
企業向けには、使われるモデルの範囲も選定条件です。公式仕様では、通常のFuguはモデル群から特定の提供元を外せますが、MaxとUltraは固定のモデル群を使い、個別構成の要望は問い合わせ扱いです。社内文書をどの事業者へ送れるかに制約がある場合は、性能の比較と同時に確認しておく必要があります。モデル構成の仕様
Link AIでは、AIサービスの選定から導入効果の検証までを支援するAIアセスメントを提供しています。自社の業務に合うモデルや評価方法を整理したい方は、お問い合わせください。