Claude Opus 5.5とGPT-6 Solが登場。主要モデルの性能・価格・利用条件
1. Claude Opus 5.5が登場。端末操作と科学研究では、競合との差が異なる
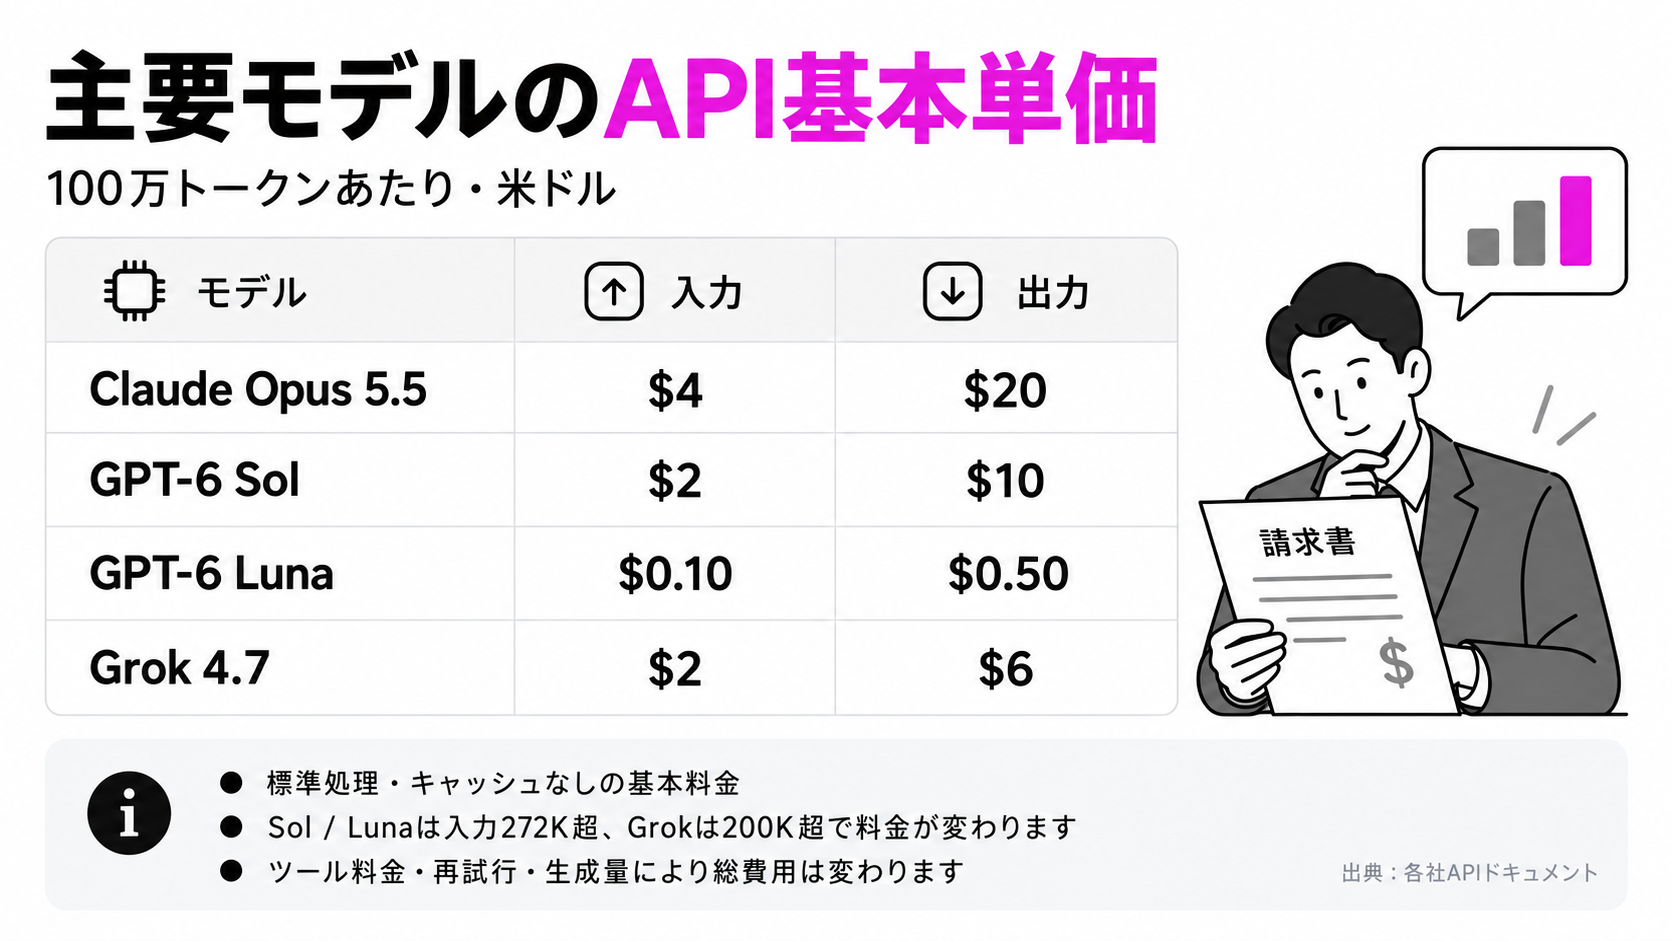
Anthropicは9月22日、Claude Opus 5.5を発表しました。長時間の開発作業や知識を扱う仕事を強化し、APIの基本単価も引き下げています。入力100万トークンあたり4ドル、出力は20ドルで、Opus 5の5ドル・25ドルからそれぞれ20%下がりました。トークンは、AIが文章を処理するときの課金単位です。公式発表
性能の伸びは、何を解かせるかによって違います。Anthropicが掲載した比較では、端末上で作業する能力を測るTerminal-Bench 4でOpus 5の52.3%から66.4%へ、科学研究課題のTerminal-Bench-Science 0.1では29.0%から58.7%へ上がっています。
| 評価 | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4:端末を使った課題 | 66.4% | 57.9% |
| Terminal-Bench-Science 0.1:科学研究課題 | 58.7% | 64.6% |
これはAnthropicがまとめた公表値です。Terminal-Bench 4ではOpus 5.5がxhigh、Astraがhighという異なる推論設定で、競合の数値も公開報告に基づきます。同じ実行環境で一斉に測った順位表ではありません。科学研究課題にはモデルごとに±3.5〜5ポイントの標準誤差も示されており、表の差だけで優劣を断定することはできません。また、Opus側の一部評価には、安全対策によって旧モデルへ処理を切り替える条件が含まれます。
コメント:能力の改善と、APIの移行作業を分けて考える
独立評価のArtificial Analysisでも、Opus 5.5はIntelligence Index v4.3.2で58を記録しています。ただし、こちらも最大推論設定と標準のモデル切替を含む評価です。複数の試験をまとめた指数なので、「すべての仕事で競合を上回る」とは読めません。Artificial Analysisの評価条件
端末操作では有力な更新であり、科学研究ではAstraが高い結果を残している。この違いを見れば、既存の開発支援で乗り換えを試す理由と、研究用途で引き続き競合を比較する理由が分かれます。
すでにClaude APIを組み込んでいる企業には、もう一つ確認事項があります。Opus 5.5は推論を無効にできず、従来の「特定ツールの使用を強制する設定」もエラーになります。モデル名だけを置き換える前に、その設定を使っている処理を確認する必要があります。性能向上の恩恵を受けるにも、呼び出し側が新しい仕様に対応していることが前提です。APIの変更点
2. GPT-6 Sol/Lunaは値下げ。Solの独立評価には伸びた項目と下がった項目がある
OpenAIも9月22日、GPT-6 SolとGPT-6 Lunaを発表しました。提供先はChatGPT Work、Codex、APIで、通常のChatへの提供は発表時点ではまだ始まっていません。Plus・Pro・Business・Enterprise・Eduで両モデルを利用でき、Free・GoではデスクトップアプリでLunaを利用できます。OpenAIの発表
APIの基本単価は、Solが入力100万トークンあたり2ドル・出力10ドル、Lunaが入力0.10ドル・出力0.50ドルです。Solは前世代のプロモーション価格から半額になりました。一方、入力が272Kトークンを超えるリクエストでは、入力料金などが2倍、出力料金が1.5倍になります。長い資料や会話履歴を渡す用途では、この条件も費用に影響します。Solの料金仕様、Lunaの料金仕様
コメント:Solは全面的な性能向上より、費用との釣り合いを見る
Artificial Analysisの独立評価では、Solの新旧をどちらもmax設定で比較できます。
| 評価項目 | GPT-5.6 Sol | GPT-6 Sol |
|---|---|---|
| Intelligence Index v4.3.2:総合指数 | 47 | 48 |
| Terminal-Bench 4.0:端末操作 | 40% | 44% |
| GDPval-AA v2.1:実務成果物の評価(Elo) | 1,588 | 1,487 |
| 指数に含まれる課題の加重平均費用 | 1.99ドル | 1.06ドル |
出典:Artificial Analysisの新旧比較。費用は同社の評価課題における値で、自社業務の見積額ではありません。Eloは成果物を比較するための相対評価で、正答率とは異なります。
総合指数は小幅に上がり、評価にかかる費用は下がっています。その一方で、実務成果物を比べるGDPval-AAは低下しました。ここから読めるのは、同程度の費用で回せる試行を増やしやすくなったことです。文章や資料の完成度まで一律に向上したとは言えません。これまでSolに任せていた資料作成では、料金だけでなく、必須項目の抜けや納品物の仕上がりも新旧で比べる意味があります。
先行利用者の比較にも、評価軸による違いが出ています。開発者のmarvijo-software氏は、小規模なWebアプリ5本を両モデルに作らせ、Solは合計43分、Opus 5.5は77分で、デザインは5本中4本でOpusを高く評価したと報告しました。ただしSolはCodex、OpusはClaude Codeで動かした個人の試行です。モデル単体の速度差として一般化はできませんが、完成までの時間と見た目の質を別々に見る比較例として参考になります。本人による試行報告
3. Grok 4.7は単価据え置き。独立評価では、1課題あたりの費用が増えた
9月21日に発表されたGrok 4.7は、開発作業やエージェントによる長い課題の処理を強化したモデルです。xAIは基盤モデルの大型化と、難しい課題を使った強化学習の拡充を説明しています。公式発表
APIはテキスト・画像の入力とテキスト出力に対応し、文脈の上限は500Kトークンです。基本単価はGrok 4.6と同じ入力2ドル・出力6ドルですが、入力が200Kトークンを超える場合は4ドル・12ドルになります。高速版のGrok 4.7 FastはCursorとGrok Build向けで、公開APIでは利用できません。提供条件と料金
コメント:「同じ単価」は「同じ請求額」を意味しない
Artificial AnalysisのIntelligence Index v4.3.2では、どちらもxhigh設定でGrok 4.6が44、Grok 4.7が46でした。一方、評価課題の加重平均費用は2.32ドルから3.74ドルへ増えています。トークンあたりの料金が同じでも、一つの課題を処理する費用は同じになりません。Grok 4.6の評価、Grok 4.7の評価
この結果は、4.7への更新に価値がないという意味ではありません。従来失敗していた課題を最後まで解けるなら、費用の増加を受け入れる理由があります。反対に、4.6で十分に処理できていた定型作業では、増えた費用に見合う改善があるかを確かめたいところです。Grokの更新では、基本料金の据え置きよりも「同じ依頼を完了するまでにいくら使うか」が判断を左右します。
4. Xiaomi MiMo-V2.6が公開。約6日間の強化学習による改善を報告
Xiaomiは9月22日、MiMo-V2.6のProとFlashを公開しました。APIのほか、モデルの重みや技術報告、強化学習の研究用リソースも公開しています。公式発表では、API価格をV2.5から据え置いたとしています。Xiaomiの発表
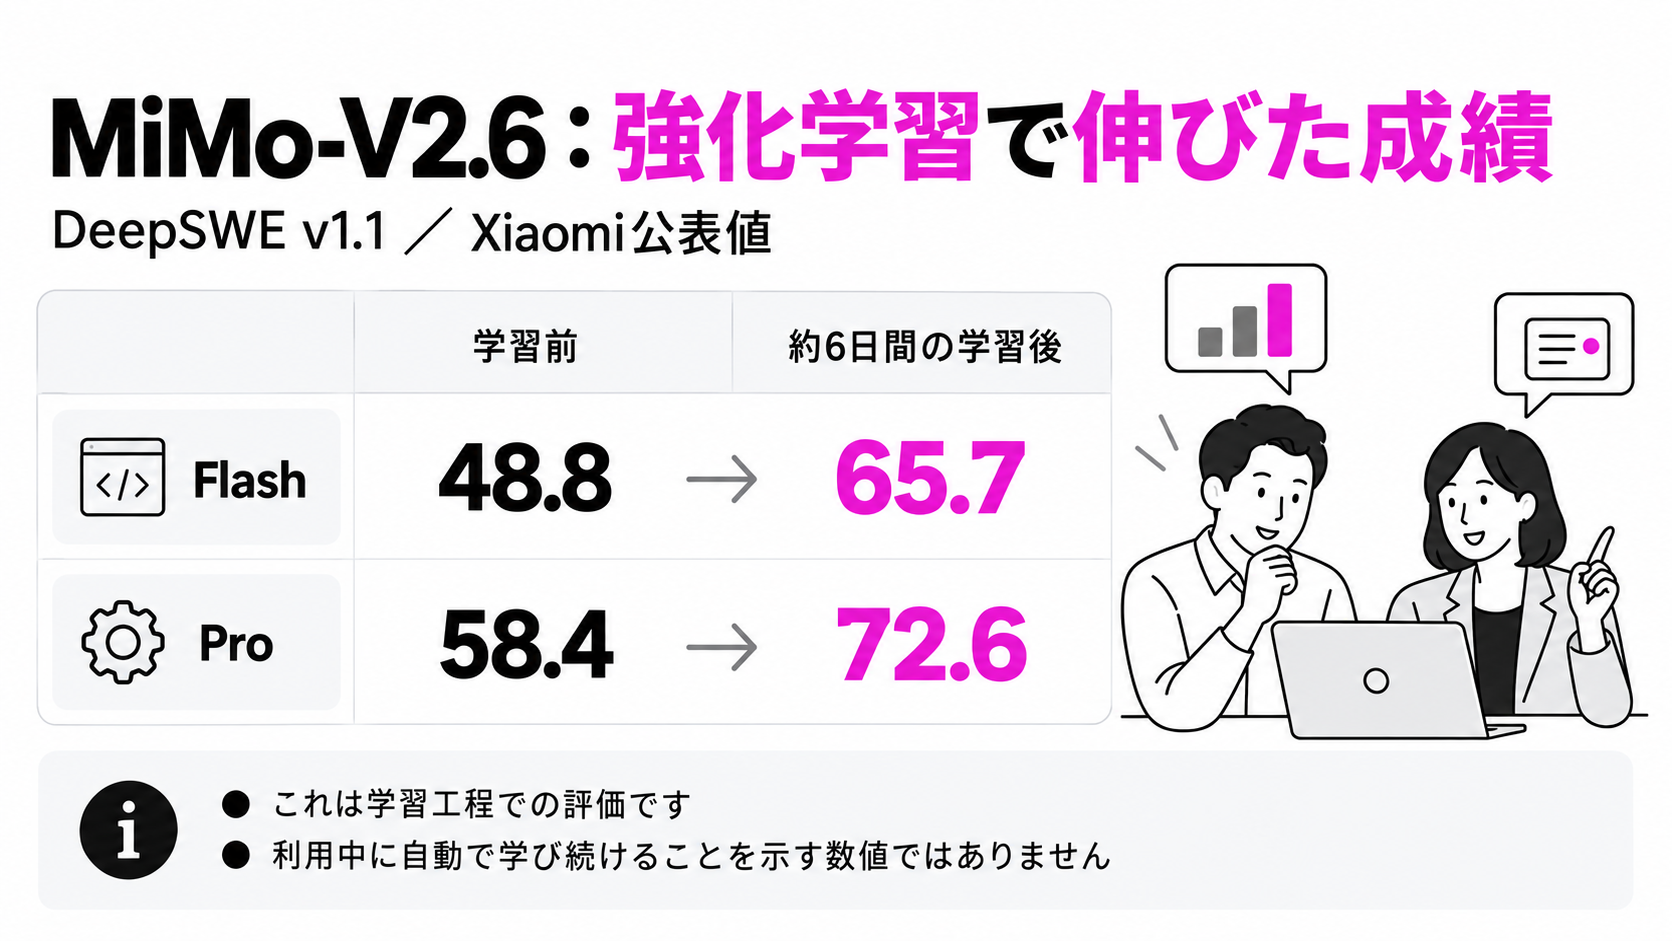
発表の特徴は、最終スコアだけでなく、学習工程でどれほど伸びたかを示している点です。Xiaomiによると、約6日間の強化学習を経て、ソフトウェア開発課題のDeepSWE v1.1はFlashが48.8から65.7、Proが58.4から72.6へ改善しました。これは同社による学習前後の評価であり、他社モデルと同じ条件で測定した結果ではありません。
コメント:低価格で試せる能力と、サービスとしての安定性は別に確かめる
独立評価のArtificial Analysisでも、ProはIntelligence Index v4.3.2で46を記録しました。同じ版の総合指数ではGrok 4.7と並び、評価課題の加重平均費用は0.13ドルでした。ただし、各社の推論設定や処理経路は異なります。特定の仕事で同じ品質になることを保証する数値ではなく、低価格帯で比較対象に加える根拠と捉えるのが妥当です。MiMo-V2.6-Proの独立評価
利用時の問題も報告されています。Kilo CLI 7.7.7を使った投稿者は、Pythonの実装課題でMiMoがタイムアウトし、コードを得られなかったと報告しました。投稿者自身も、モデルの開発能力を否定する証拠ではなく、その接続環境で起きた問題だと区別しています。利用者の報告
費用と性能が魅力的でも、採用するサービス経由で安定して回答が返ることは別の条件です。また、今回公表された強化学習の成果を、導入後にAIが自動で学び続ける機能と読み替えることもできません。MiMoの発表は、学習方法の改善と価格競争力に注目するニュースとして読むと、その価値がはっきりします。
5. Qwen-Image-2.1は透明画像の生成・編集を統合。商用利用は別契約が必要
Qwenチームは9月20日、画像生成と編集を一つにまとめたQwen-Image-2.1を公開しました。背景が透明な画像を直接生成し、その透明部分を保った編集や、写真からの被写体の切り出しに対応します。参照画像は最大10枚です。公式発表
透明画像を扱う機能自体は、2025年12月のQwen-Image-Layeredにもありました。今回の変化は、その機能を通常の画像生成・編集と同じモデルで扱えるようにしたことです。商品画像などを複数参照しながら、背景のない素材を作る用途では、機能ごとに別モデルを選ぶ手間が減る可能性があります。
コメント:公開された重みを、自社の制作業務で使えるとは限らない
モデルの重みはダウンロードできますが、付属するQwen RESEARCH LICENSEは研究・評価目的の非商用利用に限り、商用利用には別のライセンス取得を求めています。「公開モデルだから、そのまま広告制作や有料サービスに使える」とは判断できません。公開ライセンス
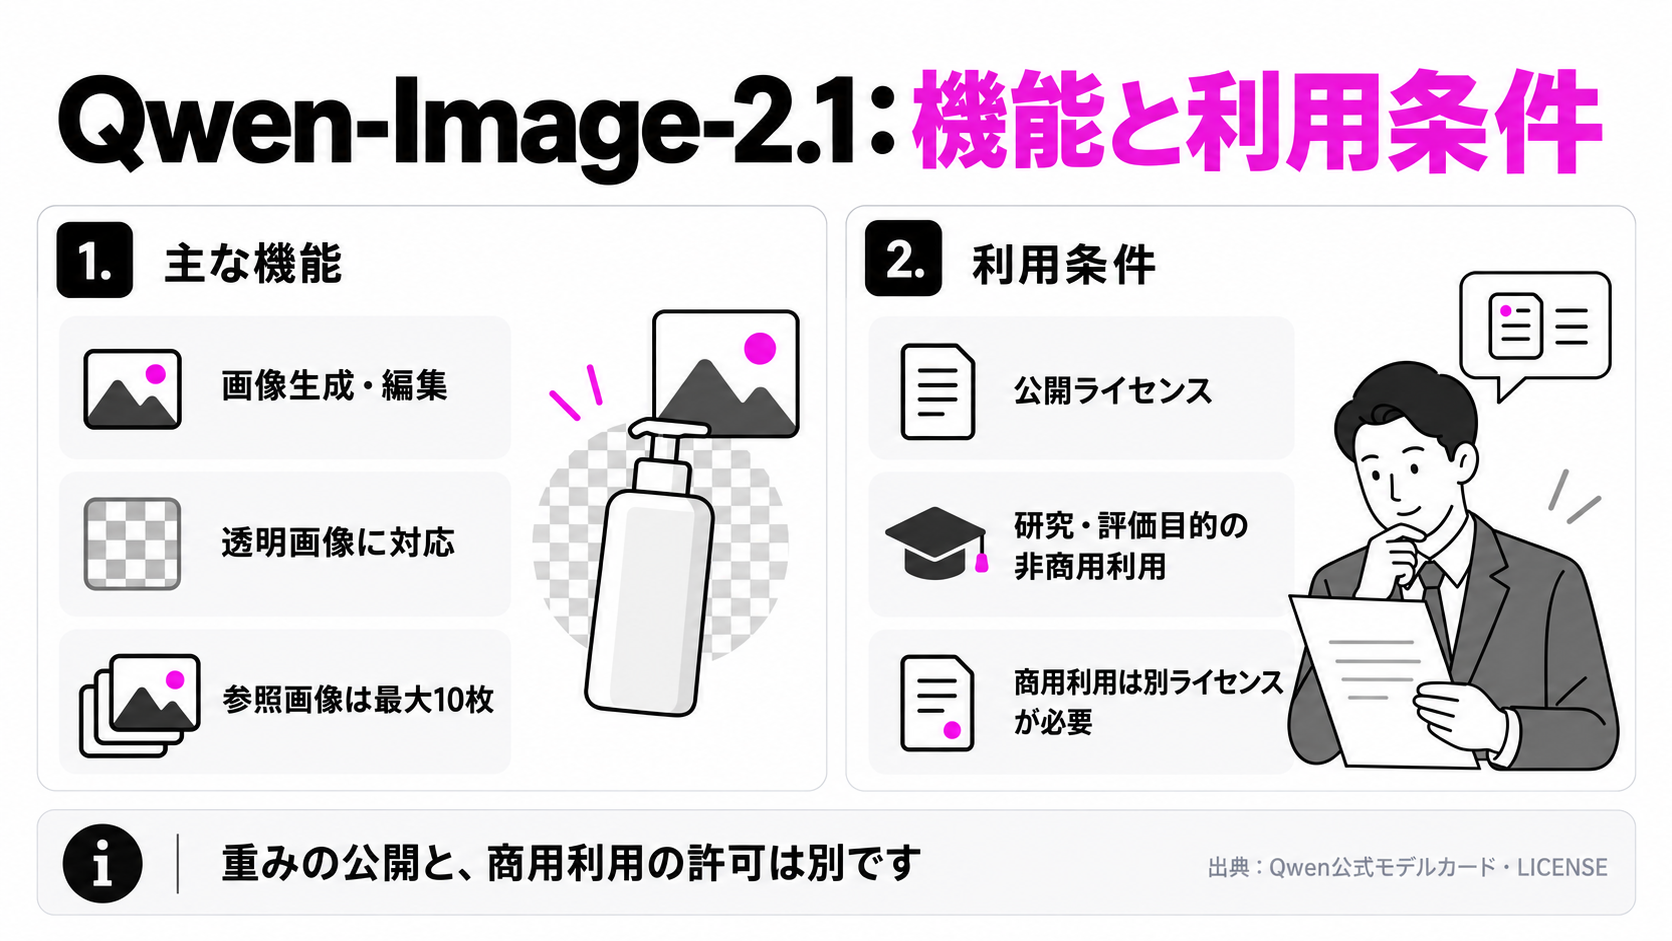
また、公表されている7Bという規模は画像生成部分のパラメータ数です。システム全体が7Bで、必ず小さなGPUに収まるという意味ではありません。モデルの仕様
先行利用者のlistopalafoto氏は、ModelScope APIで10枚の参照画像を試し、編集の精度を評価する一方、コントラストが強すぎる画像や肌の赤みも課題に挙げています。個人の作例であり、他モデルに対する優位性を示す統一試験ではありません。本人の作例と所感
導入を検討するなら、まず欲しいのが「透明素材を一つのモデルで生成・編集できること」なのかを整理し、そのうえで商用条件と実行環境を確認する順番が合理的です。公開直後の作例だけで、画像品質や制作費が既存サービスを上回るとまでは判断できません。
Link AIでは、AI活用に向けた業務整理や検証計画づくりを支援するAIアセスメントを提供しています。自社の業務に合う性能・費用・運用条件を整理したい方は、お問い合わせください。