FLUX 3 Imageの配置・部分修正、ELYZA新モデルの性能差、Harveyの日本法情報連携
1. FLUX 3 Imageは、画像の「どこを変えるか」を細かく指定できる
Black Forest Labs(BFL)は10月1日、画像生成・編集モデル「FLUX 3 Image」を公開しました。文章からの画像生成、既存画像の部分修正、最大10枚の参照画像を使った制作に対応し、公式のPlaygroundとAPIから利用できます。製品ページ
今回注目したいのは、画像の中に枠を指定し、文字や人物、商品などの配置を指示できる点です。たとえば、見出しを置く場所と商品を置く場所を分けて伝えられます。またBFLは、変更する要素を指定すれば、周囲を保ったまま色の変更、置き換え、移動、削除などを行えると説明しています。公式リリースノート
画像生成や部分修正そのものは、すでに他の製品でもできることです。FLUX 3 Imageを見る際も、「初めて広告を作れるようになった」と捉えるより、意図した場所に要素を置き、修正時に残したい部分をどこまで維持できるかに注目すると、違いを判断しやすくなります。
先行利用では、配置を改善できた一方、枠の大きさが結果に影響
画像編集ソフトScumbleの開発者は、10月2日付の開発ブログで、FLUX 3 Imageを使った5回の実編集を報告しています。草地に猫を追加する例では、枠を指定しないと選択範囲の端にはみ出した猫が、枠を指定すると中央に収まりました。参照画像の時計を壁に置く例でも、枠を使うと時計がその範囲を満たす大きさで配置されたといいます。
ただし、「小さな猫」と頼んでも、猫が枠いっぱいの大きさになったとも記しています。位置だけでなく、置きたい物の大きさに合わせて枠を描く必要があるという指摘です。Scumble開発ブログ
これはBFL自身のデモとは別の利用報告ですが、連携ソフトの開発者による少数の試行です。競合モデルを同じ条件で比較した試験ではなく、常に狙い通りの位置や大きさになることを保証するものでもありません。
コメント:完成した1枚より、修正を重ねたときの安定性を見る
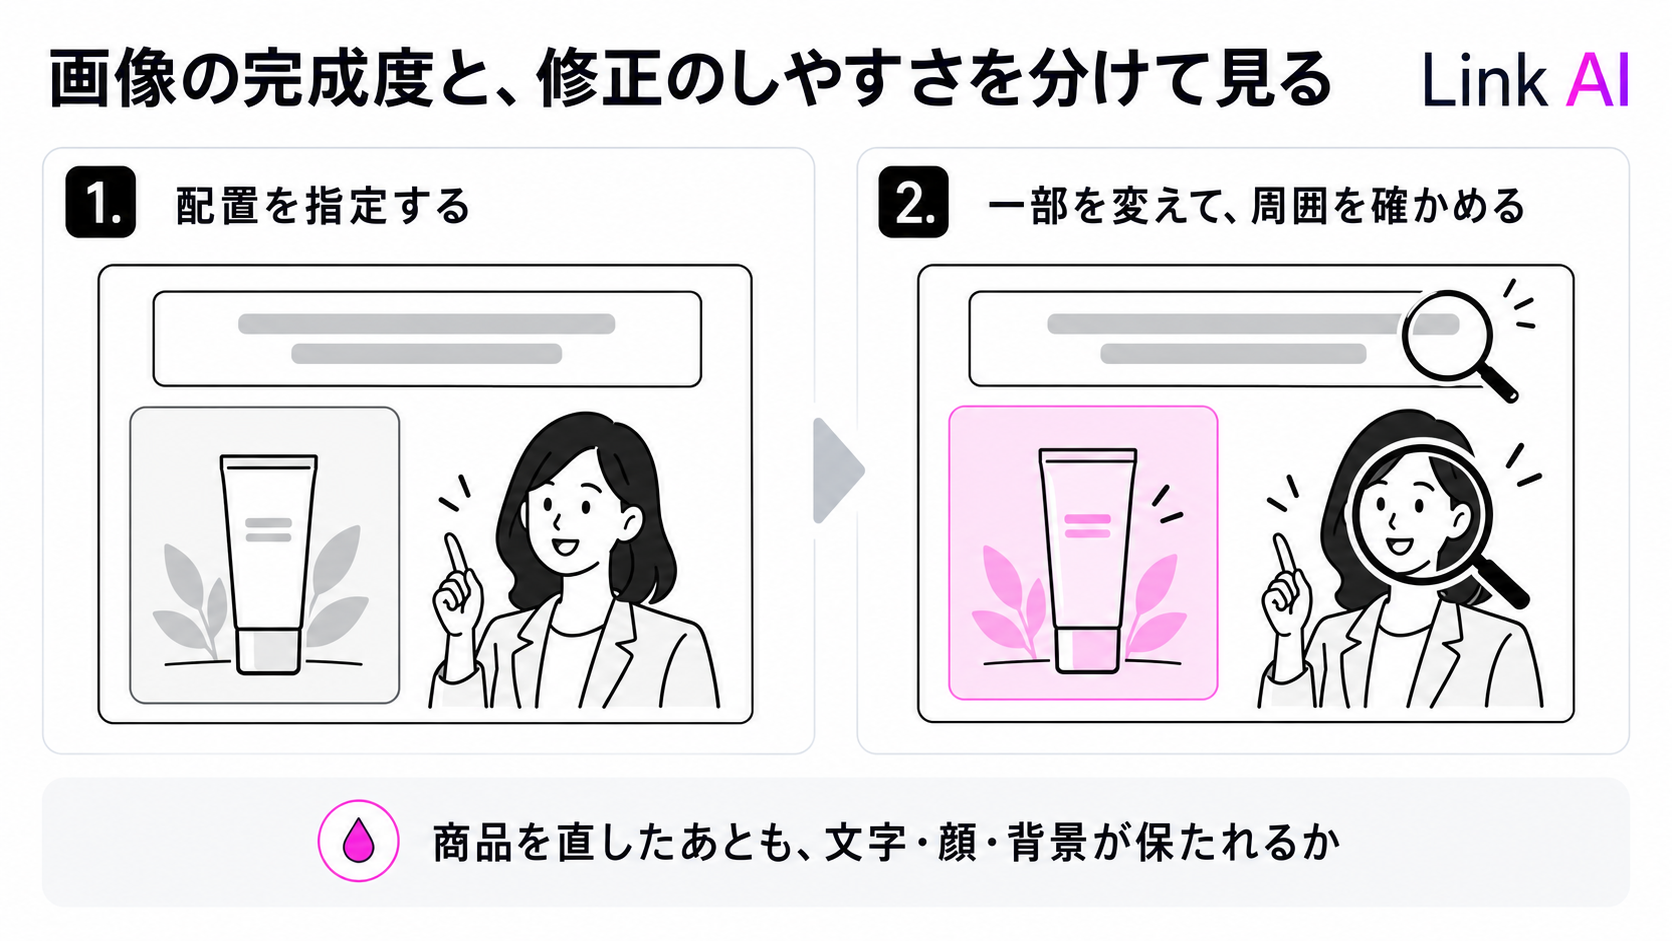
広告や商品画像では、最初の案がよくできていても、その後に価格、商品、配色などの変更が入ります。商品だけを直したつもりで、確認済みの見出しや人物の顔まで変われば、そこをもう一度確認しなければなりません。
そのため、FLUX 3 Imageの編集機能を評価するなら、見栄えに加えて、変更したい部分が直ったか、残すはずの部分が保たれたかを一緒に見る必要があります。先ほどの猫の例も、絵の品質より「意図した範囲に収まるか」という制作上の条件が結果を左右しています。
費用にも解像度による差があります。公式リリースノートの通常料金は1Kが1枚0.048ドル、2Kが0.100ドル、4Kが0.607ドルです。一方、現在の公式料金表では、1Kに0.024ドルの割引価格が表示されています。通常料金と割引価格を分け、実際に使う解像度で確認する必要があります。公式料金表
修正を繰り返す用途では、1回の生成単価だけでなく、採用できる状態になるまでの再生成回数も費用に影響します。枠による指定がその回数を減らすのかは、自社の素材で確かめたい点です。
2. ELYZAが国産モデルを公開。日本語の知識問題とツール操作で結果が分かれる
ELYZAは10月2日、「ELYZA RSI Research」の設立とともに、「ELYZA-Thinking-1.0-llm-jp-4-33b」と「ELYZA-Thinking-1.0-llm-jp-4-32b-a3b」を公開しました。国立情報学研究所のLLM-jp-4を基に追加学習したモデルで、モデルカードではApache 2.0ライセンスを掲げています。ELYZAの発表、33Bモデル、32B-A3Bモデル
公開された評価からは、日本語の知識や指示への対応で改善が見られる一方、ツール操作では別のモデルが上回る様子も読み取れます。「国産だから高性能」と一括りにせず、用途ごとの違いを見ることが大切です。
33Bモデルの公表値を、LLM-jp-4.1やQwenと並べる
以下は、ELYZAが33Bモデルのモデルカードに掲載した値です。すべて数値が高い方がよい指標ですが、それぞれ測る能力が異なります。
| 評価項目 | ELYZA Thinking 33B | LLM-jp-4.1 33B Thinking | Qwen3.5-27B |
|---|---|---|---|
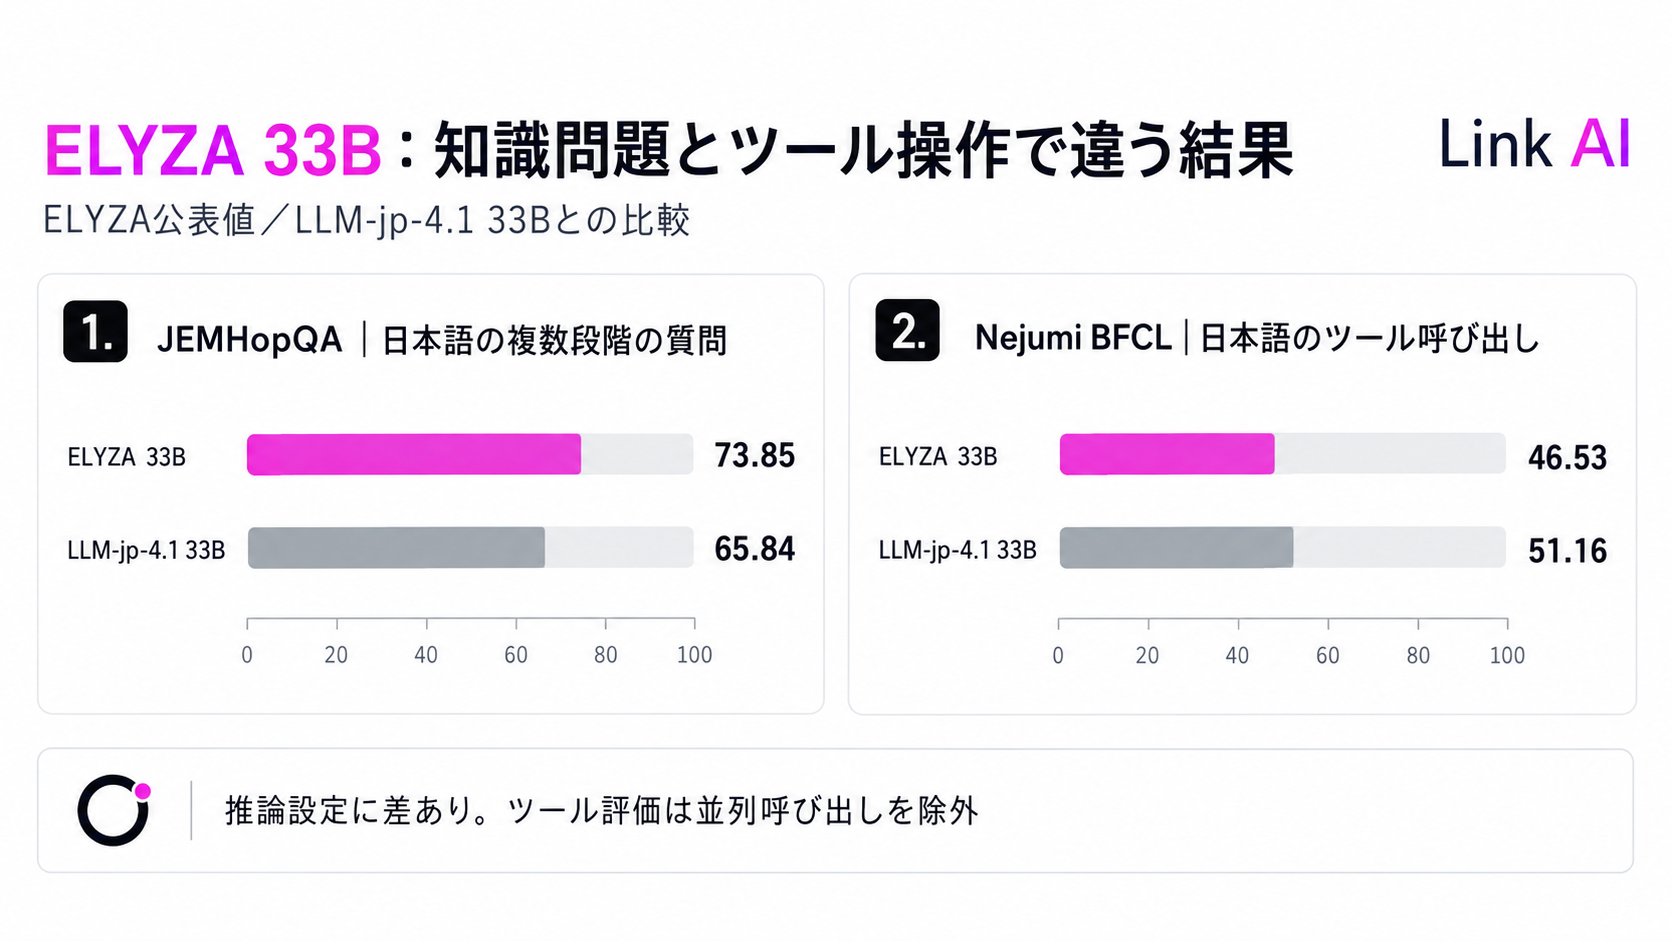
| JEMHopQA:日本語の複数段階の質問応答 | 73.85 | 65.84 | 62.87 |
| JFBench:日本語の指示への対応 | 39.02 | 32.79 | 34.12 |
| Nejumi BFCL:日本語でのツール呼び出し | 46.53 | 51.16 | 59.65 |
| 7分野の平均スコア | 61.69 | 60.64 | 68.18 |
出典:ELYZAの33Bモデルカード。ELYZAによる評価であり、第三者の追試ではありません。7分野の平均は、各分野内の平均を計算してから分野間で平均した値です。
LLM-jp-4.1との比較では、JEMHopQAとJFBenchでELYZAが上回っています。一方、Nejumi BFCLではLLM-jp-4.1が上で、Qwen3.5-27Bはさらに高い値です。全体の平均でも、このQwenモデルが上回っています。
評価条件にも留意が必要です。ツール呼び出しの評価からは並列呼び出しが除外されています。また、LLM-jp側は推論設定をhighにしている一方、ELYZAモデルには同じ設定項目がありません。生成できる最大トークン数なども完全に統一された比較ではないため、同じ計算量での優劣や処理速度まで、この表から判断することはできません。
コメント:日本語でよく答えられることと、操作を正しく選べることは別
日本語の質問に適切に答える用途と、必要なツールを選んで引数を渡す用途では、求められる能力が異なります。今回の公表値は、その差を具体的に示しています。
たとえば、社内文書への質問応答を検討する場合には、日本語の理解や指示への対応が判断材料になります。ただし、検索した文書を根拠に正しく答えられるかは、これらのベンチマークだけでは分かりません。自社の文書と質問を使って確認する必要があります。さらに、回答に続いて業務システムを操作させるのであれば、ツールの選択と引数の正確さを別に評価することになります。
モデルの重みを入手できることも、この発表の特徴です。自社環境での運用を検討できますが、必要な設備や実行速度、運用費まで無料になるわけではありません。今回の発表だけでは、こうした費用対効果の比較はできません。
なお、発表にある「1〜2人日」は、整備済みの社内学習基盤を使い、追加学習から評価までを進める際に人が介在した作業量です。基盤モデル全体をゼロからその工数で作ったという意味ではなく、ELYZAも再帰的自己改善そのものを実現したわけではないと説明しています。この区別を踏まえると、今回の成果は、モデルの公開と、追加学習・評価にかかる人の作業を減らす取り組みとして理解できます。
3. HarveyとLegalscapeが提携。日本法情報の連携は2027年初頭以降を予定
Legalscapeは10月2日、リーガルAIのHarveyとの提携を発表しました。Harveyで日本法について質問すると、Legalscapeの「Legal Intelligence」が法令・判例・ガイドラインなどの公開情報と、出版社の許諾を得た書籍等を参照し、要約と参照元を提示する仕組みです。提供開始は2027年初頭以降の予定で、国内のHarveyユーザーにも順次提供するとしています。Legalscapeの発表
Harvey側も、日本法の情報を、社内の先例やほかのデータと並べて調べられる点を説明しています。海外の法務チームが日本に関わる案件を扱う場合や、Harveyを使う国内の組織にとって、参照できる情報の範囲に関わる発表です。Harveyの発表
コメント:流暢な回答に加えて、何を読めるAIなのかを確かめる
この連携の特徴は、日本語で回答できることだけではありません。公開されている法令や判例に加えて、許諾を得た法律書籍の解説や実務知見を、普段使うAIから参照できるようにする点にあります。
法律分野に限らず、専門業務でAIを選ぶ際は、モデルの回答能力と、アクセスできる資料の範囲が両方とも結果に影響します。書籍や社内資料が判断の根拠になる業務では、文章が自然でも、必要な資料を参照できなければ調査の範囲が限られます。
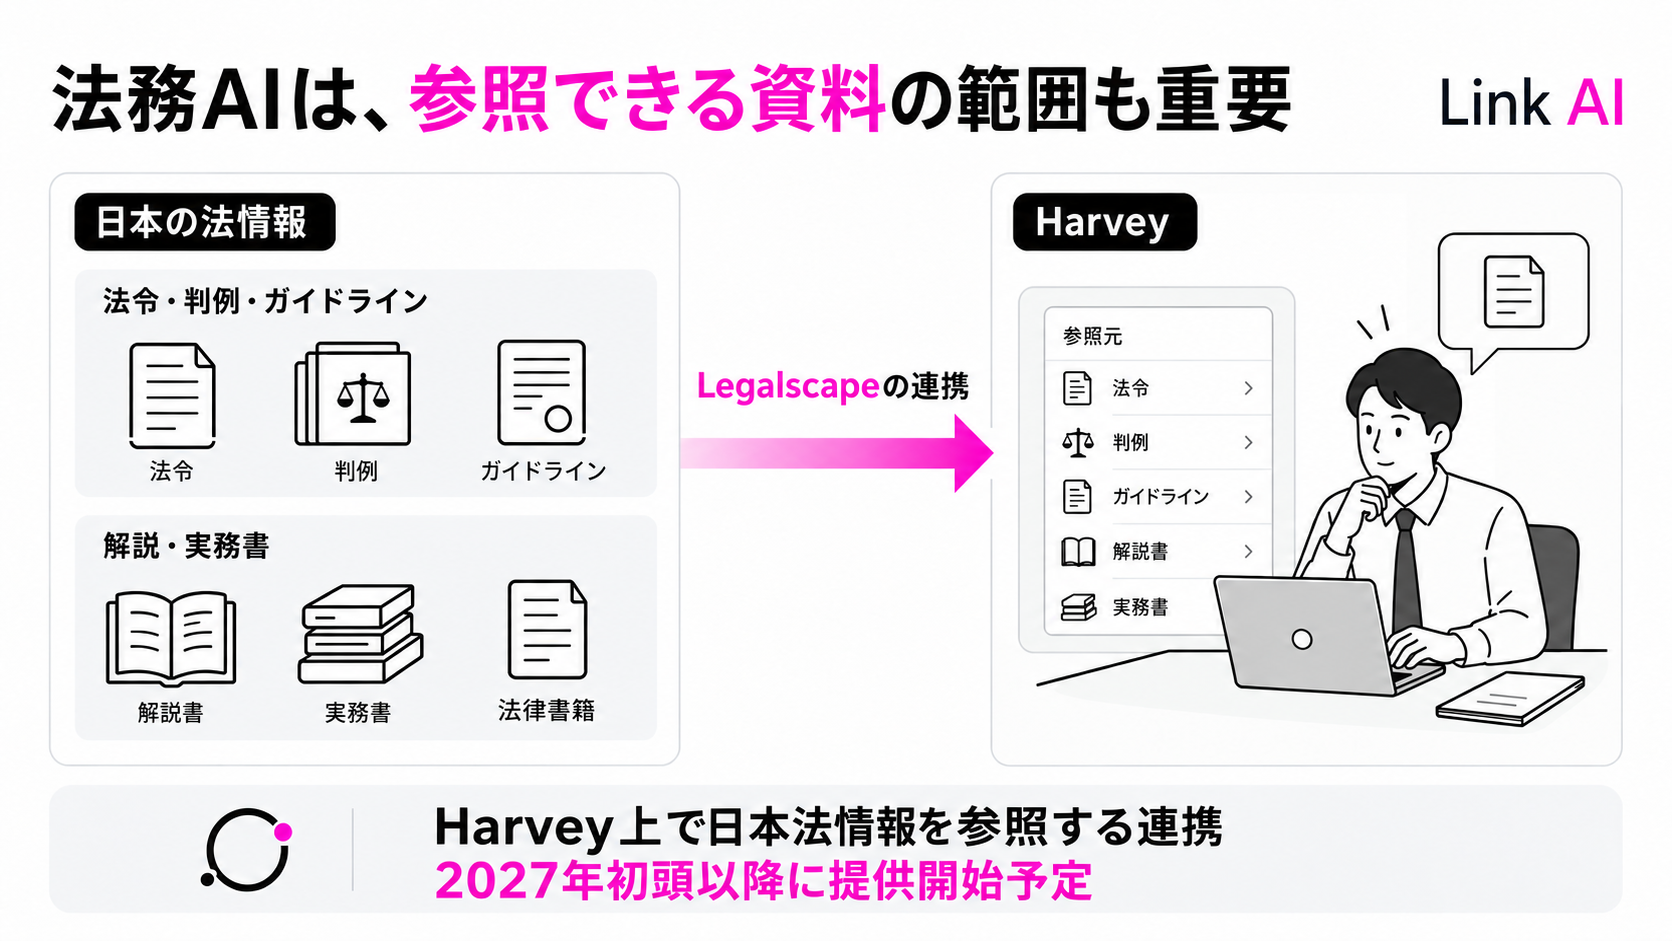
導入を検討するなら、自社が必要とする書籍や情報が対象に含まれるか、参照元をどこまで確認できるかを具体的に確かめたいところです。今回の発表では、料金、契約ごとの収録範囲、調査精度や所要時間の改善を示す実測値までは示されていません。情報へのアクセスが広がる計画と、実務で得られる成果は分けて判断する必要があります。
Link AIでは、企業の生成AI活用に向けた業務整理や導入効果の検証を支援するAIアセスメントを提供しています。自社で比較すべき性能や、必要なデータ連携の整理については、こちらからご相談ください。