DGX Sparkに64GB版、Supabaseは開発環境とMCPを更新――仕様と提供条件を読む
1. NVIDIAがDGX Sparkの64GB版を発表。容量を減らした構成は、誰に向くのか
NVIDIAは10月2日、卓上型AI開発機「DGX Spark」に64GBメモリの構成を追加すると発表しました。Acer、ASUS、Dellなどのパートナーから10月23日に提供を始める予定で、発表価格は4,999ドルからです。日本での販売価格や納期は別途確認が必要です。NVIDIAの発表
従来の128GB版と同じGB10 Grace Blackwellを搭載し、DGX OSとNVIDIAのAIソフトウェア環境を使います。新世代のチップに置き換える更新ではなく、必要なメモリ容量に応じて構成を選べるようにする変更です。
公式仕様では、64GB版で最大1,000億、128GB版で最大2,000億パラメータのモデルを扱えるとしています。ただし、これはメーカーが示す対応規模であり、その大きさのモデルがどんな条件でも快適に動くという保証ではありません。
| 比較項目 | 新しい64GB版 | 既存の128GB版 |
|---|---|---|
| チップ | GB10 Grace Blackwell | GB10 Grace Blackwell |
| CPUとGPUで共有するメモリ | 64GB | 128GB |
| 公表メモリ帯域幅 | 273GB/秒 | 273GB/秒 |
| メーカーが示すモデル規模の上限 | 最大1,000億パラメータ | 最大2,000億パラメータ |
| 提供状況 | 10月23日からパートナー経由で提供予定 | 提供済み |
メモリ容量は「どれだけ載るか」、帯域幅は「どれだけ速くデータを運べるか」に関係します。容量が半分になったから処理速度も半分になる、と表だけから判断することはできません。反対に、チップが同じでも、使いたいモデルや作業データが収まらなければ、同じ条件での実行は難しくなります。
コメント:「最大1,000億パラメータ」より、実際に使う条件を見る
モデルの大きさから必要メモリを考えるときは、学習済みの数値である「重み」を、どの精度で保存するかが出発点になります。数値を少ないビット数で表す量子化によってメモリを節約できますが、使える方式はモデルや実行ソフトウェアによって異なります。NVIDIAの量子化ドキュメント
たとえば、1,000億個の重みをすべて4ビットで保存すると、重みだけの単純計算で約50GBになります。これは追加の管理情報を含まない概算です。さらに、文章を処理する途中の計算結果を保持する領域や、計算用の作業領域も必要になります。NVIDIAのメモリ使用量の解説でも、重み以外にこうした領域が必要で、入力の長さや同時処理数などが使用量に影響すると説明されています。
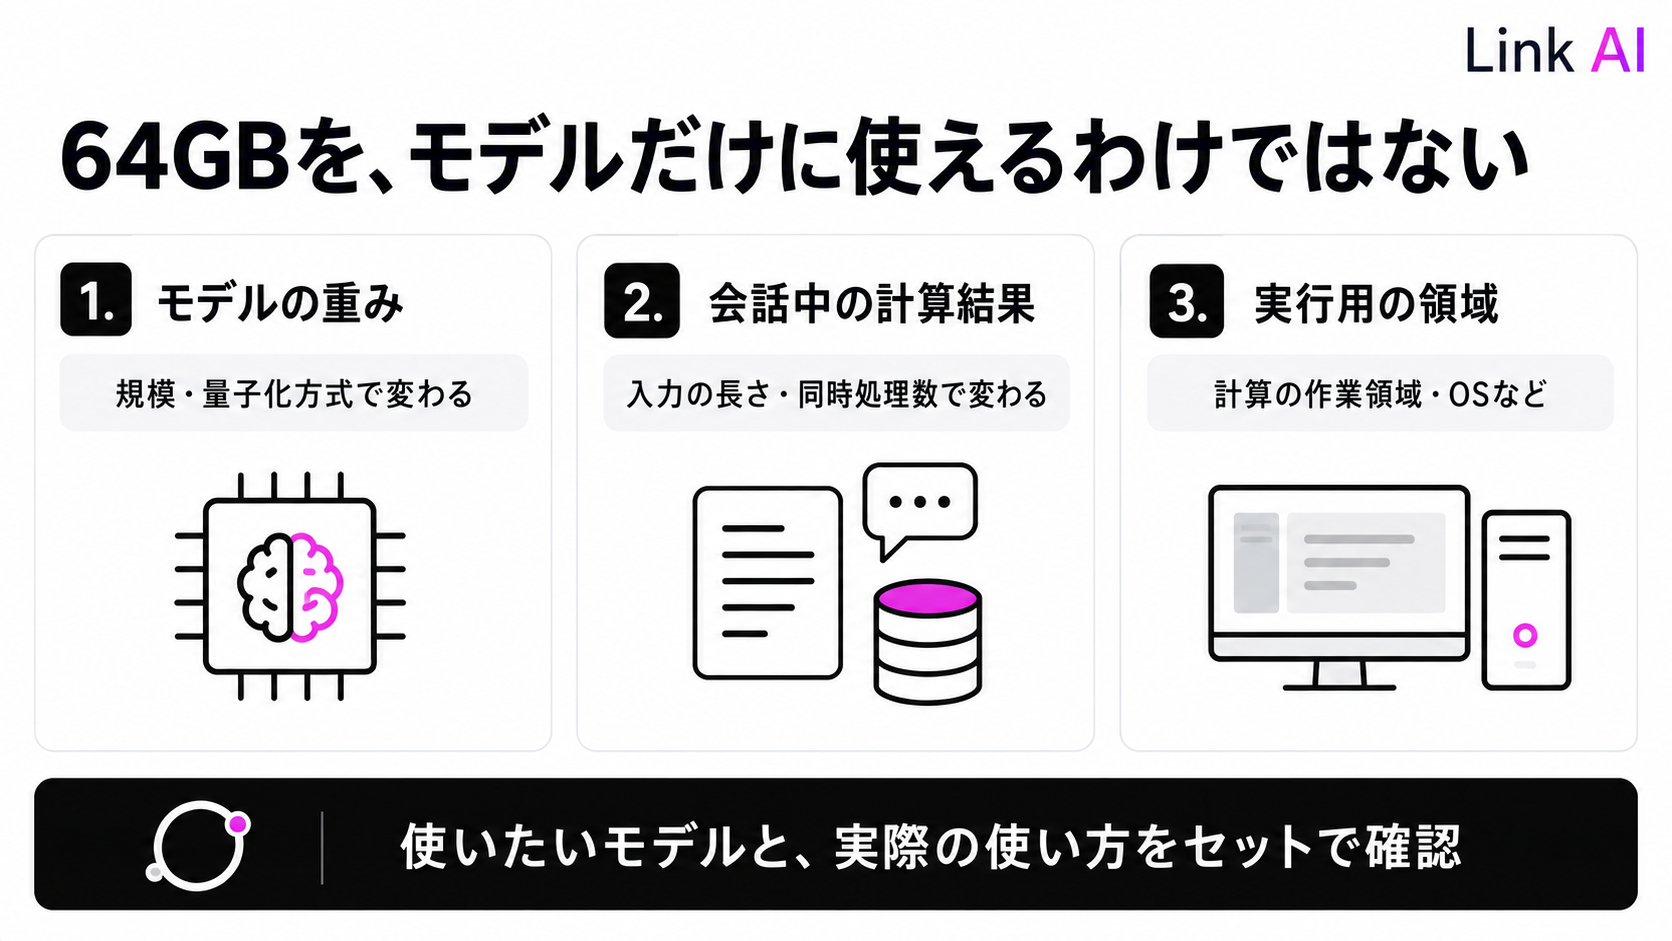
つまり、短い質問を1人で試す場合と、長い資料を複数人が同時に読み込ませる場合では、同じモデルでも必要な余裕が違います。64GB版を検討するなら、モデル名だけでなく、入力する資料の長さ、同時利用人数、許容できる待ち時間まで決めて比較する必要があります。
NVIDIAは64GB版を2台つないで合計128GBとする構成も案内しています。ただし、64GBを2台買うことと、128GBを1台買うことは、費用も構成も同じではありません。発表された開始価格を単純に2倍すると9,998ドルになります。メモリ容量の合計だけで有利と判断せず、接続や分散実行を含む構成で性能を確かめたいところです。
第三者評価についても区別が必要です。実機テストを行うStorageReviewの比較記事は、従来の128GB版を評価したうえで64GB版の発表を追記していますが、新しい2台構成に対するメーカーの性能主張は未検証と明記しています。既存機への高評価を、そのまま新構成の実力や割安さの証明にはできません。
今回増えたのは、NVIDIAの開発環境を使いながら、必要容量に合わせて機器を選ぶ余地です。64GBで足りる用途を明確にできる企業にとっては比較対象になりますが、大きなモデルや長い文書を扱う予定があるなら、価格と同時にメモリの余裕を検討することが大切です。
2. Supabaseが開発環境とMCPを更新。「AIで作る」と「AIから使う」の両方を整備
Supabaseは10月2日、イベント「Supabase Select」で、AIエージェントによるアプリ開発と、利用者のAIによるアプリ操作を支える機能を発表しました。Supabaseは、アプリに必要なデータベースやログイン認証などをまとめて提供するサービスです。Supabaseの発表
開発側の変更では、データベースの構造や認証などの設定を、ソースコードと同じ場所に置いて扱いやすくしました。「Declarative Schemas 2.0」は、SQLファイルに書いたデータ構造との差分から、変更を適用するための処理を生成します。Dockerを使わずにローカル環境を起動する仕組みも加わりますが、こちらはアルファ段階で、初期設定では無効です。
AIは以前からコードを書けました。しかし、管理画面で変更した設定がコード側に反映されていないと、AIが見ている状態と実際の環境がずれてしまいます。今回の変更は、設定も含めて確認・変更しやすくするものです。生成された変更が正しいかを確認する工程まで不要になるわけではありません。
コメント:アプリを作るAIと、利用者の代わりに操作するAIは別に考える
もう一つの発表が、自社アプリにMCPサーバーを追加するための部品です。MCPは、AIが外部のツールやデータに接続するための共通の仕組みを指します。
Supabaseにはすでに開発者向けのMCPがありますが、今回の部品は、ログインした利用者の権限で、その人のアプリを操作するためのものです。公式ドキュメントでは、利用者の認証情報を検証し、ユーザーごとに扱えるデータの行を制限するRLSの仕組みを利用すると説明しています。外部のMCPクライアントはOAuthで接続し、利用者が個別に許可・取り消しを行います。
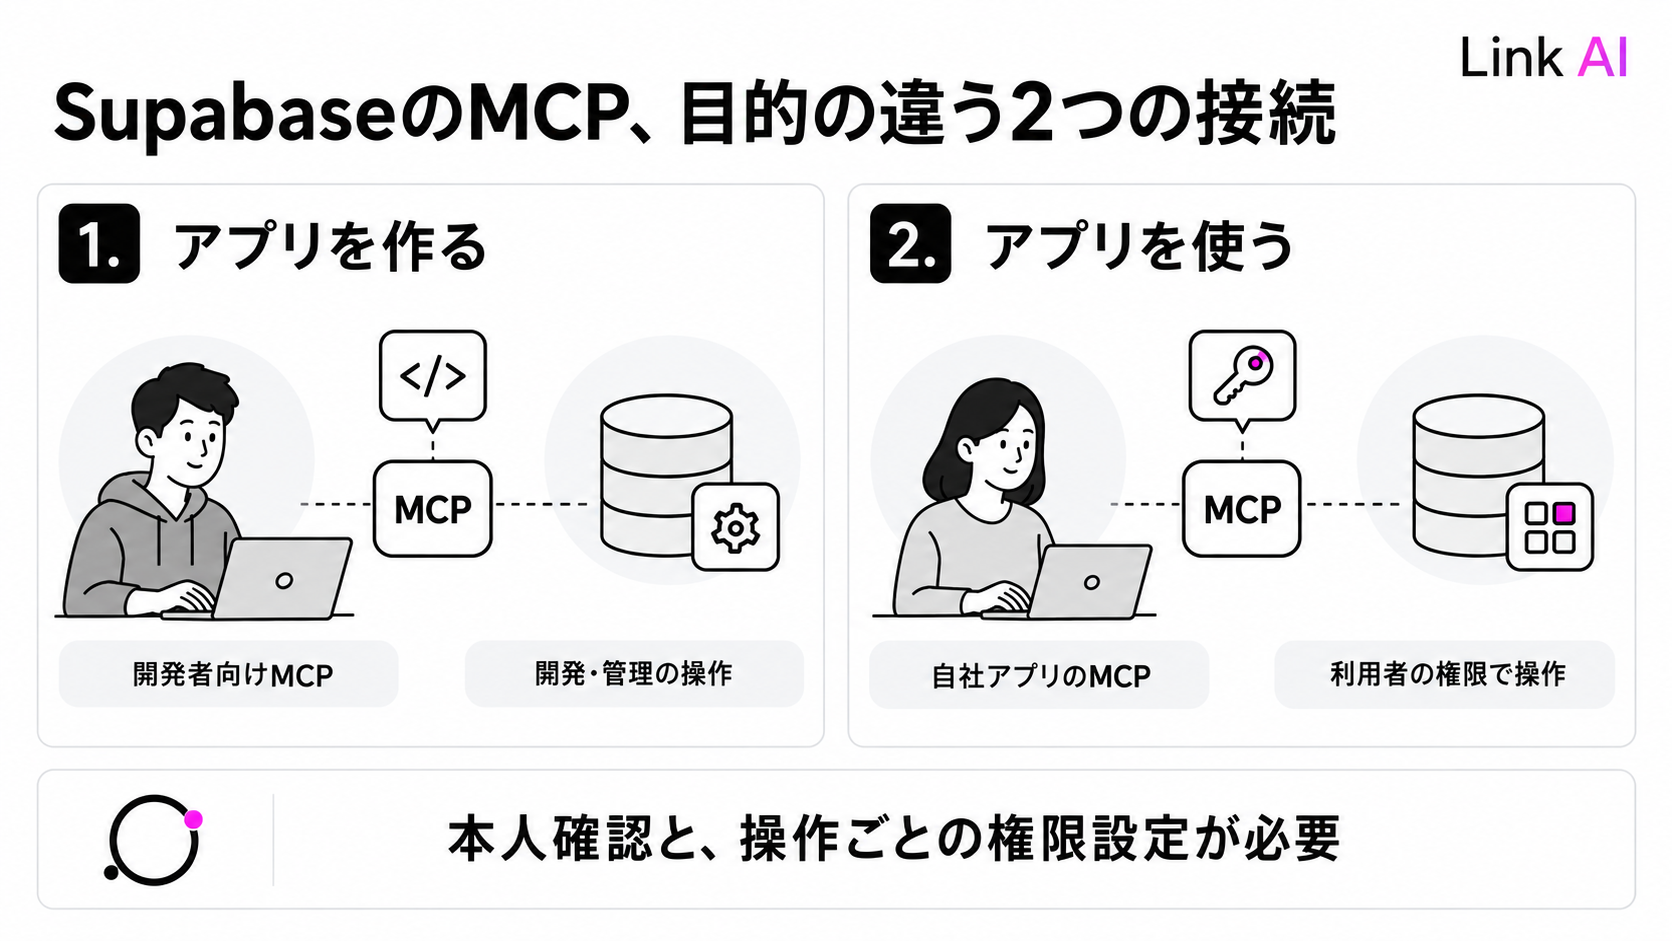
たとえば、自社の案件管理アプリに「担当案件の状況を調べる」という操作を用意すれば、利用者のAIから呼び出せるようになります。ただし、担当外の案件を見せない設定や、更新を許す操作の範囲は、アプリ側で設計しなければなりません。本人であることの確認と、その人に何を許すかの判断は別だからです。
今回の部品は、その接続と認証を実装するための土台になります。アプリのすべての機能が自動的にAIから使えるようになるわけでも、接続しただけで適切な権限設定が完成するわけでもありません。
Computeの限定提供とTurso買収は、今使える機能と分けて見る
同時に発表された「Supabase Compute」は、データベースと同じプロジェクト内で、長時間動くサービスやエージェント用の実行環境を提供するものです。単発の処理だけでなく、常時動くバックエンドや長い処理を扱う用途を想定しています。
ただし、Computeの案内ページには、申し込み制の限定アルファであり、社内評価向けで、本番の処理や顧客向けサービスには使わないことが明記されています。正式提供された機能として導入計画に織り込む段階ではありません。
また、Supabaseは同日、軽量なデータベースを提供するTursoの買収も発表しました。AIが多数の試作品を作るようになると、一つひとつに大きな専用環境を用意するより、必要なときだけ使える小さなデータベースが求められる、というのが同社の説明です。
Turso側の発表では、既存のデータベースやAPIは継続し、両社の深い統合は今後進めるとしています。Supabaseが使うPostgresを直ちに置き換えたり、既存システムの移行を要求したりする発表ではありません。
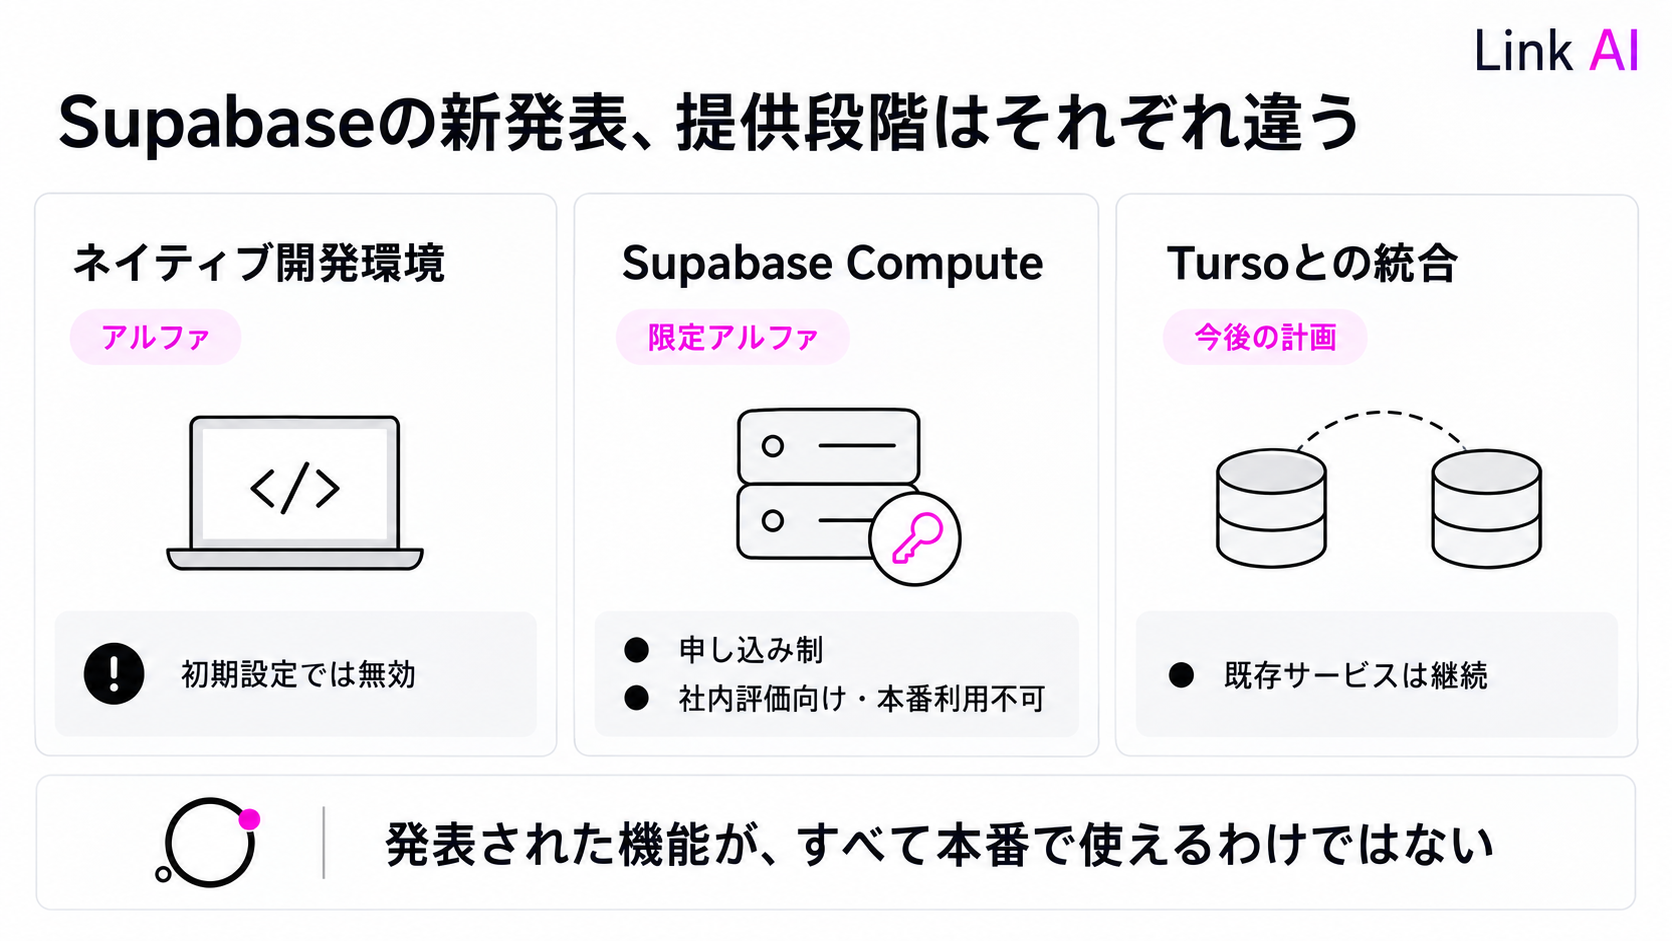
これらの発表から読み取れるのは、AIにコードを書かせるだけでなく、試す環境、動かし続ける環境、利用者からの接続までSupabase内で扱おうとしていることです。一方で、それぞれ提供段階は違います。自社の導入判断では、「すでに使える部品」「検証に参加する機能」「今後の計画」を分けておくと、発表の大きさと実際に採用できる範囲を混同せずに済みます。
Link AIでは、業務に合うAIツールの選定や導入条件の整理をAIアセスメントで支援しています。自社での比較・検証の進め方を相談したい方は、お問い合わせください。