OpenAIのDecisions APIが公開ベータに。Mistral・Beamの性能とCoworkの変更も確認
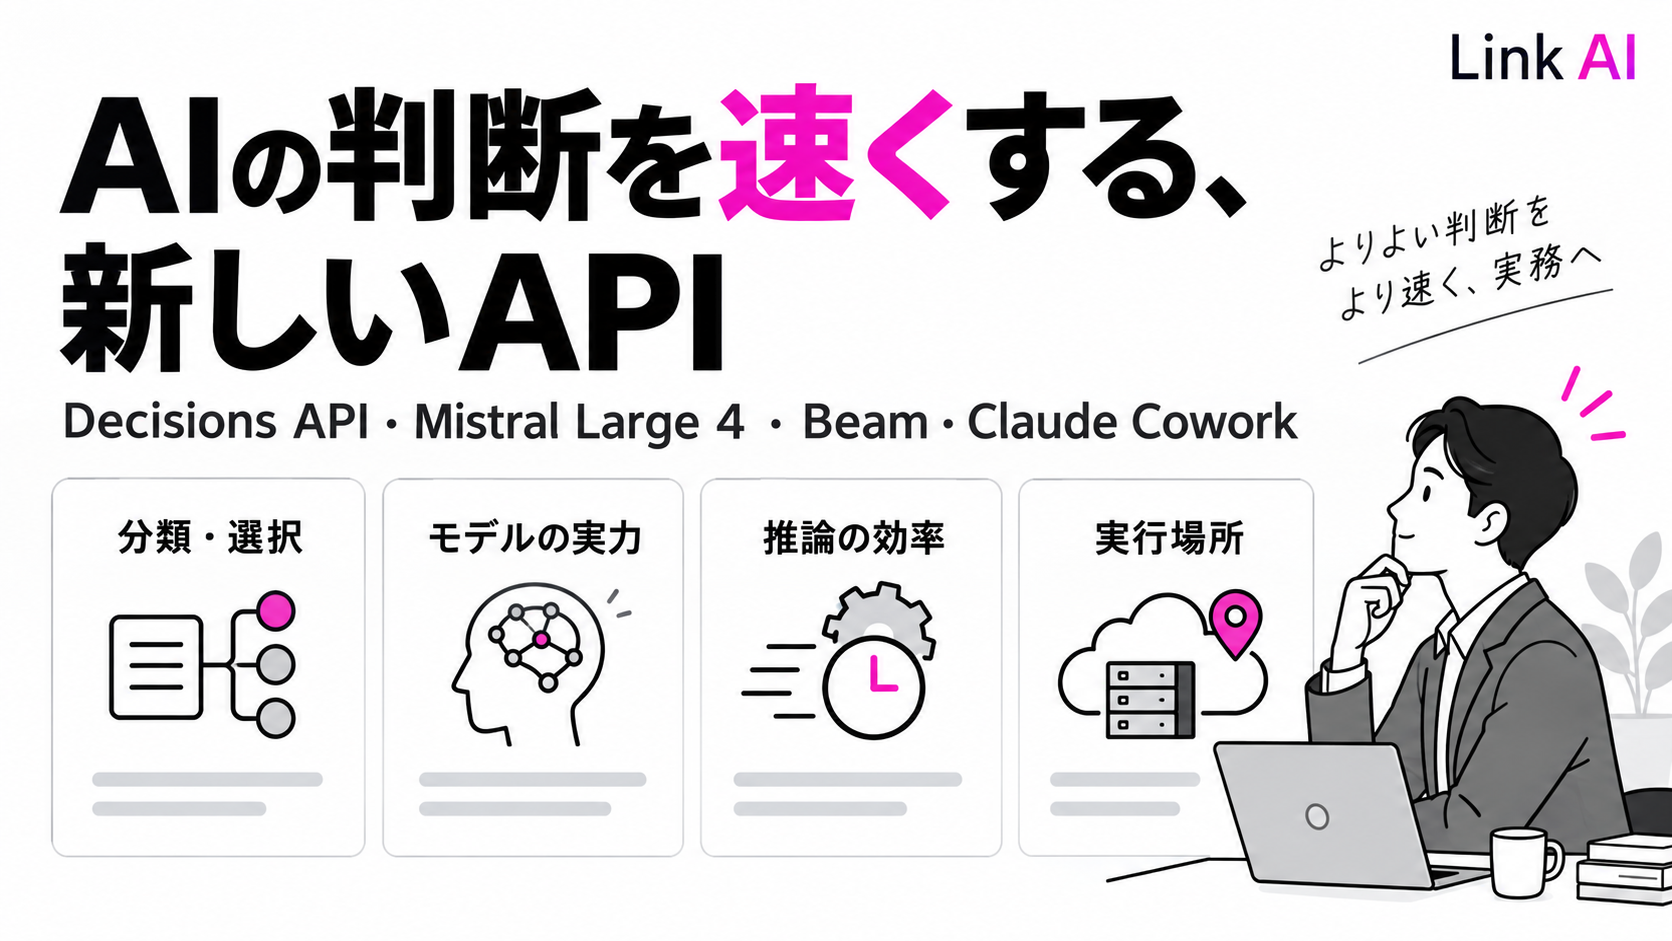
1. OpenAIのDecisions APIが公開ベータに。分類や選択を、専用APIで速く返す
OpenAIは10月6日、GPT-6 Lunaを使う「Decisions API」をすべての開発者向けに公開ベータで提供し始めました。9月29日のDevDayでは限定プレビューだったため、今回のニュースは、発表済みの機能を広く試せるようになったことです。公開ベータの発表、DevDayでの発表
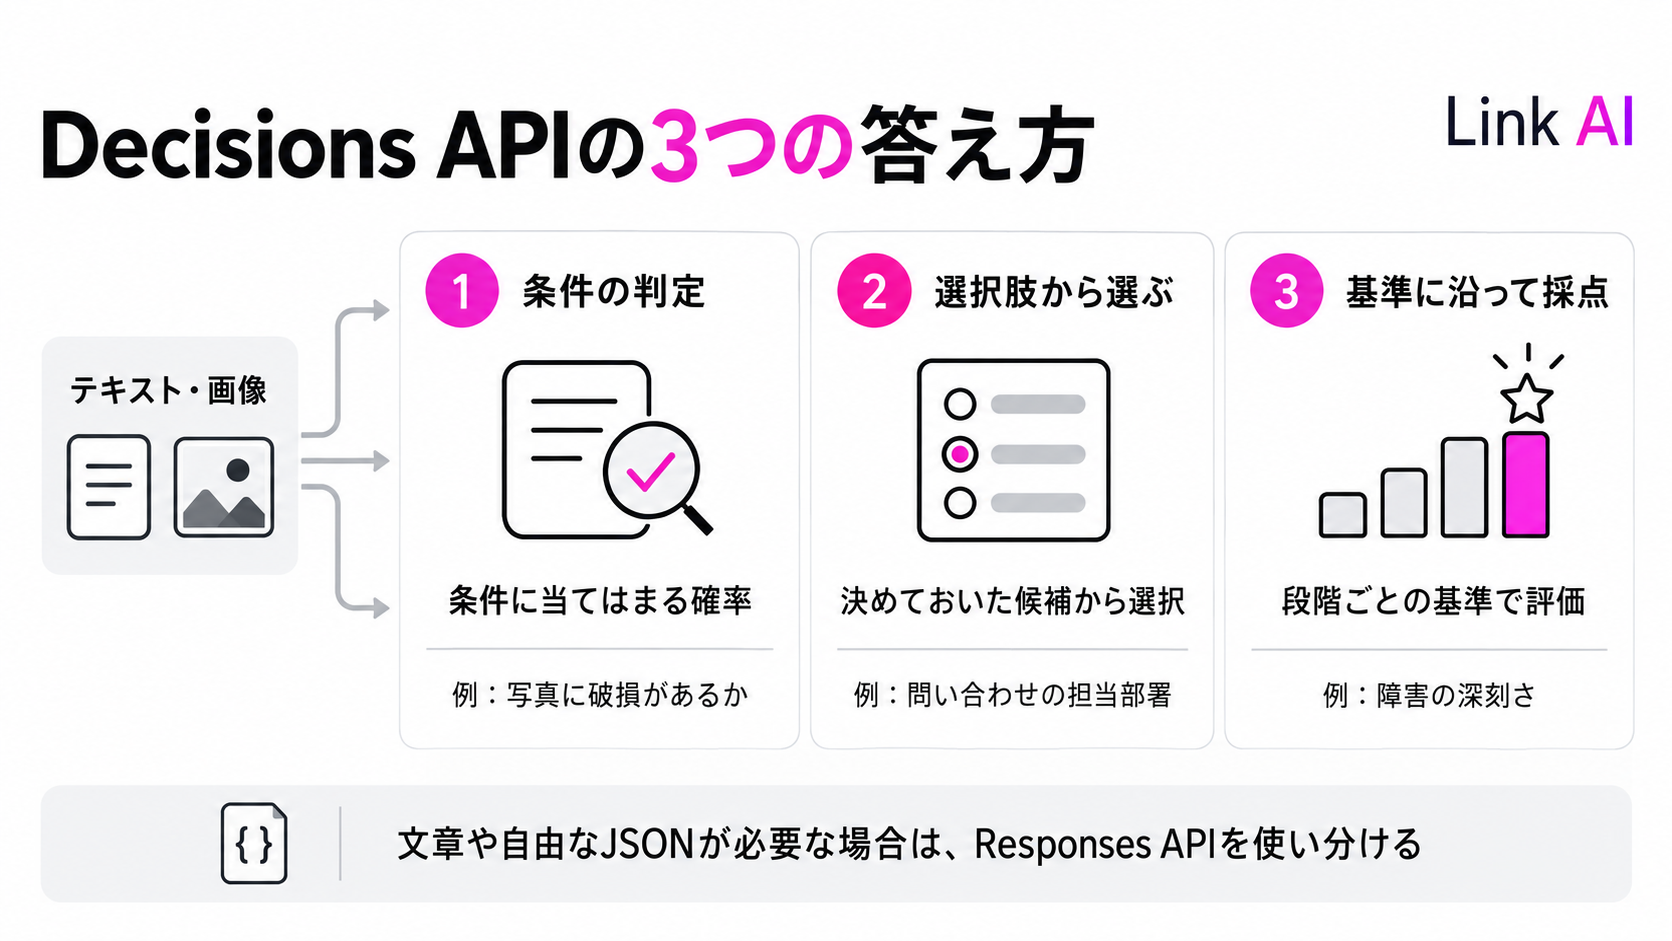
このAPIは、テキストや画像を受け取り、あらかじめ決めた問いに答えます。返す答えは、次の3種類です。
- •条件の判定(Predicate):「写真に破損があるか」など、条件に当てはまる確率を返す。
- •選択(Choice):「請求・技術・配送」のように用意した候補から選ぶ。
- •採点(Score):障害の深刻さなどを、段階ごとに決めた基準で評価する。
たとえば問い合わせの振り分けなら、「請求担当に回す」という選択をシステムがそのまま使えます。一方、顧客への返信文や、項目を自由に定義したJSONの生成が必要なら、通常のResponses APIを使います。Decisions APIは現在GPT-6 Lunaのみが対象で、文章生成全般を置き換えるものではありません。公式ガイド
「最大10倍速い」の比較対象と、入力だけの料金体系
OpenAIは、同じGPT-6 LunaをResponses API経由で使う場合と比べ、最大10倍速く判断を返せると説明しています。これはAPIの応答についての公表値であり、接続先の処理や人の確認も含む業務全体が10倍速くなるという意味ではありません。公開ベータ版について、同じ課題・入力条件でこの倍率を確かめた第三者の実測はまだ確認できていません。
料金は100万入力トークンあたり0.10ドルで、出力トークンとキャッシュの読み書きには課金されません。地域別処理の追加料金や長い入力の料金倍率は別途適用されます。専用APIの料金条件
たとえば、質問文などを含む課金対象の入力が1回1,000トークンで、10万回処理する場合、基本料金での入力費用は10ドルです。出力の長さで料金が増えないため、短い判定を大量に行う処理では予算を見積もりやすくなります。ただし、この計算にアプリの運用費や誤判定への対応費は含みません。
コメント:新しくできる仕事より、繰り返す判断の待ち時間に注目する
問い合わせの分類自体は、従来の言語モデルでもできました。Jevなど、決められた形式で判断を返す別のモデルもすでにあります。Mohamed Fathir氏による既存モデルの検証でも、その方式と通常の言語モデルが比較されています。ただし、同氏の検証にはOpenAIのDecisions APIそのものは含まれておらず、今回の公開ベータ版の優劣を示す資料にはできません。
今回見るべきなのは、既存の分類や選択を、許容できる精度のまま、どれだけ短い待ち時間と低い費用で処理できるかです。たとえば問い合わせを受けるたびに担当部署を選ぶシステムでは、判定が何秒もかかれば、その分だけ後続の処理開始も遅れます。そうした細かい判断の繰り返しが、専用APIを検討する場面になります。
選択や採点では、候補ごとの確率と信頼度も返されます。ただし、信頼度の数値をそのまま自社データでの正答率とみなすことはできません。過去の問い合わせに正しい担当部署を付けたデータで試し、「自動で振り分けたうち何件が正しかったか」と「判断を保留して人に回した件数」を確認すれば、速さと引き換えに誤振り分けが増えていないかを判断できます。速度の公表値だけで採用を決めず、この条件をそろえて比較することが大切です。
2. Mistral Large 4が公開プレビューへ。強みは分野ごとに見る
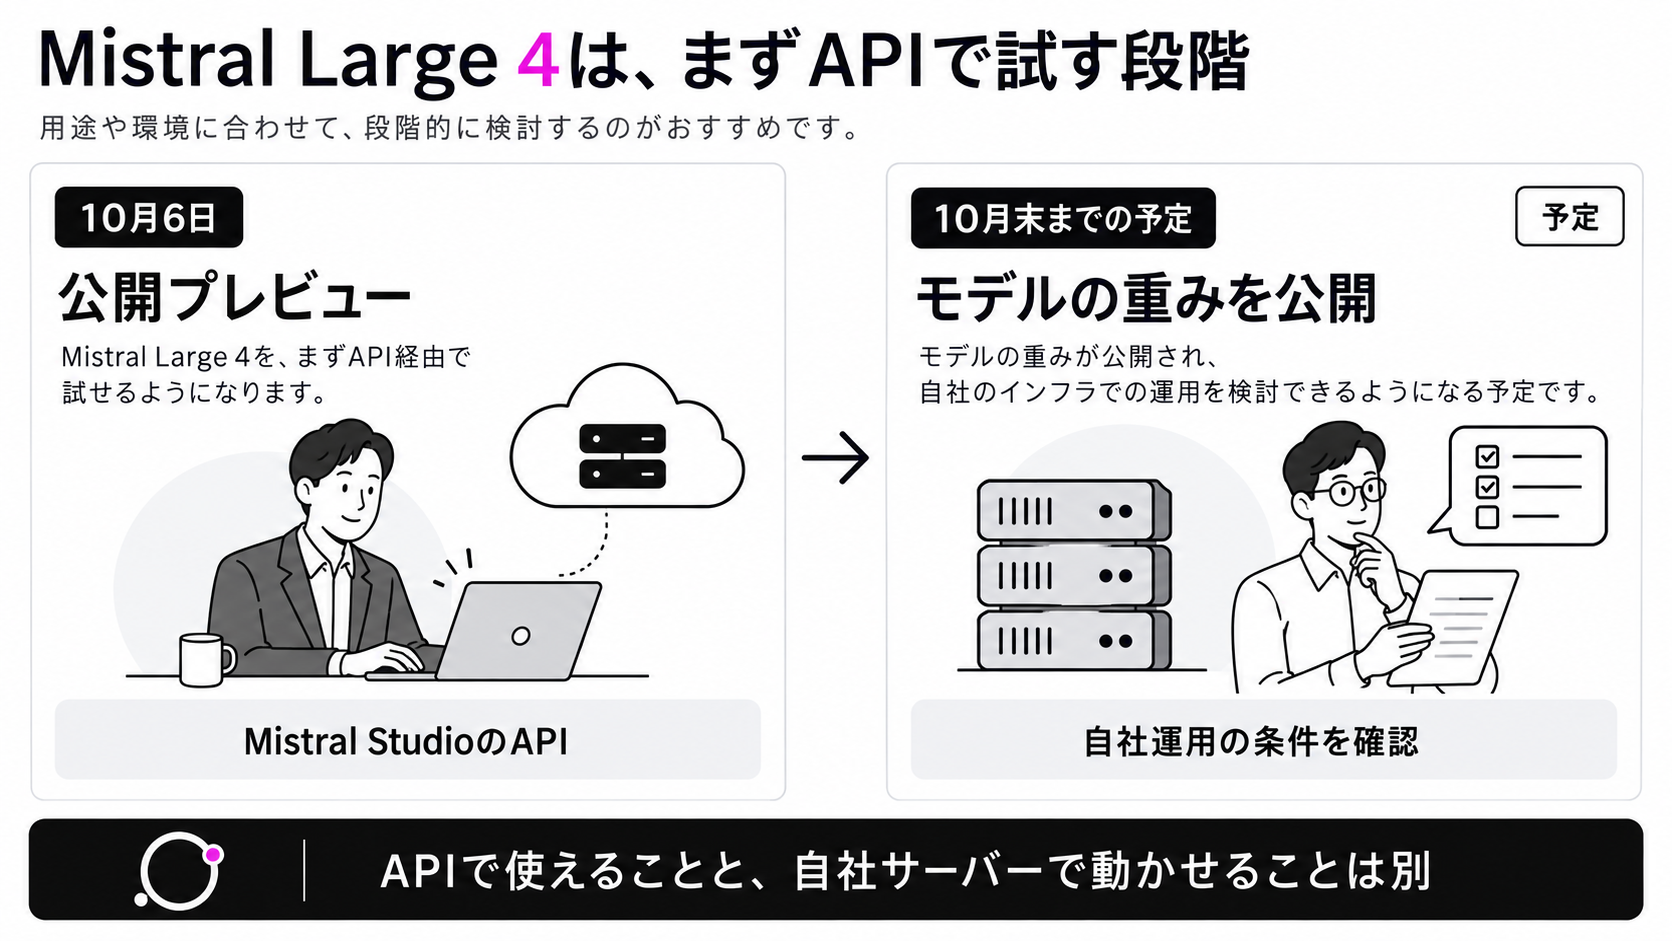
Mistralは10月6日、新しい主力モデル「Mistral Large 4」の公開プレビューを始めました。文章と画像を入力でき、Mistral StudioのAPIで利用できます。自社のサーバーで動かすために必要なモデルの重みは、10月末までに公開する予定です。公式発表
前世代のLarge 3も画像入力に対応していました。今回の違いは、画像を初めて扱えるようになったことではなく、モデルの規模と処理できる文脈が拡大した点にあります。公式仕様では、総パラメータ数は6,750億から1兆500億に、入力などを収めるコンテキストは256kから1Mトークンに増えました。一度の計算ですべてを使う構造ではなく、入力に応じて一部を動かすMoE方式で、稼働パラメータ数は410億から490億です。Large 3の仕様、Large 4の仕様
外部評価では、法務の成果物と数学の証明で異なる結果
規模が大きくなっても、すべての仕事で他社より優れるとは限りません。評価会社Vals AIの測定には、Large 4の得意・不得意が表れています。
| 評価 | 測る対象 | Large 4の結果 |
|---|---|---|
| Harvey's Legal Agent Benchmark | 文書や表計算などのツールを使い、法務の成果物を仕上げる | タスク合格率15.83% |
| Finance Agent v2 | 情報を調べ、金融に関する分析課題に答える | 正答率54.68% |
| ProofBench v1.1 | 数学の証明課題 | 正答率10.00% |
これらは問題も採点方法も異なる評価で、行をまたいで数字の大小を比べるものではありません。Valsのモデルページは標準設定を推論強度highとしていますが、評価ごとに設定が異なる場合があります。Vals AIの結果と設定
法務の15.83%は低く見えますが、この評価では課題ごとの要件をすべて満たした場合にだけ合格になります。未公開の問題セットを使い、インターネット接続を切った環境で、2つのAI採点者が判定した合格率を平均しています。同じ表で首位のモデルも25.42%です。Large 4は比較的上位に入っていますが、「法務をほぼ自動で任せられる」という結果ではありません。評価方法と比較表
コメント:順位より、どの要件を満たせなかったかが判断材料になる
この違いは、モデル選定でも役立ちます。文書の体裁を整えること、必要な論点を含めること、数値や根拠を正しく扱うことは、それぞれ別の要件です。総合順位が高くても、自社が譲れない要件を落とすなら、その仕事には適しません。
実際の利用報告にも具体的な弱点があります。Not an AI AppのMarvin Smit氏は、OpenRouter経由の既定設定で2種類のコード課題を各3回実行しました。時間表記を読むコードの修正は安定していた一方、請求書計算では3回中2回、数量「1.005」を小数桁数の違反として拒否するコードを生成したと報告しています。小数を計算機で扱う際の丸め誤差を考慮できていなかったためです。小規模な個人検証ですが、「コードが書ける」という評価だけでは見えない、境界値での失敗を示しています。同氏の検証
利用価格にも条件があります。公式ドキュメントの開始時価格は100万トークンあたり入力0.68ドル、出力2.09ドル。更新履歴によると開始から2週間は50%割引で、割引前の表示は入力1.36ドル、出力4.18ドルです。試用時の請求額だけで継続運用の予算を組まず、通常価格と実際に出力する量を合わせて比較する必要があります。価格、割引期間
3. ReflectionのBeamは、最高得点より推論の効率を訴求
Reflectionが10月5日に発表した「Beam」は、同社初のモデルです。テキストを扱うMoEモデルで、総パラメータ数5,010億に対し、計算時に稼働するのは230億。先行利用は申し込み制で、重みと技術報告書などは10月中に公開し、重みにはApache 2.0ライセンスを適用する予定です。Reflectionの発表
公表表では、BeamはGLM 5.2に近い項目がある一方、Kimi K3には差をつけられています。
| 評価 | Beam | GLM 5.2 | Kimi K3 |
|---|---|---|---|
| Terminal-Bench 2.1:端末を使う作業 | 80.1 | 81.0 | 88.3 |
| HLE・ツールなし:難度の高い知識・推論問題 | 36.2 | 40.5 | 46.9 |
表はReflectionが公表したスコアです。競合値にはArtificial AnalysisやDataCurveの測定を用いており、全モデルを同じ実行環境・推論設定で再測定した比較とは確認できません。また、Mistralが公表するTerminal-Bench 4の結果と、この表の2.1を並べて順位をつけることもできません。同じ評価名でも版が違えば、別の物差しです。
コメント:「計算量が少ない」と「安く、速く済む」は分けて読む
Reflectionは、推論評価でGLM 5.2に近い性能を、3〜4分の1の計算量で得られると説明しています。ただし、この計算量は稼働パラメータ数と生成トークン数から求めた概算で、入力を最初に処理する計算や配信基盤の負担などを含みません。実際の料金や所要時間を測った数字ではありません。算出方法
この設計が目指すのは、最高点を取り続けるモデルではなく、一定の正確さを少ない計算で得るモデルだと読めます。たとえば同じ種類のコード修正を大量に処理するなら、少し低い成功率でも費用との釣り合いが取れる可能性はあります。ただし、失敗の再試行や人の修正が増えれば、その利点は小さくなります。
Beamの独立した追試や一般向けの価格はまだ確認できず、現時点で費用対効果の優劣までは判断できません。公開後に見るべきなのは、同じ課題を同じ合格基準で実行したときの、成功1件あたりの費用と時間です。推定計算量の削減がそこにも表れるかどうかで、今回の主張の実用的な価値が分かります。
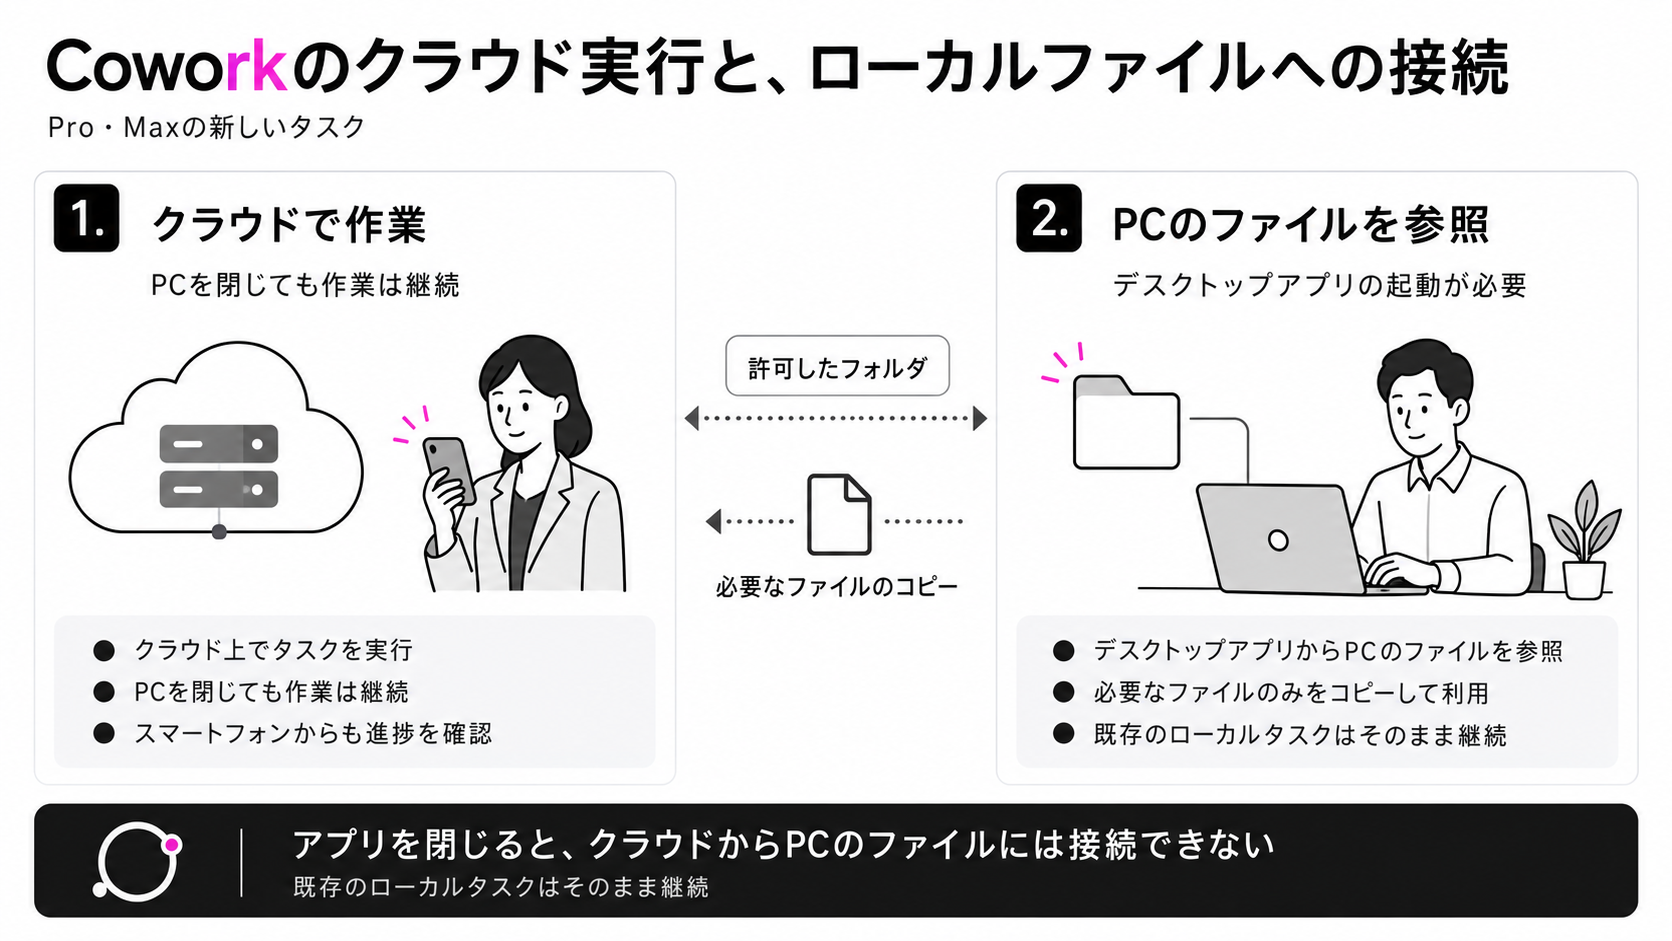
4. Claude CoworkのPro・Maxは、新しいタスクをクラウド実行に統一
Anthropicは10月6日、Claude CoworkのPro・Maxプランで、新しいタスクをクラウド上で実行する方式に統一しました。PC内だけで実行する設定は削除され、従来その設定を使っていた利用者も、次にデスクトップアプリを開くと移行します。新しいCoworkタスクについては、元の方式へ戻す設定がありません。変更内容
クラウド実行そのものは以前から提供されていました。今回の変更は、Pro・Maxで新規タスクの実行場所を選べなくなることです。すでにPC上で始めたタスクと既存のローカル定期タスクは、そのままPC上で続けられます。新しく作る定期タスクはクラウド実行になります。
コメント:PCを閉じて続く作業にも、ローカル接続の条件がある
クラウドでは、作業を進めるエージェントやコードがAnthropicのサーバー上で動きます。一方、PC内のファイルを読むときには、そのPCのデスクトップアプリを経由します。接続できるのは許可したフォルダに限られ、アプリがオフラインならPCには届きません。実行環境の説明
つまり、「PCを閉じてもタスクは動く」と「閉じたPCのファイルも引き続き読める」は別です。フォルダ全体を自動でクラウドへ移す方式でもなく、必要なファイルのコピーを取得して使います。クラウドからローカルファイルを扱うには、デスクトップで始めたセッション、または定期タスクであることなどの条件があります。端末ごとの機能と制約
たとえば、出張前にPC内の資料を使う集計を依頼した場合、すでに取得した資料を処理する作業と、後から別のファイルを取りに行く作業では、PCを閉じたときの影響が違います。これまでローカル実行を前提に使っていた企業は、作業対象のファイルをどこから取得するのか、クラウド側で処理される内容は何かを確認すると、移行後に止まる処理や社内ルールとの不一致を見つけやすくなります。
なお、今回の一律変更の対象はPro・Maxです。Team・Enterpriseには別の管理設定があり、すべての法人利用に同じ変更が適用されたと捉えるのは正確ではありません。
Link AIでは、利用するモデルや実行環境の比較から、業務ごとの評価基準づくりまでを支援するAIアセスメントを提供しています。自社の仕事に合うAIの選定や、既存の運用を見直したい方は、お気軽にご相談ください。