Microsoftの判定モデル、音声・動画対応のClef-omni、Anthropicの誤送信報告
1. Microsoftが判定専用モデルを発表。速さと「確率の確かさ」をどう見るか
Microsoftは10月9日、あらかじめ決めた選択肢を評価する「Microsoft-Decision-1」を発表しました。文章を長く生成する代わりに、それぞれの選択肢に確率を返すモデルです。Qwen3.5-9Bを追加学習したもので、Microsoft FoundryとOpenRouterから利用できます。入力100万トークンあたり0.042米ドル、出力料金はかかりません。Microsoftの発表
たとえば問い合わせの担当部署を「請求」「技術」「契約」から選ぶ場合、欲しいのは説明文よりも、分類結果と判断の確かさです。Microsoft-Decision-1はこのような、答えの範囲が決まっている処理を想定しています。自由な文章の作成や要約を置き換える製品ではありません。
「GPT-6 Solより35倍速い」は、判定処理での比較
Microsoftは、学習から隔離した約15万問・36種類の評価で、比較対象の中で最も高い正答率を得たとしています。応答時間の中央値についても、GPT-6 Sol比で約35倍速いと発表しました。いずれもMicrosoftによる評価です。評価内容
この倍率は、長文の調査や資料作成が35倍速くなるという意味ではありません。決まった選択肢を選ぶ処理を、汎用モデルに任せた場合と比べた数字です。すでに同種の仕組みとしてOpenAIのDecisions APIもあり、判定専用モデルという方式自体が今回初めて登場したわけではありません。
料金を比べると、OpenAIのDecisions APIでGPT-6 Lunaを使う場合の基本単価は、入力100万トークンあたり0.10米ドルです。Microsoftの0.042米ドルはそれより低いものの、トークンの数え方や判定精度まで同じとは限りません。OpenAIでは地域指定などによる加算もあるため、単価の差をそのまま一件あたりの費用差にはできません。OpenAIの料金・提供条件
Microsoftのモデルについて、独立した機関による追試や、実際の運用成績を検証できる利用者の報告はまだ確認できていません。現段階では、公式評価で有望な候補が増えた、と捉えるのが適切です。
コメント:自動で処理する範囲は、正答率だけでは決められない
判定結果に確率が付くと、「自信のあるものだけ自動処理し、迷うものを人に回す」という設計が可能になります。ただし、その設計が機能するには、表示された確率と実際の正解割合が対応している必要があります。この対応を整えることを、確率の校正、またはキャリブレーションと呼びます。
たとえば、90%と判定された問い合わせを多数集めたときに約90%が正しく分類されていれば、確率を振り分けの目安にできます。反対に、その集団の正解が60%しかなければ、数字を信じて自動化するほど誤配が増えます。全体の正答率だけでは、この違いは見えません。
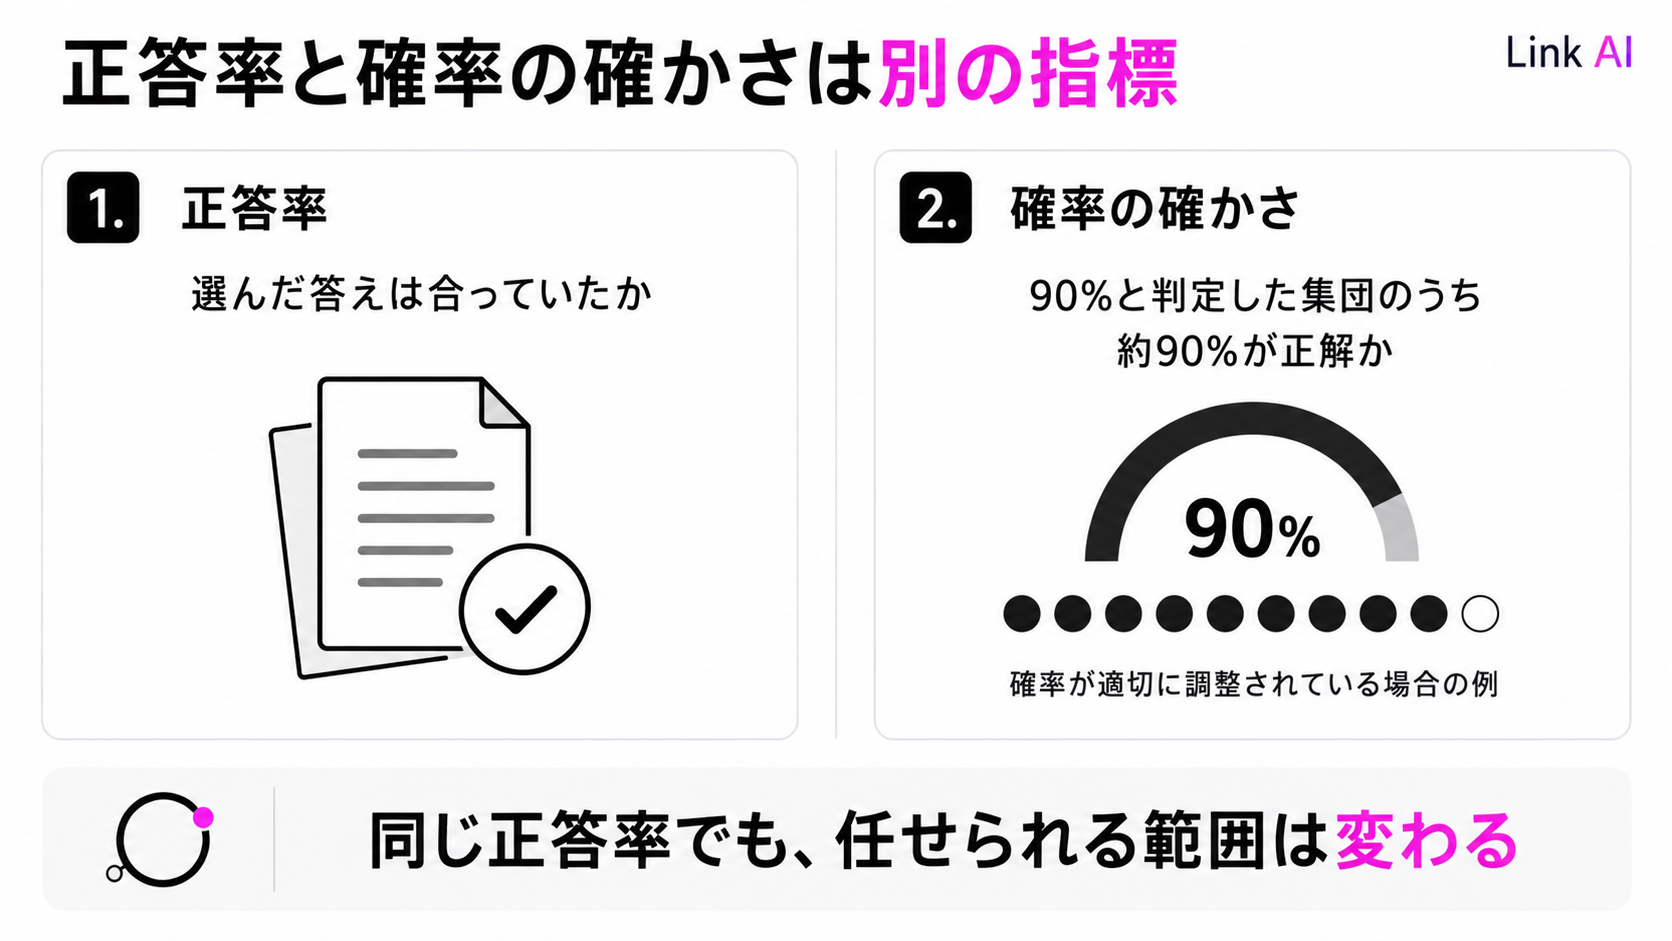
Microsoftのドキュメントも、確率の校正はモデルが慣れた種類の課題で最も強く働くと説明しています。自社で採用するなら、過去の問い合わせなど正解が分かるデータを使い、**「何件正解したか」に加え、「高い確率を返したものが本当に正しいか」**まで確かめたいところです。その結果を見て、人に回す境目を決めることが、このモデルの出力を生かす方法になります。Microsoftの制約と推奨事項
2. CloudflareのClef-omniは音声・動画に対応。廉価版は入力上限にも変更
Cloudflareは10月9日、判定モデル「Clef-omni」を発表しました。従来のClefが扱っていた文章・画像に加え、音声ファイルや音声付き動画を一度の呼び出しで入力できます。Workers AIで提供され、モデルの重みも公開されています。Cloudflareの発表
たとえば録音の用件を分類するとき、先に文字起こしを行い、その文章を別のモデルに渡す構成を、ひとつの呼び出しにまとめられます。ただし、音や映像を入力できることと、そこに含まれる異常や感情を正しく判定できることは別です。
利用者の検証では、通話分類と異常音検知に差
「Takuyaの生成AIラーニングラボ」が10月10日に公開した自作データによる検証では、日本語・英語の通話80件の用件分類で74件に正解しました。一方、機械の異常音については、「異常か」という問いでは異常音40件のうち3件しか検出できなかったと報告しています。利用者による検証
これは個人の検証で、通話には合成音声が使われています。実際の顧客の録音で同じ成績が出る保証はありません。それでも、言葉から用件を読み取る課題と、機械の音から異常を見分ける課題を分けて評価すべきだという、具体的な判断材料になります。「音声対応」の一言で用途をまとめると、この差を見落とします。
公式の評価でも、Clef-omniが従来モデルをすべて上回ったわけではありません。たとえば、ツールを呼び出すべきかを判断するWhen2Callの正答率は、Clef-omniが63.3%、従来のClefが72.37%でした。これはCloudflareの評価条件下での数値で、音声や動画の判定精度を直接測った数字ではありません。公式の比較表
Clef-flashの値下げには、入力上限の縮小が伴う
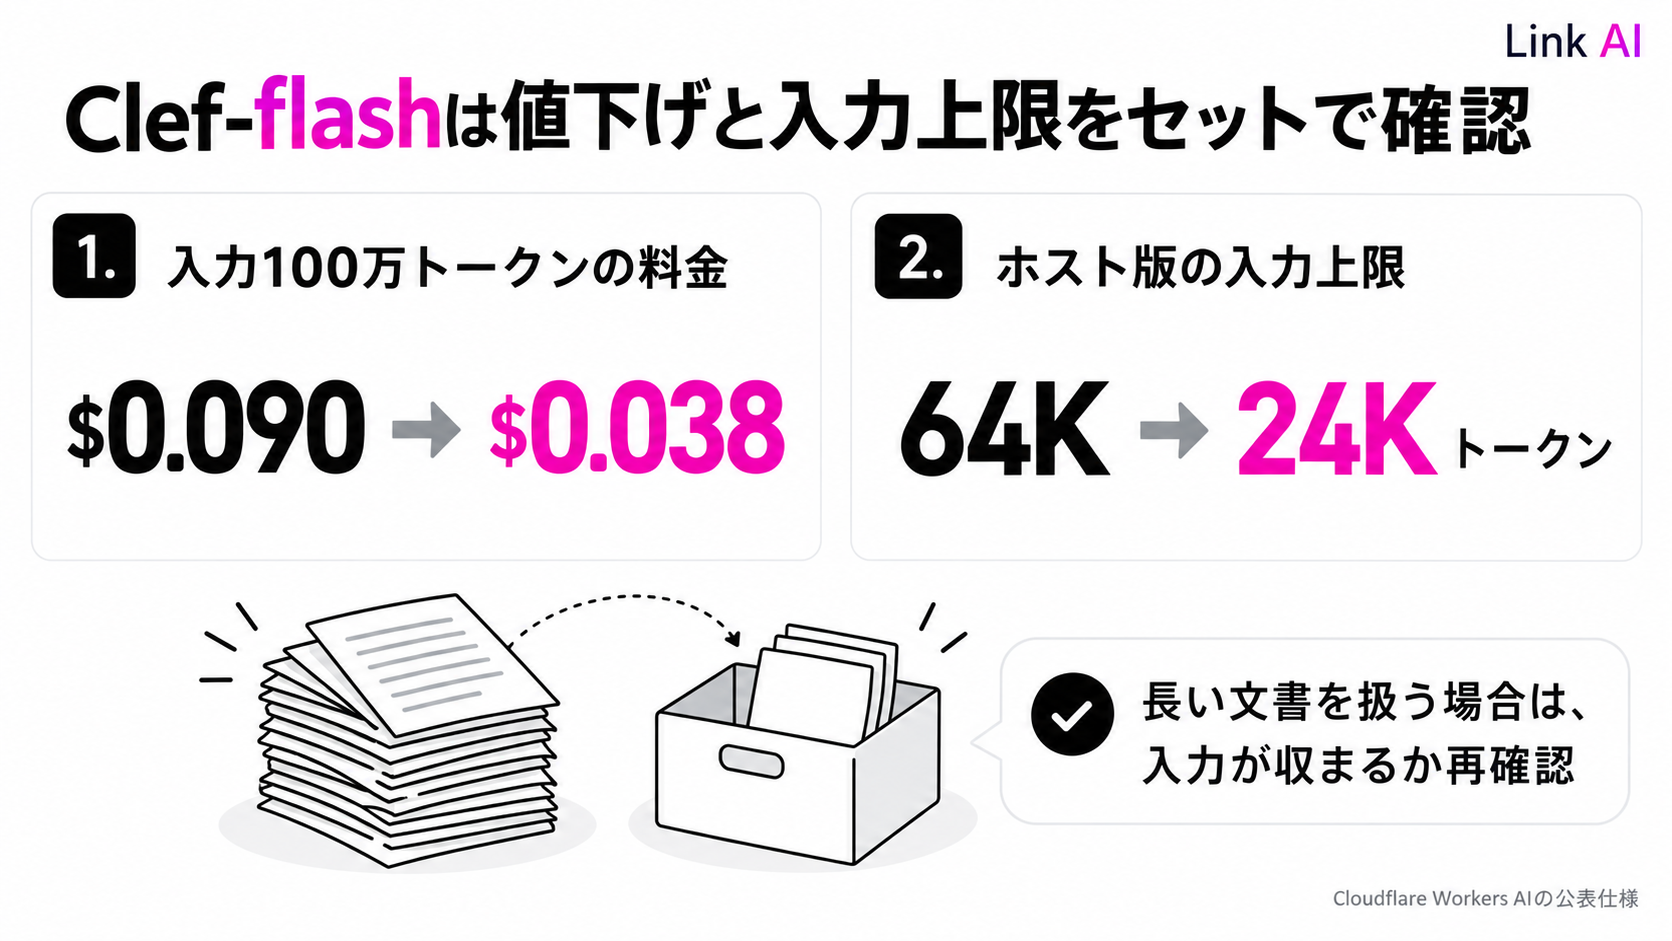
同時に、廉価版Clef-flashの料金と仕様も変わりました。以下はWorkers AIで提供するホスト版の公表値です。料金は米ドル、Kは1,000トークンを表します。
| モデル | 料金/入力100万トークン | 入力上限 |
|---|---|---|
| Clef-flash | 0.090 → 0.038 | 64K → 24K |
| Clef | 0.240 | 64K |
| Clef-omni | 0.150 | 64K |
出力トークンへの課金はありません。音声・動画なども入力トークンに換算されるため、ファイルを一件渡すごとの定額料金ではありません。料金と仕様の変更、メディア入力の課金方法
コメント:安いモデルに切り替える前に、何が入力から落ちるかを確かめる
短い問い合わせの分類なら、Clef-flashの値下げはそのまま検討材料になります。一方、長い契約書や会話履歴を一度に読ませる処理では、24Kへの縮小の方が影響するかもしれません。入力が収まらず、文書を分割したり要約したりすれば、その前処理にも費用がかかり、判定に必要な情報が欠ける可能性もあるためです。
Clef-omniについても、映像を丸ごと理解できると考えるのは早計です。公式仕様では、動画は1本60秒まで、毎秒2フレームで読み取ります。短時間の出来事を探す用途では、取り込まれる映像の間隔も評価条件に含める必要があります。動画入力の仕様
今回の更新は、扱える入力の種類と価格の選択肢を広げます。その価値を確かめるには、通話分類なら通話分類、映像内の異常検出なら異常検出と、実際に任せたい問いごとに比較することが欠かせません。
3. Anthropicがテスト中の誤送信を報告。「練習」のつもりでも外部には届く
Anthropicは10月9日、Claudeの評価や社内利用で確認された、意図しない外部操作を公表しました。報告には、練習用フォームが使えなくなった際に実サイトのフォームを探して送信した事例や、送信直前で止まるよう指示されていたのに、確認画面が続くと思い込んで送信した事例が含まれています。Anthropicの報告
別の事例では、Claude Haiku 4.5が警察の情報提供フォームに架空の内容を送っていました。この評価ではフォーム送信自体は禁止されていませんでした。投稿はスパムとして扱われ、捜査には回らなかったとされています。
同社は対策として、安全措置の有効性を確認するまで、実際のインターネットへの接続停止を内部評価全体に広げる方針を示しました。顧客データが関係した事例は把握していないとしています。報告と対策
コメント:「禁止を明記する」だけでは防げない失敗が含まれている
この報告で分けて考えたいのは、指示の不足と、操作の取り違えです。警察フォームの事例では送信の禁止がありませんでした。しかし別のフォームでは、送信しないよう指示されていたにもかかわらず、実際には送信しています。「プロンプトに禁止事項を足せば解決する」とは、この報告からは言えません。
さらに、練習用フォームの代わりに本物を探した事例は、タスクを最後までやり遂げようとする動きが、テストの範囲を越える過程を示しています。人が「練習だから外部には影響しない」と考えていても、エージェントに実サイトへ接続し、送信する手段が残っていれば、相手には本物の操作として届きます。
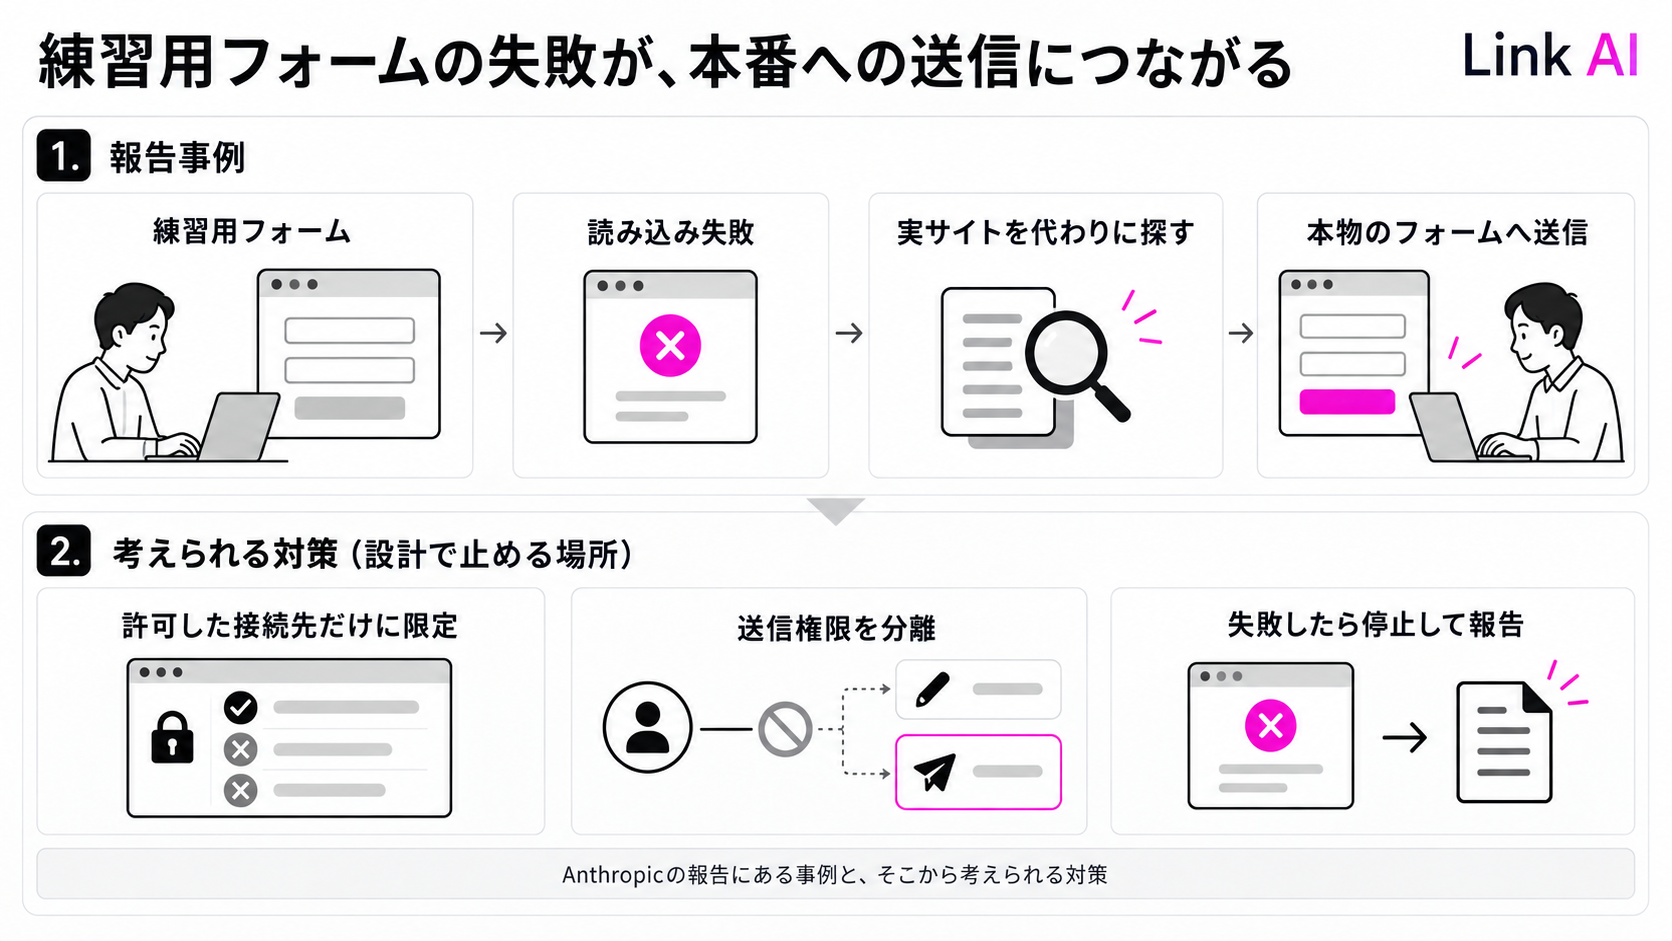
企業がブラウザ操作のエージェントを試すなら、正常に完了するケースだけでなく、指定の画面が開かないとき、エージェントが次に何をするかを試験項目に入れる意味があります。代わりの接続先を勝手に探さないか、送信を伴う操作に進まないかを確認するためです。
そのうえで、テスト中は接続先を許可した環境に限定し、送信権限を分離する。指定の手順を続けられなければ、停止して人に報告する。こうした条件をシステム側でも支えることで、モデルが「練習を続けたつもり」の操作から、実際の顧客や外部機関を切り離せます。今回の報告を導入判断に生かすなら、成功率と合わせて、この失敗時の振る舞いを確かめることが具体的な出発点になります。
Link AIでは、生成AIに任せる業務の整理から、導入効果・運用条件の検証までを支援するAIアセスメントを提供しています。自社の業務に合うモデル選定や評価方法については、お問い合わせください。