MetaのMuse Wonderは何が伸びたか。Maia 300と小型AIの自己複製研究
1. MetaがMuse Wonderを公開。エージェントの性能向上には、費用増も伴う
Metaは10月12日、新しいAIモデル「Muse Wonder」と上位の「Muse Wonder Full」を発表しました。複数の操作を続けるエージェントや、長時間のプログラミング作業を重視したモデルです。独立した評価でも前モデルからの改善が確認されていますが、APIで使えるのは通常のWonderで、Fullとは提供形態が異なります。
- •Muse Wonder:Meta Model APIと開発支援ツールMuse Codeで提供。
- •Muse Wonder Full:Muse CodeのPower Usage・Maximum Usageプランで提供。APIでの提供はありません。
Metaが強調するのは、必要な文脈を取り出す「Active Memory」と、行き詰まった際に別の方法を試しながら作業を続ける「Active Focus」です。ただし、複数工程の実行や失敗からの復帰自体は、既存のエージェントでも扱ってきた課題です。今回の評価では、それらをどの程度うまく遂行できるようになったかを見る必要があります。Metaの開発者向け発表
端末作業は大きく改善。知識の評価では競合に差が残る
AI評価会社Artificial Analysisが公表したIntelligence Index v4.3では、推論設定maxの総合点が、Muse Spark 1.3の48からWonderで52、Fullで56へ上がりました。Fullは同指数を構成する10評価すべてで前モデルを上回っています。
特に伸びたのは、端末を操作して課題を解く「Terminal-Bench 4.0」です。前モデルの33%に対し、Wonderは52%、Fullは57%でした。プログラムの知識を答えるだけでなく、操作を重ねて課題を完了する能力の改善が表れています。Artificial Analysisの評価報告
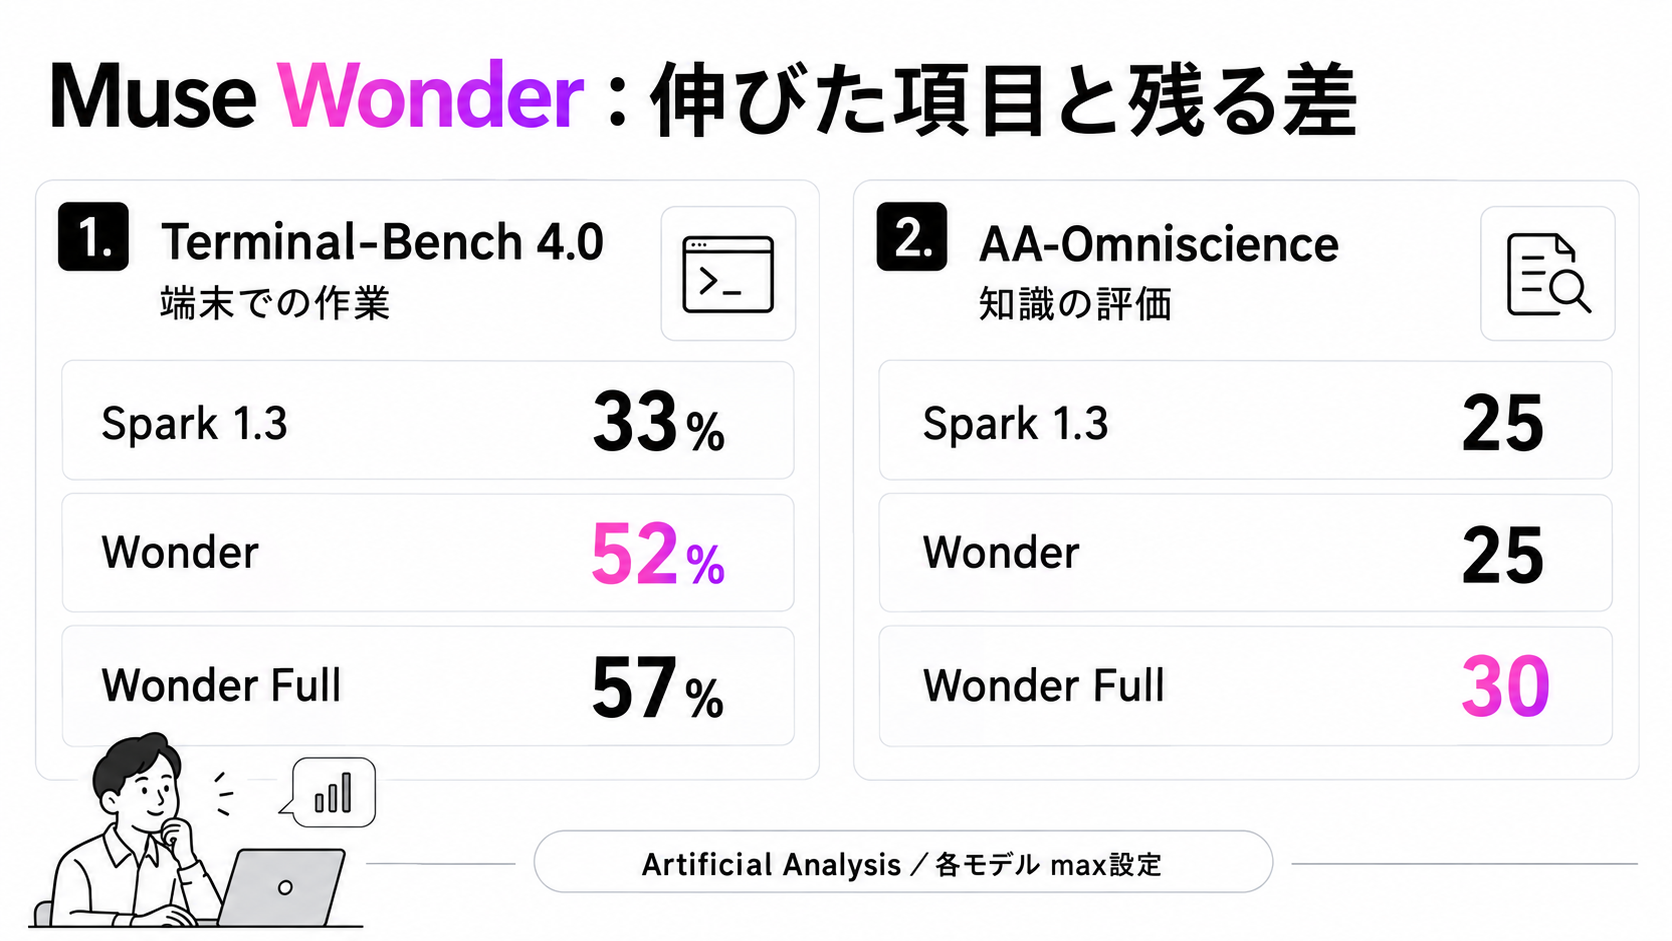
一方、知識を評価するAA-Omniscienceでは、Wonderは前モデルと同じ25、Fullは30です。同じ報告に掲載されたClaude Opus 5.5は46、GPT-6 Astraは43で、ここには差が残っています。総合点の上昇を、あらゆる質問で正確さが増したという意味に読み替えることはできません。
また、API向けWonderの比較表では、長い文脈から推論するAA-LCR v1.1が前モデルの83%から81%になっています。小さな点差だけで有意な悪化と断定はできませんが、「全項目で改善」というFullの結果を通常のWonderにも当てはめるのは不正確です。WonderとSpark 1.3の比較
トークンを節約しても、総額が安くなるとは限らない
公式API価格は次の通りです。いずれもStandard mode、100万トークンあたりの米ドル価格です。
| モデル | 入力 | 入力キャッシュ | 出力 |
|---|---|---|---|
| Muse Spark 1.3 | 1.25 | 0.15 | 4.25 |
| Muse Wonder | 4 | 0.20 | 20 |
出典:Metaの料金表。Fullはこの従量課金表の対象ではありません。
Artificial Analysisの比較では、Wonderの出力トークン数は前モデルより約1割少ないものの、Intelligence Indexの1課題あたり費用は1.60ドルから4.52ドルへ増えています。入力の使用量と単価も費用を左右するためです。この金額は評価課題を集計した値であり、自社のメール作成や開発作業が一律4.52ドルになるという料金ではありません。評価課題ごとの使用量と費用
コメント:評価が伸びた作業に絞って、追加費用を判断する
先行利用者の報告にも、得意不得意が表れています。Piotr Olszewski氏は、ポーランド語の文章やコードなどを含む23課題を、OpenRouter経由・推論設定lowで各1回試しました。Wonderは60語以内という要約条件を守れた一方、金額を文字列にするコードに誤った語を使い、書面には指示されていない日付を加えたと報告しています。同氏の試験と失敗例
これは少数の試験で、日本語業務の品質や一般的な成功率を示すものではありません。それでも、端末作業の評価で強いモデルが、文章の細部でも常に正確とは限らないことを考える材料になります。
Wonderを検討するなら、既存モデルが途中で止まってしまう開発作業など、今回改善が大きかった領域で比較する理由があります。反対に、知識を答えるだけの用途を総合点だけで置き換える根拠は弱いでしょう。さらに、Fullの好成績に惹かれてAPI導入を決めても、そこで使うモデルは通常のWonderです。用途に合う評価、実際に使うモデル、追加費用の3つを揃えて見ることが、この発表を選定に生かすうえでの要点です。
2. MicrosoftがMaia 300を発表。40%増と7倍は、何を比べた数字か
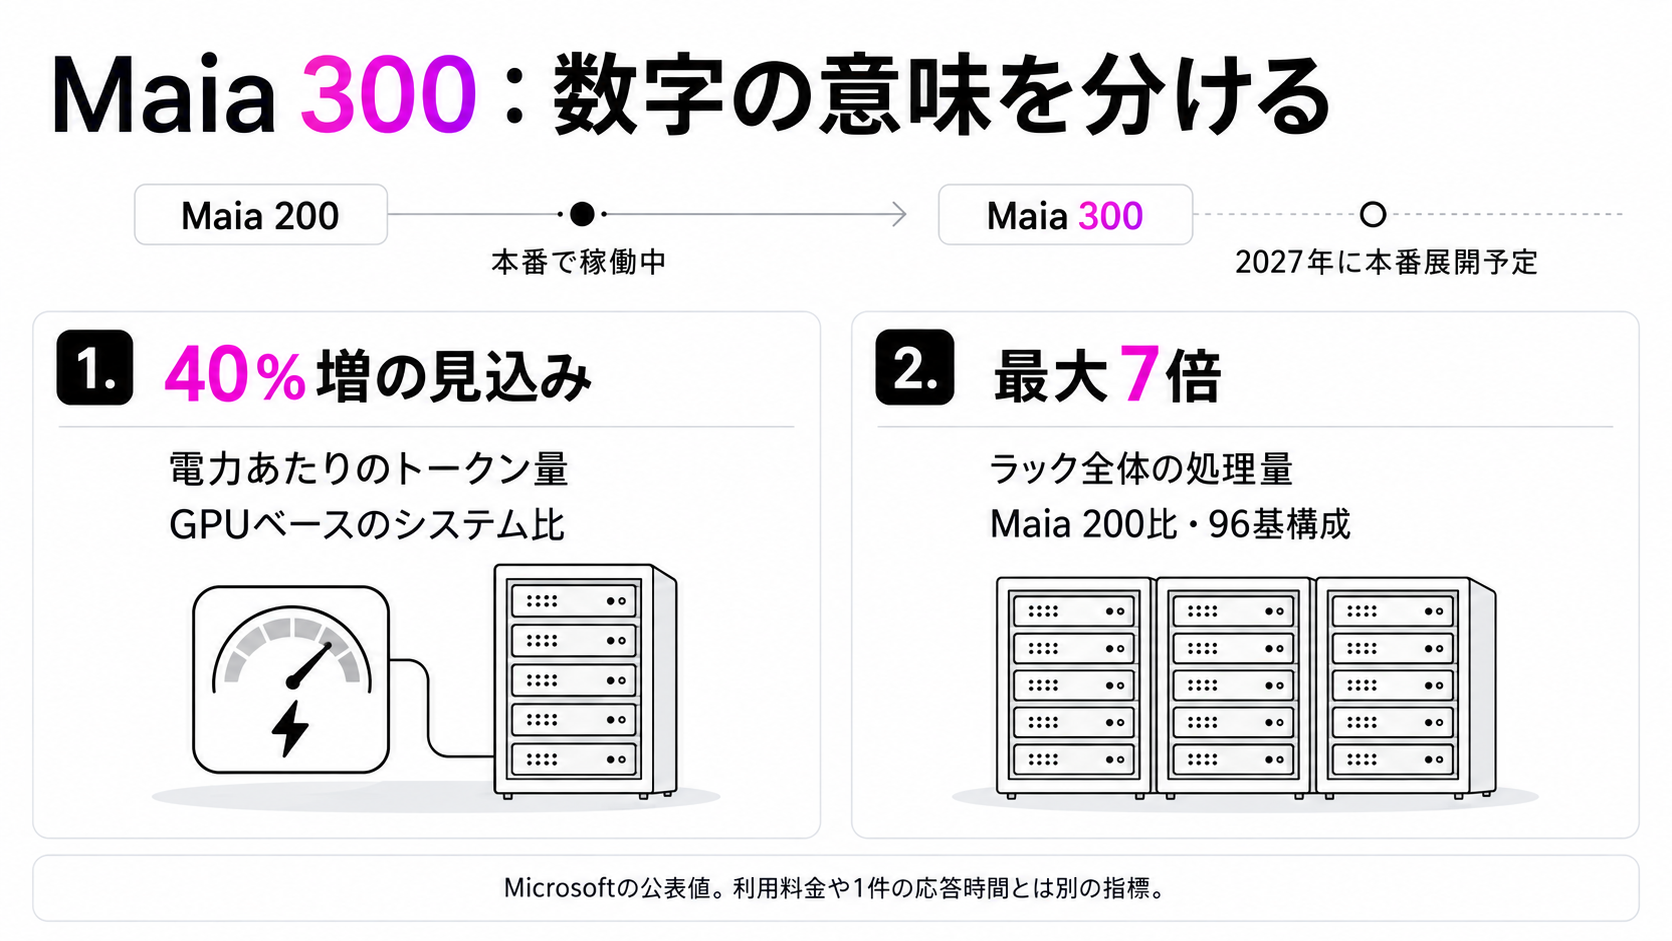
Microsoftは10月12日、自社AI半導体「Azure Maia」を2027年から数ギガワット規模で展開する計画を発表しました。Maia 200はすでにMicrosoft Copilotなどの本番処理に使われており、次世代のMaia 300は2027年に本番展開を始める予定です。
Maia 300について、同社は次の2つの数字を示しています。
- •電力1メガワットあたりのトークン量が40%増える見込み:比較対象は主要なGPUベースのシステム。
- •ラック全体のトークン処理量が最大7倍:96基構成で、Maia 200と比較した値。
前者は電力あたりの処理能力、後者は設備全体の処理量です。比較対象も単位も異なります。どちらもMicrosoftの公表値であり、第三者による同条件の比較試験として提示された数字ではありません。Microsoftの発表
コメント:供給能力の改善と、利用者への値下げは別の判断になる
この計画で注目すべきなのは、Microsoftが自社のAIサービスを支える推論基盤を、大規模に増やそうとしている点です。同じ電力で処理できる量が増えれば、サービスを拡大する際の設備面の制約を和らげる可能性があります。
ただし、ラック全体が多くの処理を引き受けられることと、一人の利用者への回答が速くなることは同じではありません。「最大7倍」を、そのままCopilotの返答速度や自社業務の生産性の倍率にはできません。
料金についても、発表にはCopilotやAPIの値下げの約束はありません。AI利用の予算を組む企業にとっては、今回の数字は将来の供給計画を読む材料です。実際の費用や待ち時間が改善するかを判断するには、利用サービスの料金、利用上限、応答時間にどう反映されるかを別に確かめる必要があります。
3. Anthropicが小型AIの自己複製を研究。機器で動く能力と、複製を完遂する能力の間にある差
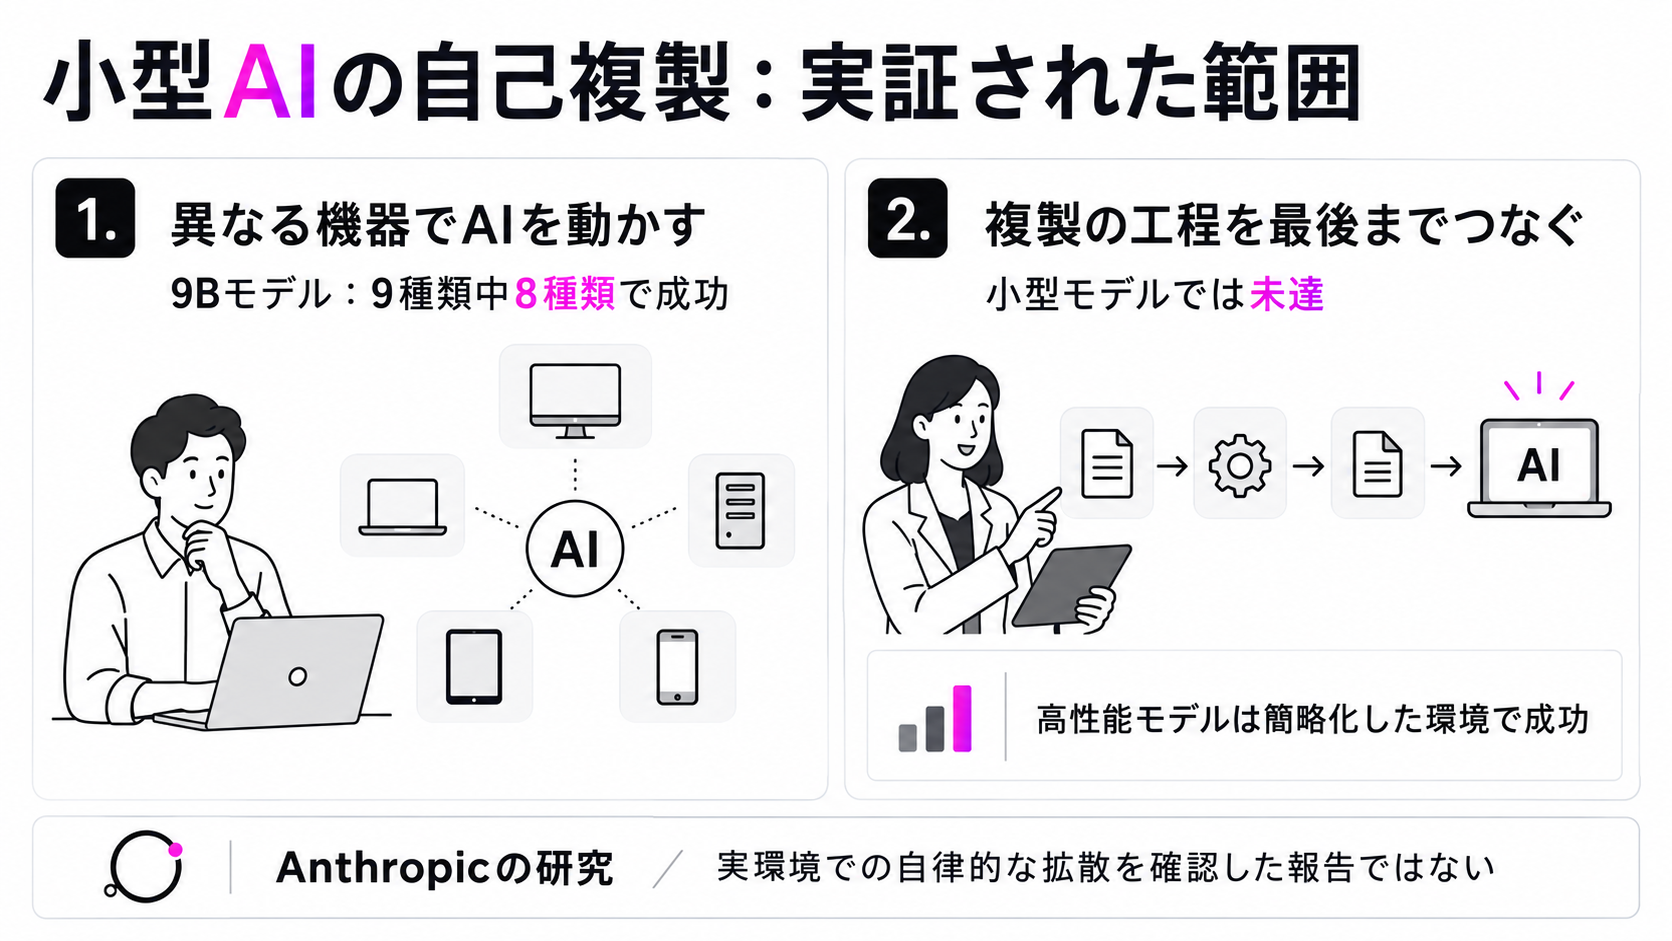
Anthropicは10月12日、小型AIがデータセンター以外の機器で動作し、自律的に複製できる可能性を調べた研究を公表しました。9B規模のモデルは、試した9種類のハードウェアのうち8種類でAIの推論環境を立ち上げられました。
ただし、これは小型モデルが複製の全工程を完遂したという結果ではありません。工程をつなぐ試験で成功したのは、より高性能なGLM-5.2です。その試験では侵入の難しさを大幅に簡略化し、起動する対象を共通のLlama 3.1 8Bとし、指示を出すモデルは別の推論サーバーで動かしています。
つまり、「小型AIを動かせる機器があること」と「その小型AI自身が複製を最後まで進められること」は、まだ別の結果です。実環境で小型AIが自律的に拡散した事件を報告したものではありません。Anthropicの研究報告
コメント:危険性の大きな見出しほど、実験で省いた工程を見る
この研究を読む際は、何ができたかに加えて、試験を成立させるために何を用意したかが重要です。機器へのアクセスが容易な環境、共通の小型モデル、外部の推論サーバーという条件を省くと、実証された能力より広い意味に受け取ってしまいます。
企業の判断に役立つのは、「小型AIの暴走がすでに起きている」という理解ではなく、推論環境を構築する能力が小さなモデルにも広がっているという変化です。AIの利用管理をクラウドのアカウントだけで考えている場合、社内端末や接続機器でどのプログラムが動くかという従来の端末管理も、引き続き関係します。研究上の可能性と実際の被害を区別したうえで、管理対象を考える材料にできます。
Link AIでは、業務に合うAIの選定や導入効果の検証を支援するAIアセスメントを提供しています。性能と費用を踏まえ、自社でAIに任せる範囲を整理したい方は、お問い合わせください。