Grok Voice 3.0とTimestralの評価を読む。NVIDIAのローカルAI、Copilot法務機能も公開
1. Grok Voice 3.0、音声でのタスク遂行が改善。応答開始の速さとは分けて評価する
xAIは10月14日、音声を直接受け取り、音声で応答する「Grok Voice 3.0」を公開しました。APIの料金は前モデルと同じ1分0.08ドルです。常に最新モデルを指す grok-voice-latest も3.0へ切り替わっており、この指定で利用しているシステムでは、コードを変えなくても使用モデルが変わります。公式発表
総合評価は上昇。ただし、すべての項目で首位ではない
外部評価機関Artificial Analysisの音声モデル総合指数は、前モデルの81.3から86.9へ上昇しました。特徴的なのは、会話しながらツールを使い、規則に従って手続きを完了する「τ-Voice」の改善です。
| 評価対象 | Grok Voice 2.0 | Grok Voice 3.0 | GPT-Live-1(Astra、Medium) |
|---|---|---|---|
| 音声モデル総合指数 | 81.3 | 86.9 | 83.2 |
| τ-Voiceのタスク完了率 | 56.5% | 71.6% | 74.5% |
| 最初の音声までの時間 | 0.70秒 | 0.81秒 | 1.34秒 |
τ-Voiceは模擬顧客対応の結果を評価します。一方、応答時間は別の課題であるBig Bench Audioで測った値です。また、τ-Voiceはモデルによって試行回数が異なり、GPT-Live-1のこの設定は1回の評価です。表は同一設定で一斉に測り直した結果ではありません。Artificial Analysisの評価と条件
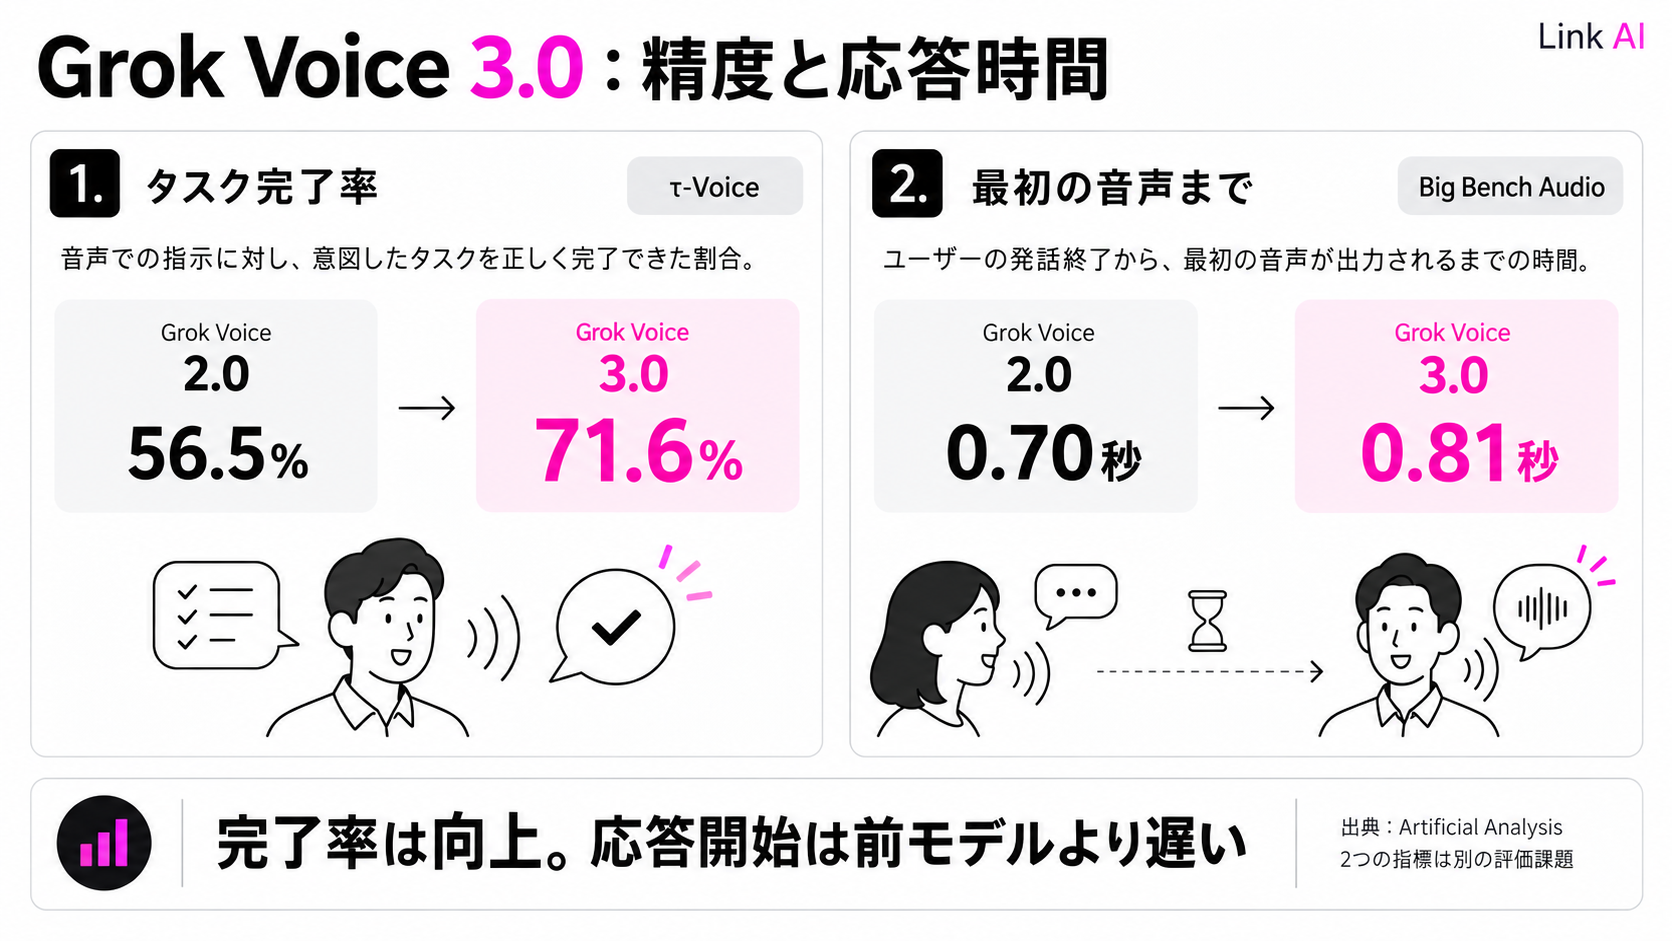
Grokの完了率は15.1ポイント改善していますが、GPT-Live-1の上記設定には届いていません。応答開始も前モデルより0.11秒遅くなっています。今回の変化は、あらゆる軸での高速化というより、低い遅延を保ちながら複雑な手続きを成功させる能力が伸びた、と読むのが適切です。
コメント:会話を遮れたことと、処理を止められたことは別
具体的な試用例も出ています。開発者Cynxio氏は、注文内容の変更、雑音、間、インドネシア語への切り替えを含む固定シナリオを試し、変更していない注文項目を保持できたと報告しました。ただし、録音した合成音声による小規模な試験で、実店舗のマイクや反響を通した試験ではありません。
特に参考になるのは割り込みの扱いです。この試験では、利用者が話し始めた際にクライアント側が音声再生を止めましたが、サーバー側の生成はすでに終わっていました。つまり、再生を止めた実演から、生成や会話履歴も正しく取り消せたとは言えません。試用の方法と結果
電話対応に導入する場合、自然に受け答えするかに加えて、顧客が訂正した後の予約・注文データがどうなったかが重要です。今回の性能向上は有望ですが、聞こえた会話、モデルが保持した内容、実際の処理結果を照合して初めて、自社の受付業務に使えるかを判断できます。
2. Timestral公開。Mistralが数値の時系列を予測するモデルへ進出
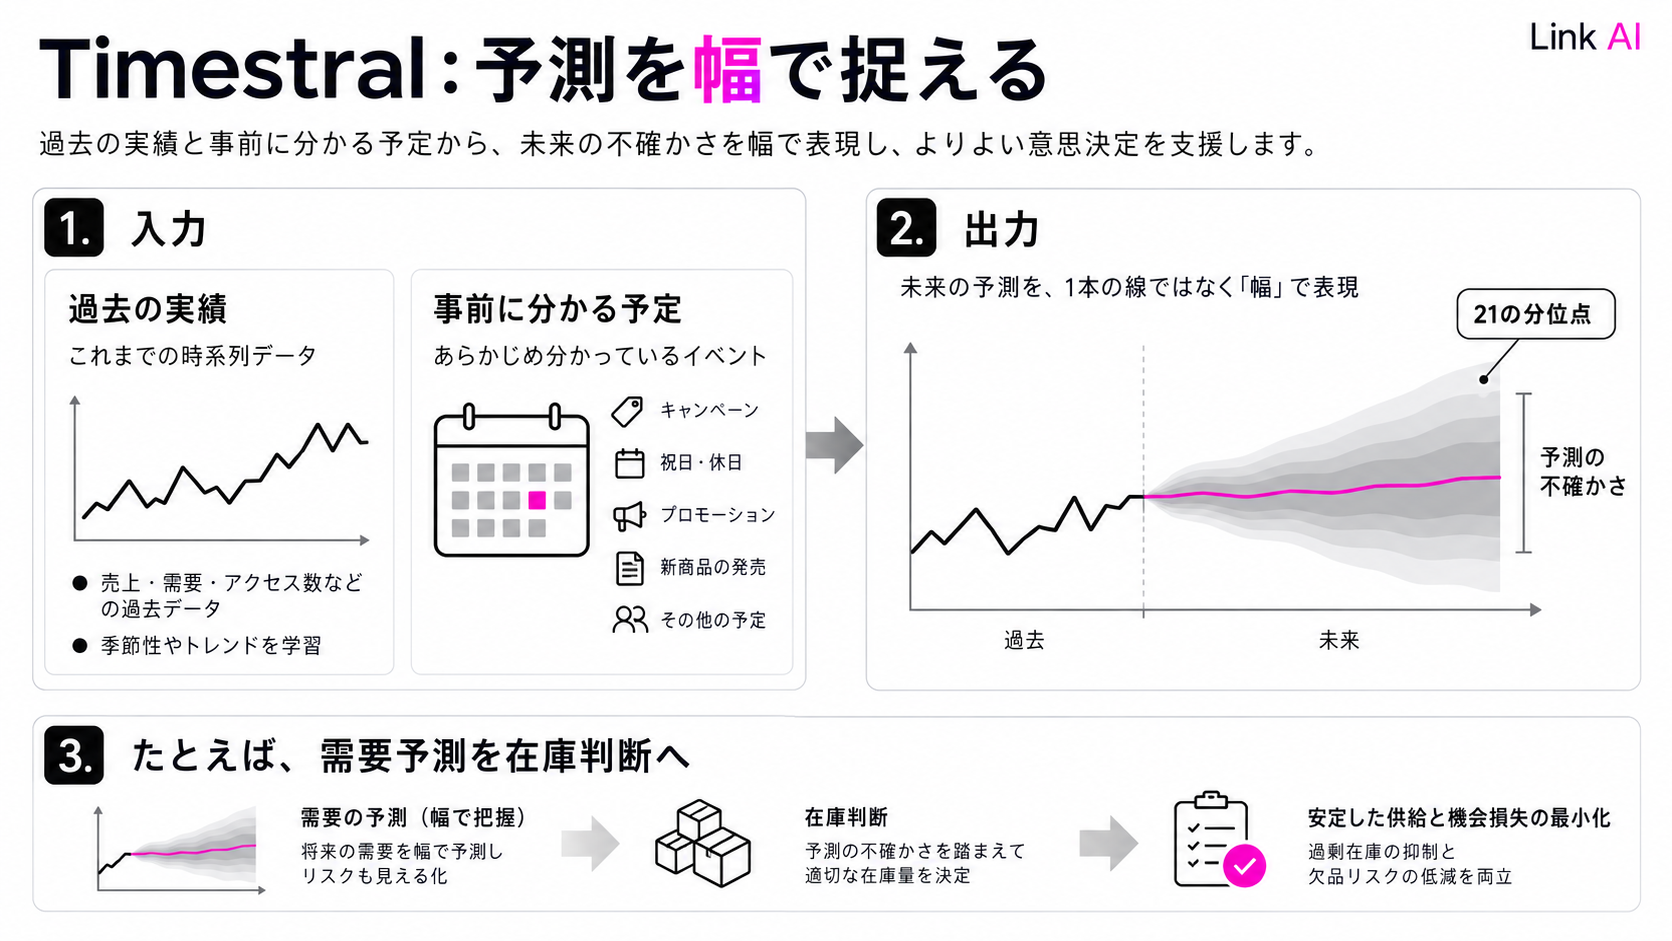
Mistral AIは10月15日、時系列予測モデル「Timestral」を発表しました。文章への回答を生成するモデルとは用途が異なり、売上や設備の計測値など、時間に沿って並ぶ数値から先の値を予測します。500万〜2億900万パラメーターの4種類を公開し、CPUでも実行できる構成です。Mistralの発表
複数の系列を一緒に扱え、過去にしか分からない情報と、将来の予定として事前に分かる情報を入力できます。たとえば需要予測なら、過去の実績に加え、休日や予定済みの販促を条件に含める使い方が考えられます。出力は一つの予測値だけではなく、分布の位置を表す21の分位点です。これにより、予測の幅も検討できます。公開コードと入力・出力仕様
競合との差はあるが、小さい差を「圧倒的」とは読めない
Mistralが公開したモデルカードでは、最大の209M版が事前学習済みモデルを追加学習なしで使う評価で好成績を示しています。GIFT-Evalの公表値を抜き出すと、次の通りです。
| モデル | MASE:点予測の誤差 | CRPS:確率予測の誤差 |
|---|---|---|
| Timestral-209M | 0.658 | 0.446 |
| t0-gamma | 0.661 | 0.452 |
| TimesFM-3 | 0.667 | 0.456 |
| Chronos-2 | 0.698 | 0.485 |
いずれも低いほど良い指標です。MASEは基準となる予測に対する誤差を尺度化し、CRPSは予測した分布と実際の値のずれを評価します。この表はMistralの公表比較であり、独立機関による追試結果ではありません。モデルカード
t0-gammaとの差はMASEで0.003です。集計値で上回ったことと、自社の商品すべてで大幅に改善することは別です。また、Timestral側の評価は最大32,768時点の履歴を使い、GIFT-Evalでは過去の補助変数を利用しています。すべての競合が同じ入力・実行環境だったとまでは、この表から判断できません。
コメント:在庫を減らせるかは、予測の幅が実態に合うかで決まる
確率予測が役立つのは、外れた場合の損失が一様ではないためです。たとえば欠品を避けたい商品と、廃棄を減らしたい商品では、同じ予測分布を得ても選ぶ発注量が変わります。図に示した在庫判断への活用も、予測区間が実際の変動を適切に捉えていることが前提です。
そのため、導入評価では平均誤差だけでなく、繁忙期や欠品時の実績が予測の幅にどの程度収まるかを確認する価値があります。将来の販促情報を使える一方、評価時には、その予測を作った時点で本当に分かっていた予定だけを入力する必要があります。後から確定した情報を混ぜると、実運用より良い成績に見えてしまうからです。
TimestralにはMistralとしての前モデルがなく、比較すべき対象は既存の予測モデルや自社の方法です。公開コードはApache 2.0、モデルの重みはModified MITで、ライセンスも分かれています。CPUで動くことは導入の選択肢を広げますが、処理時間や総費用は系列数・予測期間・実行機器によって変わります。公開時点で技術報告書は予告段階であり、実データでの独立した追試も今後の判断材料になります。
3. NVIDIAがNemotron 3.5 Super VLとBoltを公開。24GBという条件をどう読むか
NVIDIAは10月15日、サーバー向けの「Nemotron 3.5 Super VL」と、ローカルでのエージェント実行を想定した「Nemotron 3.5 Bolt 74B-A9B 24GB」を公開しました。小型の「Bolt E4B 4GB」は10月23日の提供予定で、今回利用可能になったモデルとは区別が必要です。NVIDIAの発表
Super VLは総パラメーター数1,200億のモデルです。Boltはこれを圧縮して総数740億、推論時に働く部分を約90億とし、主な重みを約2ビットに量子化しています。数値の表現を小さくして、24GBのメモリに収める設計です。モデルと推論を補助する小型モデルが公開され、対応するローカル環境で利用できます。Boltの技術説明
速度の公表値には、機器と推論方式が含まれる
NVIDIAは同じRTX Spark機器で比較していますが、モデルごとに量子化方式や先読み生成の仕組みは異なります。公表されたAIPerf SPEED-Bench-Codingの出力速度は、Boltが毎秒83.99トークン、Qwen3.6 35B-A3Bが96.63、Gemma 4 26B-A4Bが100.56、Qwen3.8 27Bが28.26です。Boltはこの中で最速ではありません。
別の指標であるAA AgentPerf Localの処理再生時間も、Boltが600.80秒、Qwen3.6が453.97秒でした。この測定はNVIDIAによるもので、名称にAAが含まれていても、独立機関が同じ機器で追試した結果とは扱えません。速さを比較する際には、モデル名だけでなく、量子化や補助モデルを含む構成を見る必要があります。
外部のArtificial AnalysisはBoltの知能指数を21と評価しています。一方、同ページでは速度・価格の測定値は未掲載です。この知能評価を、そのまま手元の24GB構成の速度保証に置き換えることはできません。Artificial Analysisのモデル評価
コメント:ローカル実行の選択肢は増えるが、24GBあれば同じ結果になるわけではない
今回の価値は、大きなモデルを圧縮し、手元の機器で動かすための重みと推論構成をまとめて提供した点にあります。ただし、公表された速度測定に使われた機器は128GB構成です。「モデルを24GBに収めた」という説明と、「システム全体が24GBあれば公表速度で動く」という意味は同じではありません。
先行利用者からは、Boltを試したところQwenのQ6構成より遅く、品質も劣ったという投稿もあります。ただし機器や課題が十分に示されていない個人の体験であり、モデル全般の優劣を示す根拠にはなりません。利用者の投稿
社外にデータを送らずに処理したい企業にとって、ローカル実行は有力な選択肢です。その場合は、モデル本体に加え、長い入力を処理するためのメモリや他のアプリの使用量まで含め、実際の機器で処理の成功率と所要時間を確かめることが必要です。
4. Microsoft Copilotの法務向け機能が一般提供。Wordの変更履歴までつなぐ
Microsoftは10月15日、20以上の法務向けスキルを含む「Microsoft Copilot for legal」の一般提供を発表しました。従来のLegal Agentを発展させ、Wordでの文書編集や、Coworkでの複数ファイルにまたがる作業に法務向け機能を組み込むものです。
- •契約条文の修正: 提案をWordの変更履歴として扱い、文書の書式を保ちます。
- •ひな型からの作成: SharePoint上の承認済み文書を参照し、編集可能な入力欄を含む文書を作ります。
- •案件資料の整理: 複数の資料から時系列、期限、未解決の論点などを整理します。
Microsoftは対象のCopilot顧客に世界で一般提供すると説明しています。外部サービスのプラグインは順次展開で、すべてが同時に利用可能という発表ではありません。また、定義語と定義の間を移動する新しいWord機能は、今月後半のプレビュー予定です。Microsoftの発表
コメント:「提案が採用された割合」は法律判断の正答率ではない
Microsoftによると、4月の先行提供以来、1,800人以上が約10万件の編集を生成し、提案のおよそ7割を残しました。この数字は、利用者が文書に取り込める提案が出ているという材料にはなります。しかし、法的な妥当性を第三者が採点した正答率ではありません。
契約レビューでは、読みやすい修正文であることと、契約全体や準拠法に照らして適切であることは別です。今回の発表だけで、日本法の契約審査精度や、専門家の確認にかかる時間まで確定したとは言えません。
実務上の変化は、AIの提案を別画面から貼り付ける手間を減らし、既存の文書と変更履歴の中で比較・承認できる点にあります。承認済みひな型や社内基準が整っている組織ほど、その参照元と変更箇所を照合しやすくなります。導入効果を評価するなら、提案の採用数に加え、採用前に見つかった条文間の矛盾や、専門家が修正した箇所を確認する方が、レビュー品質を判断する材料になります。
5. Sakana Chat「My Fish」、記憶の参照元と使われ方を可視化
Sakana AIは10月15日、Sakana Chatの記憶を可視化する「My Fish」を発表しました。9月に導入した記憶機能を見えるようにする更新で、今回初めて会話をまたぐ記憶が加わったわけではありません。
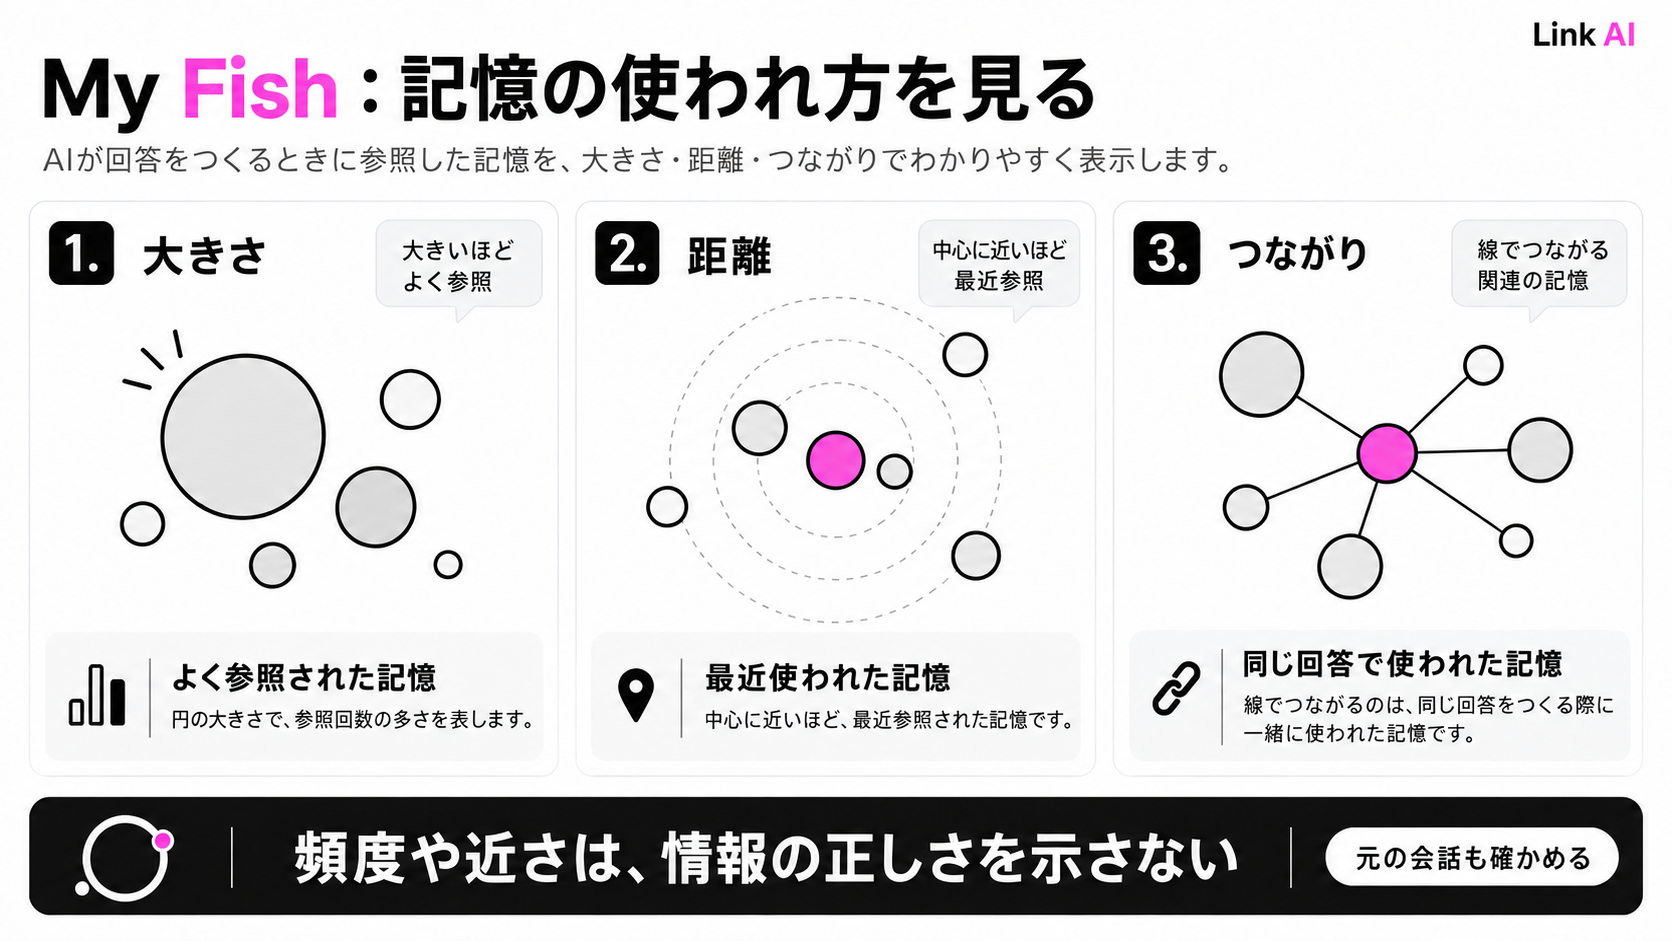
記憶の内容に加え、元の会話、参照回数、最後に使われた時期などを確認できます。図の大きさは参照頻度、中心からの距離は参照の新しさ、記憶同士の線は同じ回答で一緒に使われた関係を表します。30日間使われていない記憶は薄く表示されますが、薄くなったことは削除を意味しません。Sakana AIの発表
コメント:よく使われる前提が、いまも正しいかを確認できる
記憶を参照して回答を作るAIでは、古い前提が繰り返し使われると、説明が一貫していても現状からずれる可能性があります。たとえば担当部署や事業方針が変わった場合、過去の会話に基づく回答が引き続き出てくるかもしれません。
My Fishの表示は、その原因をたどる手がかりになります。ただし、よく参照された記憶ほど正しいわけでも、線でつながった二つの記憶が論理的に整合しているわけでもありません。大きさや距離の意味を理解したうえで元の会話を確認すれば、回答のどの前提を見直すべきかを考えやすくなります。
これはAIの思考をすべて表示する機能ではありません。記憶の参照履歴を確認できることに価値があり、その範囲を理解して使うことが大切です。
Link AIのご案内
Link AIでは、生成AIを活用する業務の整理と、導入効果の検証を支援するAIアセスメントを提供しています。モデルの評価値や提供条件を、自社の業務・設備・費用に照らして整理したい方は、お問い合わせください。