Muse Spark OpenとFLUX 3 Image Klein公開。性能と運用条件を読み解く
Metaは10月15日、モデルの重みを取得して自社環境でも動かせる「Muse Spark Open」を公開しました。同日にはBlack Forest Labsが画像生成・編集モデル「FLUX 3 Image Klein」を発表しています。どちらも運用方法の選択肢を広げる公開ですが、必要な設備や、得意な処理を見極める条件は大きく異なります。
Muse Spark Open:公開された重みと、実際に動かすための設備
Muse Spark Openは、テキストに加えて画像・音声・動画を入力できるモデルです。Metaが8月に発表したMuse Sparkを基に、安全性に関する追加学習を施して公開しています。新しい最上位モデルの重みをそのまま公開した、という位置付けではありません。Metaの発表
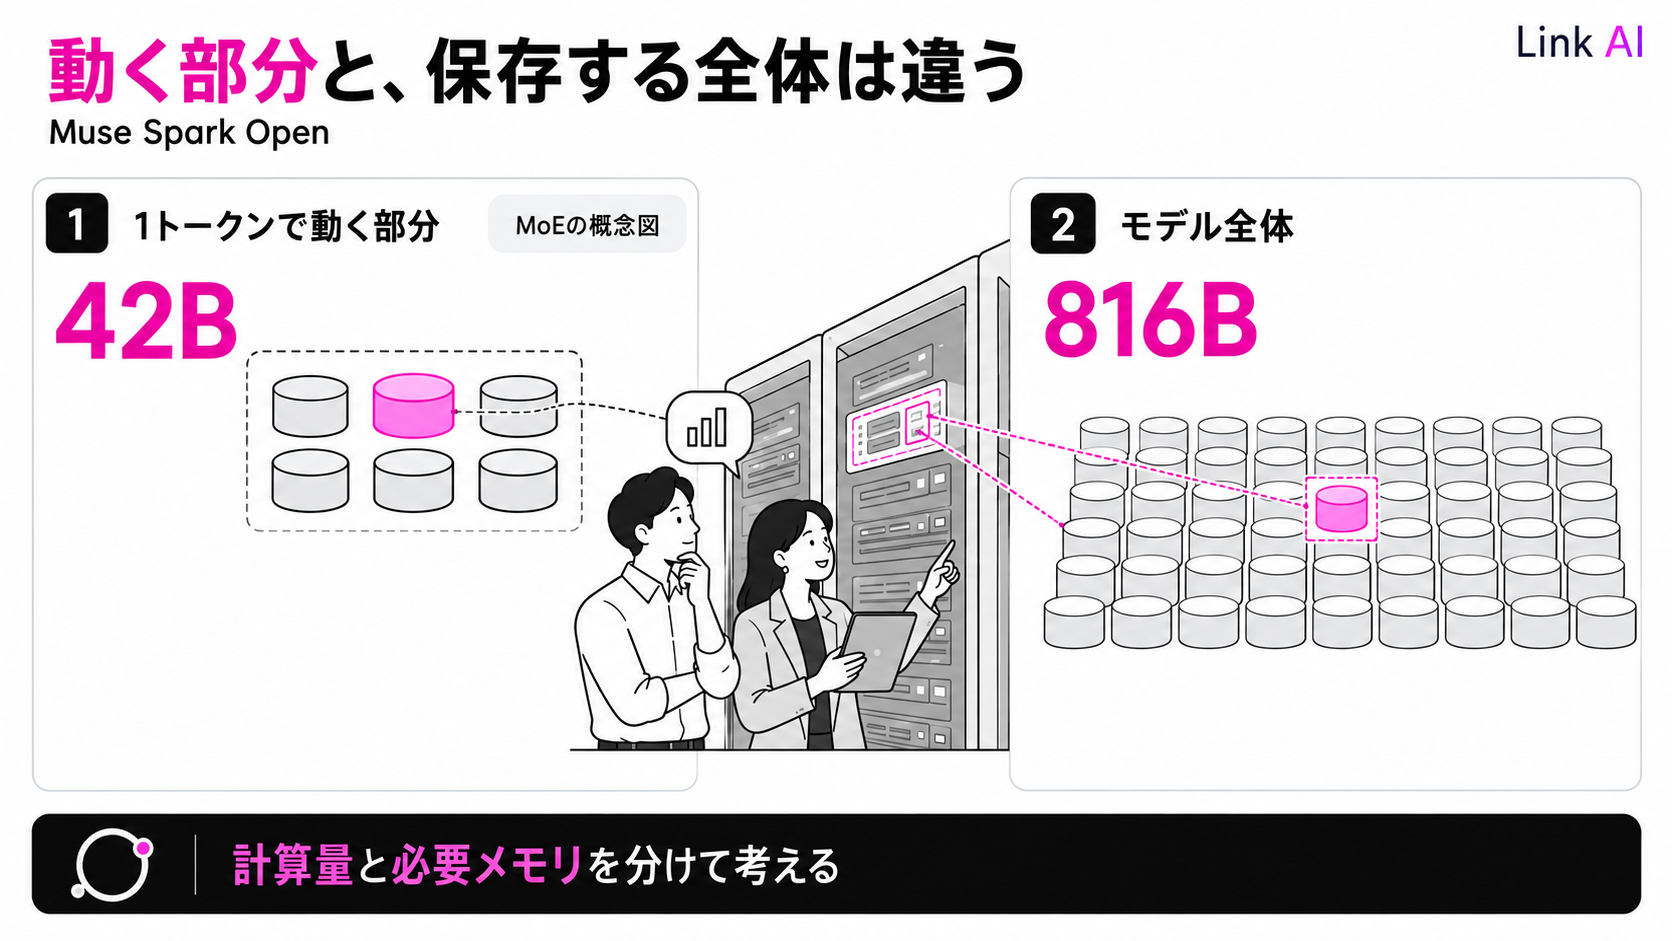
構造は、処理する内容に応じてモデルの一部を使うMoEです。全体のパラメータ数は816B、1トークンの処理で使う部分は42Bです。Bは10億を表すため、それぞれ8,160億、420億に相当します。処理のたびに全体を計算しないことと、モデル全体を保存するメモリが不要になることは別です。
公式資料では、BF16形式の重みだけで約1.65TB、低ビット化したNVFP4形式でも約537GBになります。実行時には、会話の情報や計算途中のデータを置く領域も必要です。モデルカードが示すGPUメモリの目安は、BF16で約2TB、NVFP4でも少なくとも700GBです。42Bという数字だけを見て、一般的な社内PCで動くと考えると、設備の見積もりを誤ります。実行環境の説明、モデルカード
性能も、得意な処理ごとに読む必要があります。Metaの比較表では、端末上でソフトウェアの修正やデータ処理などを行うTerminal-Bench 2.1で、次の結果が示されています。
| モデル・推論設定 | Terminal-Bench 2.1 |
|---|---|
| Muse Spark Open(xhigh) | 76.4 |
| Qwen3.8-2.4T-A95B(xhigh) | 82.0 |
| GLM-5.3(max) | 83.9 |
| Kimi K3(max) | 85.0 |
この4モデルの値は、Artificial AnalysisのTerminus 2エージェントとE2Bの実行環境による評価として、Metaの方法資料に整理されています。推論設定は各モデルで異なり、同じ計算量を与えた比較ではありません。それでも、公開モデルの中でMuse Spark Openがあらゆる処理に最も強い、という読み方はできません。公式比較表、評価方法
別の外部評価として、Artificial Analysisの比較ページでは、Muse Spark OpenとMuse Spark 1.3をともにxhigh設定で掲載し、Intelligence Indexは39と45です。この指数は複数の試験をまとめた指標で、業務の成功率を表すパーセントではありません。同じ設定名でも、実際に使う計算量まで等しいとは限りません。
同ページに掲載されたAPI単価は両方とも100万トークン当たり入力1.25ドル、出力4.25ドルですが、指数を測る課題当たりの費用はOpenが0.84ドル、1.3が1.37ドルです。出力の長さや推論量が異なるため、同じ単価でも課題を終える費用は変わります。これは評価環境のAPI費用であり、自社運用の原価ではありません。Artificial Analysisの比較
今回の価値は、性能順位だけでなく、重みを持って運用を設計できることにあります。ただし、独自ライセンスへの対応も必要です。たとえば、モデルをサービスとして提供する事業で所定の売上条件を超える場合には、別途契約が求められます。自社利用と再提供では条件が異なるため、用途に応じた確認が欠かせません。ライセンスを含むモデルカード
外部サービスにデータを渡せない用途では、重みを保有できる意味は大きくなります。一方、少量の処理を行う企業では、設備・保守の固定費が判断を左右します。「重みを入手できるか」「必要な仕事をこなせるか」「その仕事量で運用費が見合うか」を分けると、公開の意義を自社の条件に照らして捉えやすくなります。
FLUX 3 Image Klein:安く作れることと、条件どおりに作れること
Black Forest Labsが10月15日に発表したFLUX 3 Image Kleinは、文章からの画像生成と画像編集に対応します。最大10枚の参照画像や、配置範囲を指定するバウンディングボックスを扱えます。画像生成部分は5.6Bパラメータで、文章を解釈するモデルはこの数に含まれません。APIの開始価格は、1K解像度の画像1枚につき0.009ドルです。公式発表
同社の内部評価では、FLUX.2 [klein] 9Bに対して、生成で91、編集で70のElo上昇を報告しています。Eloは比較対象との相対的な評価で、業務の成功率ではありません。従来版からの改善という公式主張と、外部の検証結果は分けて読む必要があります。
軽量化は自社環境で扱う際にも利点がありますが、動作条件を揃えずに速度を比べることはできません。公式発表のRTX 5090で約4秒という値は、1024×1024、16ステップ、INT8という条件で測定した生成処理の時間です。4K画像の完成まで、通信や読み込みも含めて4秒で済むという意味ではありません。
公開重みのモデルで使える配置範囲の指定は、指定外の領域を絶対に変えない仕組みではありません。モデルカードは、範囲を越えて内容が描かれたり、編集で指定していない部分が変わったりする可能性を説明しています。一方、BFLのAPIには未編集領域を復元するpixel restorationが含まれると説明されています。公開重みを動かす場合とAPIを使う場合では、この補助処理も含めて、商品画像のどの部分を保てるかを確認する必要があります。モデルカードの制約
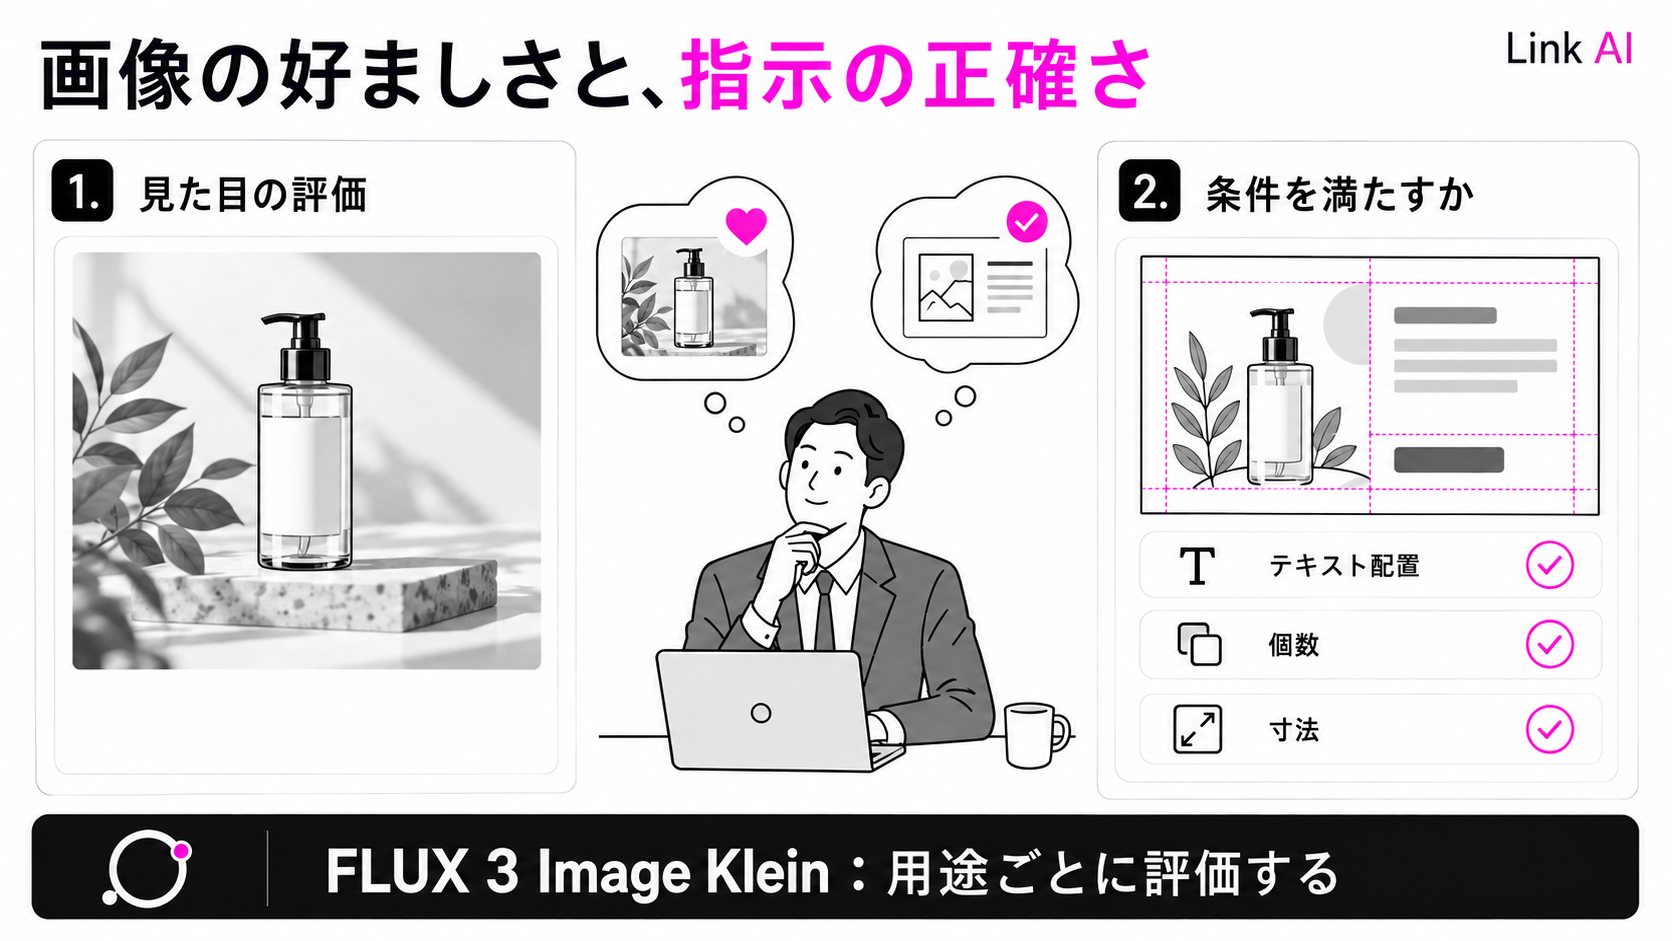
外部の独自テストにも、用途による違いが現れています。Kingy.aiのテストでは、蒸留版Kleinは画像生成32枚中24枚、編集12枚中12枚が、出力ごとに設定した4条件をすべて満たしました。同じテストのNano Banana 2.1は、生成で32枚中31枚でした。ただし、判定はGPT-6 Lunaによる自動採点で、モデルごとに品質設定や解像度が異なります。少数の課題による、特定の提供環境の結果です。モデル全般の正確さの順位とは区別する必要があります。テスト内容と採点方法
先行利用者の声にも両面があります。写真家を名乗る利用者は、画像編集で人物の姿勢やカメラ位置を保つ点を評価する一方、文章からの生成には期待ほどの改善を感じなかったと報告しています。これはRTX 5090で高解像度画像を扱った個人の体験であり、一般的な成功率を示すものではありません。本人の投稿
広告や商品ページで使うなら、「見栄えがよいか」と「文字・個数・位置・変更しない部分を守れるか」を別々に確認する価値があります。低い生成単価は案を多く試す用途に向きますが、採用できる画像が少なければ、再生成や手直しの費用が増えます。Kleinの評価では、完成した画像1枚を得るまでの作業を含めて比べることが重要です。
Anthropicの社内雇用調査:AIの稼働時間は、人の仕事を置き換えた量ではない
Anthropicは10月16日、社員のAI利用や採用、仕事の成果を調べた社内研究を公開しました。技術職の新規採用に占めるジュニア層の比率は27%から9%へ下がった一方、技術職の採用人数自体は増えています。比率の低下を、そのまま雇用人数の減少と読むことはできません。研究本文
同研究は、8月の対話型AIの稼働時間を人の労働時間の約6倍としています。AI側は並列のエージェントも含めた稼働時間、人側は社員数と週40時間から推計した時間です。AIが6人分の仕事を代替した、あるいは生産性が6倍になったという測定ではありません。 また、一社の観測研究であり、AIだけが採用や成果の変化を引き起こしたと断定できる設計でもありません。
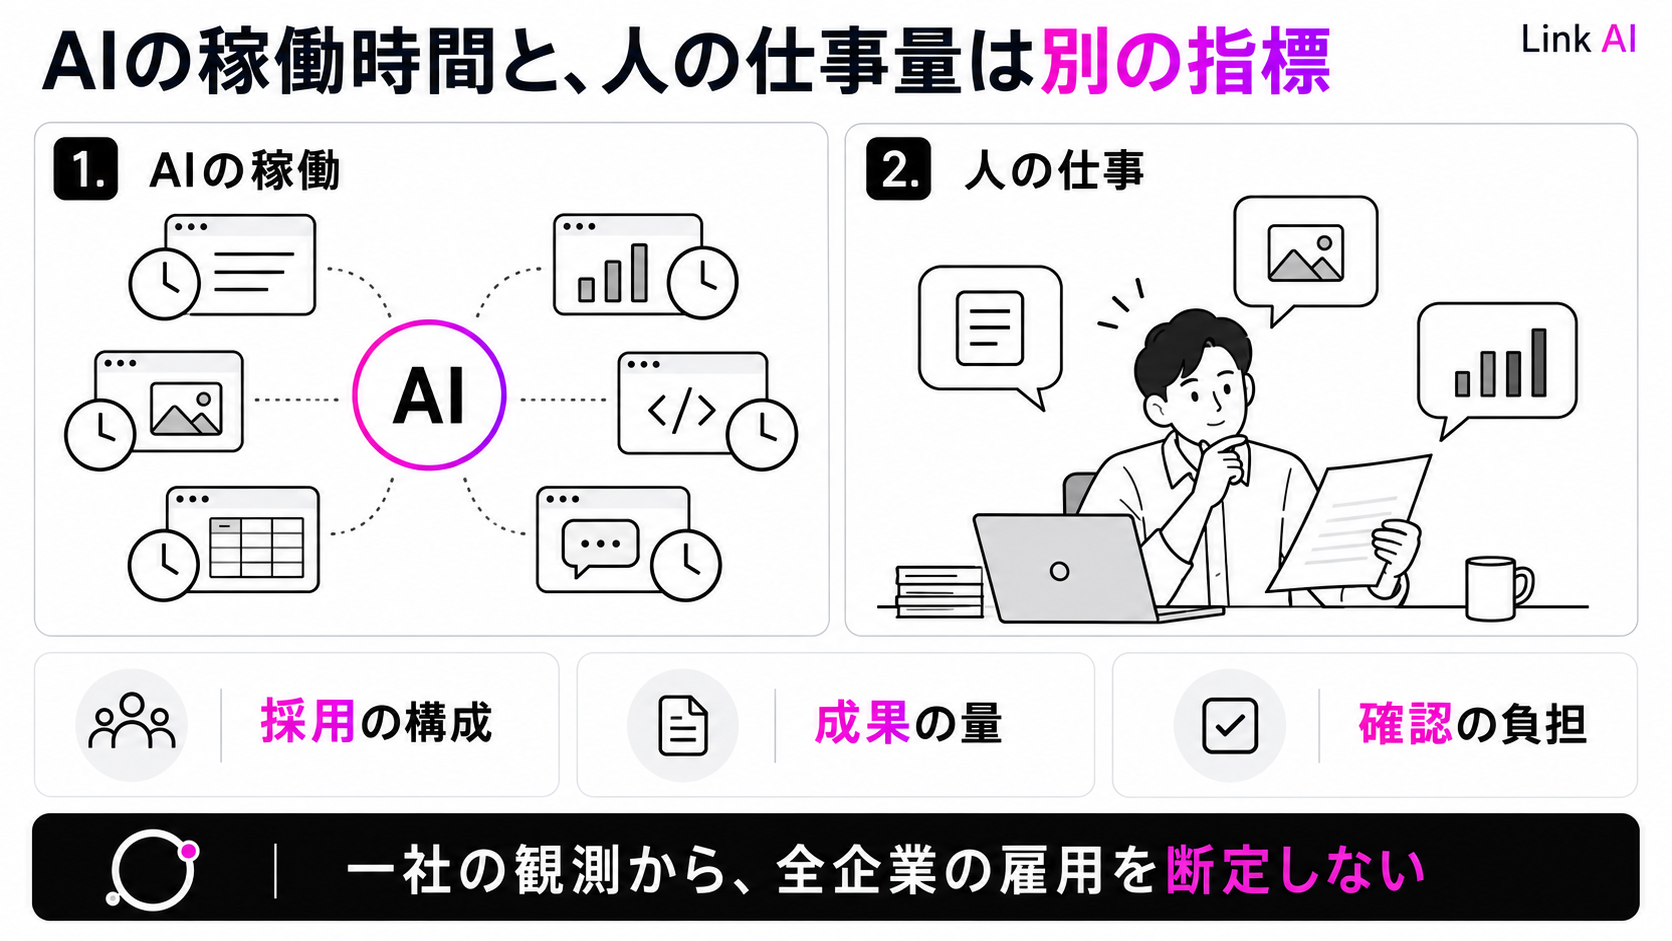
この調査から考えたいのは、作業が増えるときに人の役割がどこへ移るかです。AIの実行時間だけが伸びても、成果物を確認できる人が不足すれば、使える成果は同じ割合では増えません。自社で同様の変化を見るなら、稼働時間に加えて、採用した成果物の量、確認・修正にかかった時間、経験の浅い人が判断力を身につける機会を捉える必要があります。それぞれが別の変化を示すためです。
Claude Code Reviewが一般提供:確認の速度と、品質を保証する仕組みを分ける
Anthropicは10月15日、GitHub上のコード変更をレビューするClaude Code Reviewを、Team・Enterprise向けに一般提供しました。研究プレビューで約20分だったレビューを、多くの場合6〜10分で終えると説明しています。Quick・Standard・Deepから、レビューの深さを選ぶ機能も用意されました。速度の改善は同社の発表値で、すべての変更に同じ時間短縮が保証されるわけではありません。一般提供の発表
| 確認したいこと | Code Reviewの仕様 |
|---|---|
| どこで処理するか | Anthropicが管理する環境 |
| コードを実行するか | 読み取って調べる。ビルドや実行はしない |
| 変更を承認するか | 承認やマージの阻止は行わない |
| 費用に何が含まれるか | プランの付属利用枠とは別の、トークン利用量による課金 |
既にローカルでコードをレビューする方法はあり、今回初めてAIによるレビューが可能になったわけではありません。一般提供の意味は、組織が対象リポジトリや実行頻度を設定し、GitHub上の変更確認へ組み込みやすくなった点にあります。
ただし、コードを読んで問題を探す工程と、動かして期待どおりの結果を確かめる工程は異なります。指摘がなくても、テストに通ることや安全に公開できることの証明にはなりません。レビューの待ち時間が短くなる効果を確かめる際も、見つかった不具合、誤った指摘への対応時間、実行テストで初めて分かった問題を分けて見る必要があります。
費用にも同じように、1回の深さと回数という二つの要因があります。管理画面から追加したリポジトリは、初期設定ではpushのたびにレビューが走ります。細かい修正を何度も送る開発方法では、PRの件数だけでは利用料を見積もれません。レビュー回数と深さを設定し、組織単位の上限を使うことで、必要な確認に費用を配分できます。実行頻度と費用管理
Link AIのご案内
Link AIでは、生成AIを活用する業務の整理と、導入効果の検証を支援するAIアセスメントを提供しています。モデルの評価値や提供条件を、自社の業務・設備・費用に照らして整理したい方は、お問い合わせください。