DeepSeek 1017の性能差、ChatGPTの並列化、Glimpseの視覚推論
DeepSeekは10月17日、開発向けの性能を高めた「DeepSeek-V4.1-Flash-1017」を公開しました。Web・アプリ・APIが更新され、検索とページ取得のAPIも一般向けに開放されています。モデルの呼び出し名が同じでも応答が変わる更新だけに、開発責任者にとっては、料金だけでなく既存システムの成功率を見直す契機になります。DeepSeekの発表
DeepSeek 1017:開発評価は向上、利用者のテストでは品質が横ばいの項目も
新モデルはAPIの deepseek-flash から利用でき、推論料金は据え置きです。重みもMITライセンスで公開されました。DeepSeekはプロジェクト開発の改善に加えて、出力の短縮とタスク完了の高速化を説明しています。ただし、これらは提供元の主張であり、すべての開発作業に同じ改善幅を保証するものではありません。
公式の比較表では、次のように評価項目によって差が出ています。
| 評価 | 前のV4.1 Flash | 1017 | Claude Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | 74.0 |
| ProgramBench | 20.3 | 29.1 | 37.0 |
Terminal-Benchは端末操作を伴う課題、DeepSWEはソフトウェア修正、ProgramBenchはプログラム開発の能力を見る評価です。表はDeepSeekが掲載した値で、単位は各評価のスコアです。1017のTerminal-BenchにはClaude Code、DeepSWEにはMini-SWE-V2という、モデルにツールを使わせる実行環境を用いています。前版・競合の設定がすべて一致する対照試験とは確認できないため、差をモデル単体の改善率として扱うことはできません。また比較対象のOpus 5は、最新のOpus 5.5ではありません。モデルカード
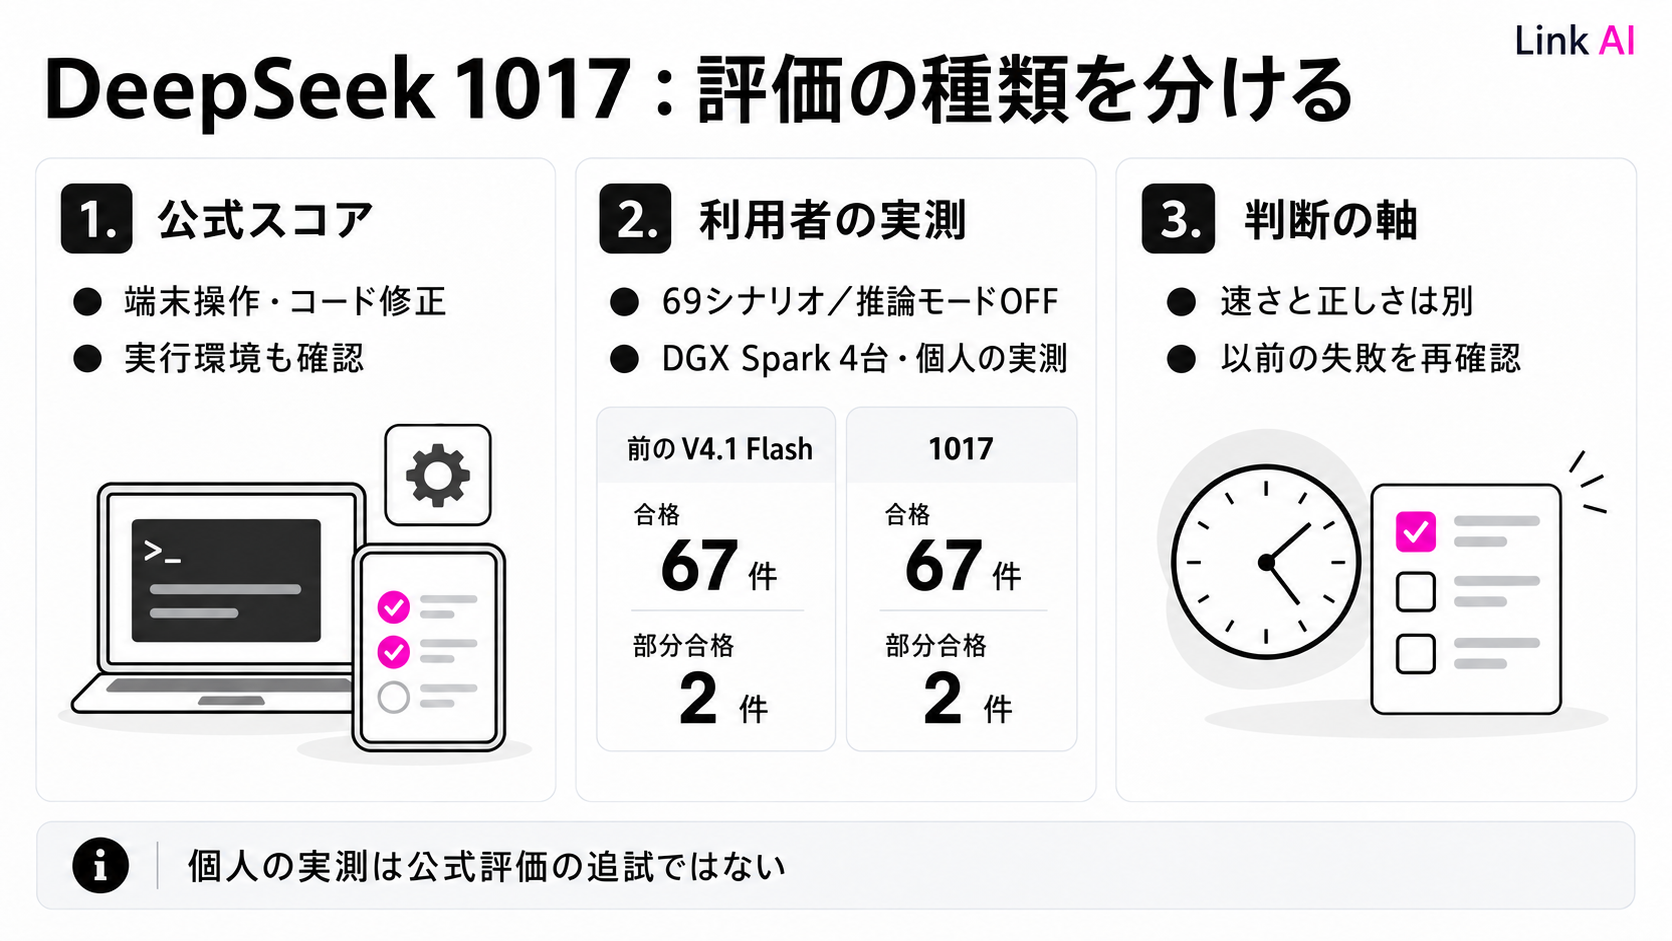
注目すべきなのは、DeepSWEで競合を上回っていても、端末操作やプログラム開発では競合が優位な項目が残ることです。「開発全般で最強」とまとめるより、保守・修正と新規開発を分けて読むほうが、選択の根拠になります。
外部の具体例として、GitHub利用者のtonyd2wildは、DGX Spark 4台で新旧モデルを動かした記録を公開しています。推論モードをオフにした69シナリオでは、新旧とも67件が合格、2件が部分合格でした。意図を確認せず推測したケースなどが、更新後も残っています。応答時間の中央値は1,620ミリ秒から1,287ミリ秒に短くなりましたが、推論基盤の最適化も加わっているため、短縮分をすべて重みの更新に帰することはできません。利用者の実測と設定
この実測からは、速さと正しさが別々に変わり得ると分かります。自社で使っている開発エージェントも、完了時間が短くなっただけで採用を決めず、以前つまずいた修正が通るかを同じ課題で確かめる意味があります。なお、この個人の69シナリオは公式ベンチマークの追試ではありません。1017を明示した第三者機関の総合評価は未確認です。
料金は100万トークン当たり、オフピークでキャッシュ非命中の入力0.15ドル、出力0.60ドル。ピーク時は各2倍です。ピークは中国の祝日を除く平日の日本時間10〜13時と15〜19時なので、日本の業務時間に利用する場合は最安値だけで試算しないことが大切です。公式料金表
同時公開のSearchとFetchは、それぞれ検索結果とWebページの内容を得るAPIです。各1,000回の成功リクエストにつき0.75ドルで、検索が空振りした場合や失敗・タイムアウトは課金されません。検索してから本文を取得する場合は別々の呼び出しになります。DeepSeek APIをDeepSeek Harness・Claude Code・Codex経由で使うサーバー側の対象ツール呼び出しには無料期間があり、発表では日本時間11月1日01:00に課金開始とされています。通常の直接API呼び出しまで無料とは読み替えられません。Search & Fetchの仕様/課金開始の発表
ChatGPT:Proの並列エージェントと、共同編集できるSlides
OpenAIは10月16日、ChatGPTのChatタブにあるGPT-6 Proの更新を発表しました。応答の高速化、プラグイン・ツール利用の改善に加え、一つの依頼を複数エージェントで並行して進める機能を導入しています。会話から進捗を追い、完了した個別タスクを開いて内容を確認できます。対象は提供条件を満たすProユーザーで、組織ではワークスペースの設定と展開状況にも左右されます。
同日の「ChatGPT Slides」は、Spaceでプレゼンテーションを作成・編集し、メンバーと同時編集やコメントを行う機能です。文字・画像・図形・グラフを直接直せるほか、WebではPowerPoint、PDF、Google Slidesへ書き出せます。こちらはSpaceへのアクセスがある対象のPro・Business・Enterpriseユーザーへ順次提供されます。OpenAIのリリースノート
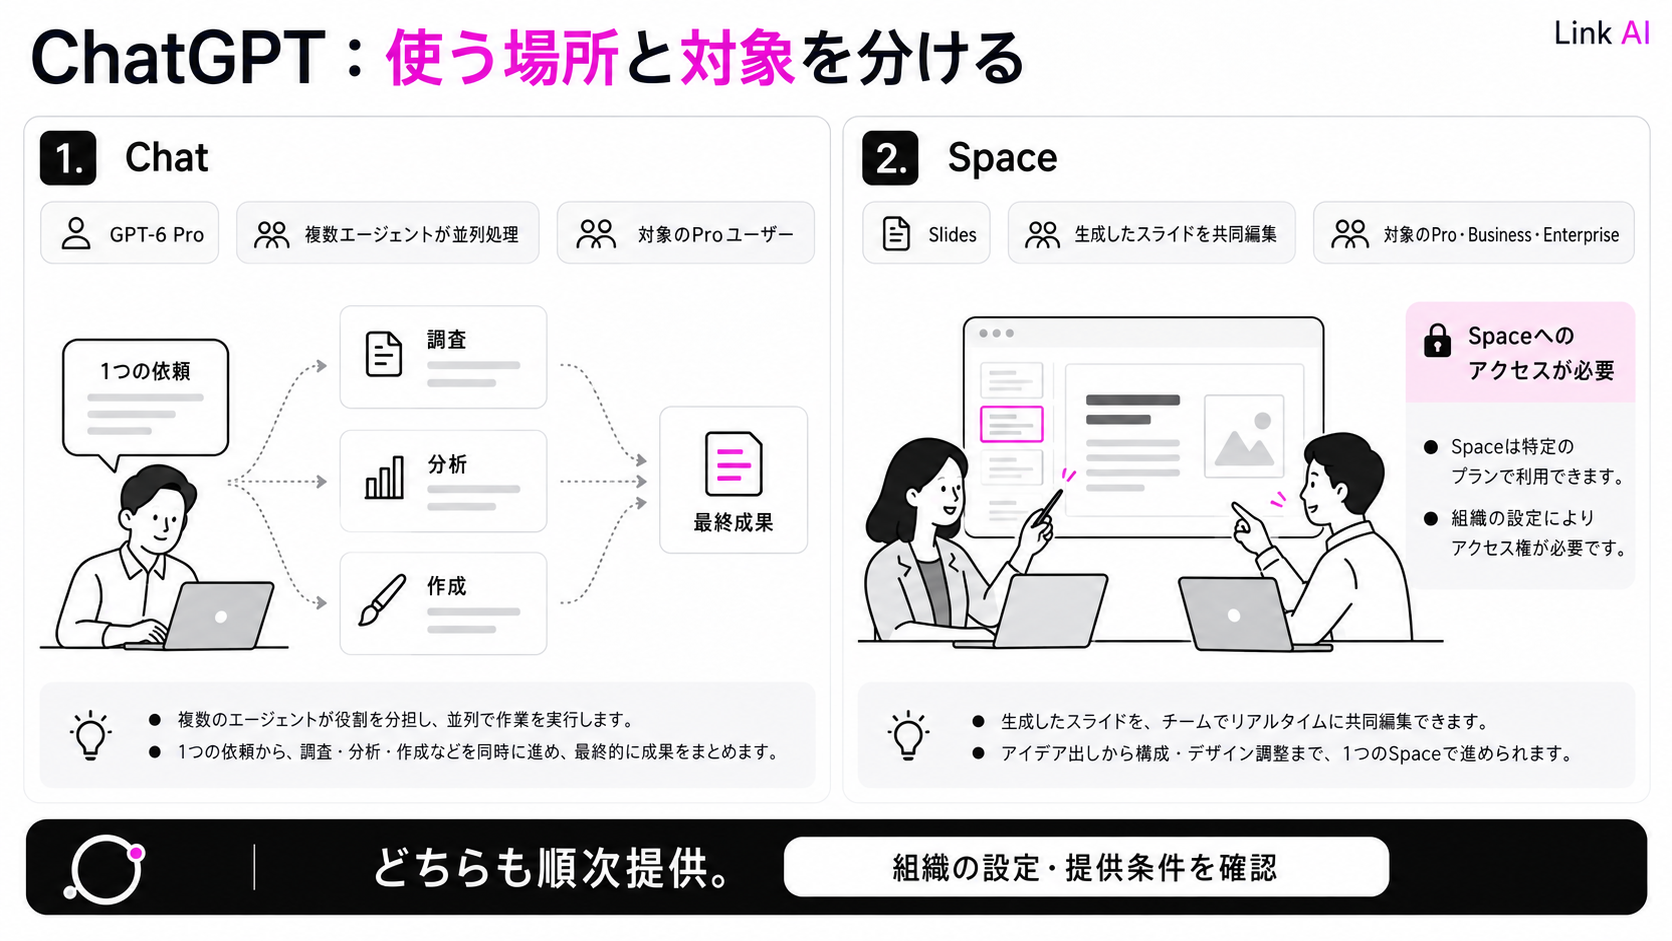
二つの更新は、利用場所も対象も異なります。並列エージェントは作業の進め方、Slidesは成果物を人が編集・共有する場所の変更です。「ChatGPTで使える」という説明だけでは、組織の全員が同じ機能を利用できるとは判断できません。
並列化は、互いに独立した部分を進めるときに待ち時間を減らせる仕組みです。一方、前の結論を次の作業が使う依頼では順番を待つ必要があり、複数の結果を合わせる確認も残ります。今回の発表には、何倍速くなったかという共通条件の測定値や、並列数に応じた消費量の説明はありません。新しいAPIモデルの提供を示す発表とも区別する必要があります。
外部メディアKingy.aiは10月16日、同じ調査依頼を逐次処理と3エージェントの並列処理で2組試しています。画面に表示された所要時間は、1組目が4分46秒対4分56秒、2組目が4分56秒対3分54秒でした。並列化しても遅い試行があり、正確さの明確な差も報告されていません。一つのアカウントで計4回の観測なので、平均だけを一般的な改善率にするのは早計です。同記事は個別タスクの成果を開けた一方、完了後も活動欄に未出力表示が残ったことも報告しています。試行条件と結果
Slidesの意義は、生成した初稿を共同編集へつなげられる点にあります。スライドの生成や共同編集そのものが初めて可能になったわけではありません。Spaceを使うチームで、AIへの修正依頼と人による細部の編集を同じ成果物に対して続けられることが、今回の具体的な変化です。Slidesのレイアウト再現性について、独立した比較試験は未確認です。
Glimpse:画像を見直す推論は、低い単価とセットで評価する
Elorianは10月16日、画像・動画の推論モデル「Glimpse」を研究プレビューとして発表しました。途中で画像の一部や動画の区間を見直し、解釈を修正する設計です。APIとチャット画面が案内されていますが、即時に使えるかはアクセス条件の確認が必要です。入力は100万トークン0.60ドル、出力は3ドル。オープンな重みを持つ基盤モデルを追加学習したという説明は、Glimpse自体の重み公開を意味しません。
同社の表では、科学図表を読むCharXiv-RでGlimpseが92.90、GPT-6 Astraが92.10でしたが、Opus 5.5は93.40です。場面理解のHSSではGlimpseが46.36、Astraが53.6で、優劣は課題によって逆転します。各モデルのツールや推論設定が異なる提供元の評価であり、独立した同条件の比較ではありません。Elorianの発表・評価条件
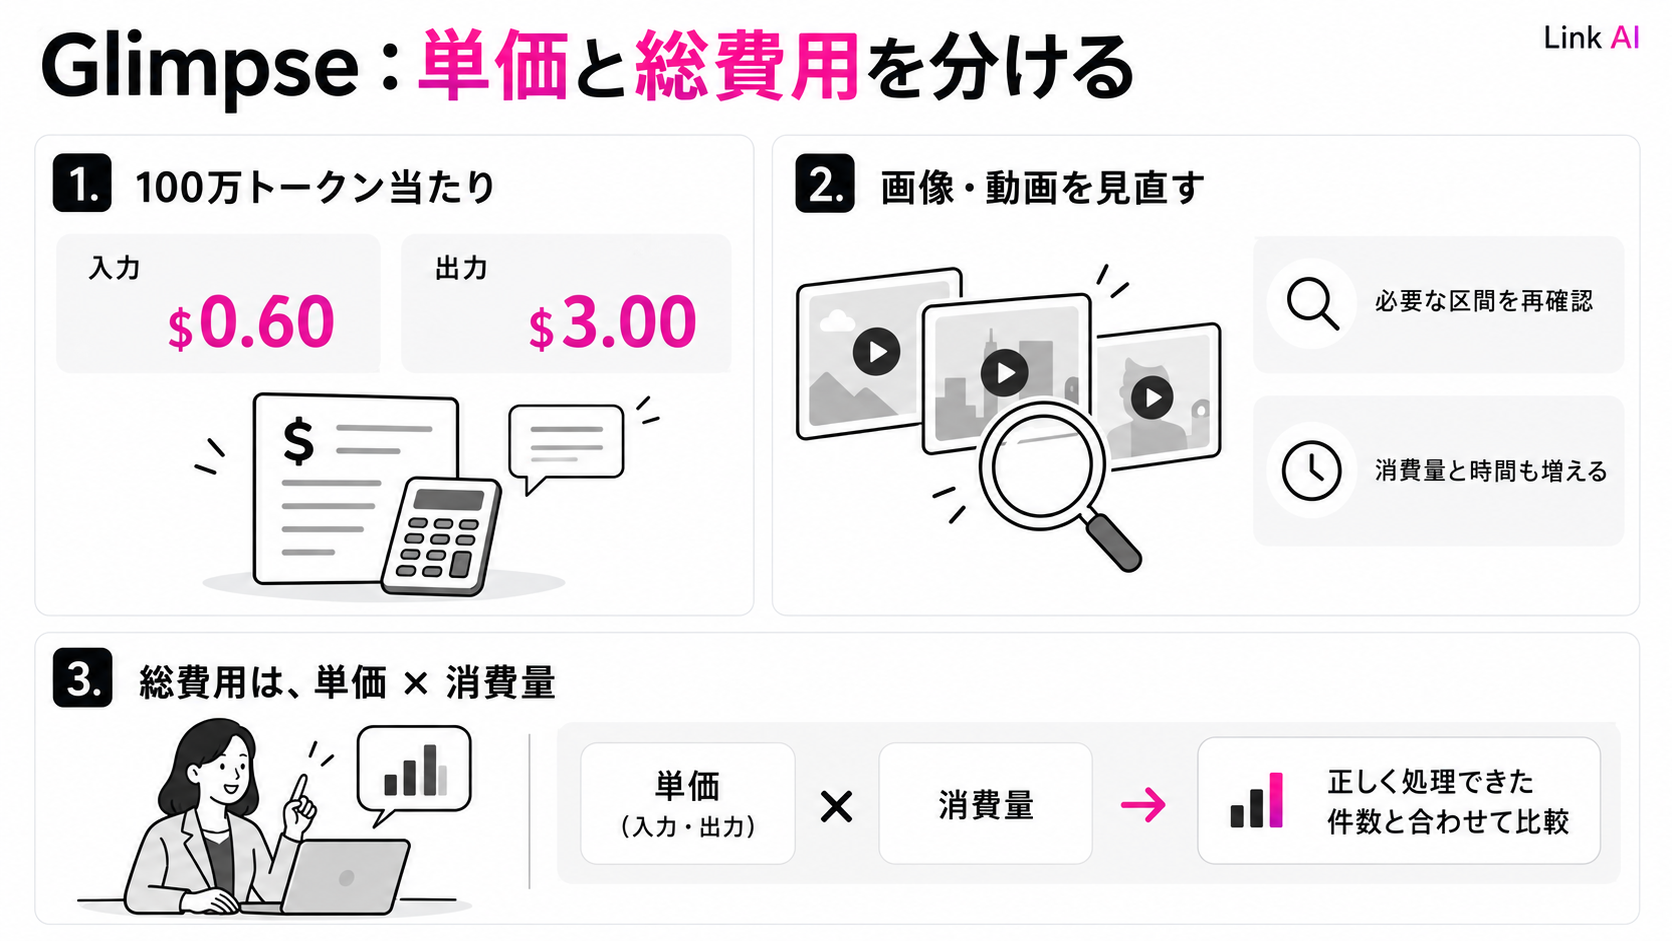
この設計を検討する際には、「画像を受け取れる」と「必要な部分を確かめ直せる」を分けると、評価したい能力が明確になります。たとえば映像の場面転換を調べたい場合、全体の説明が流暢でも、カメラが動いたのか編集で切り替わったのかを誤れば、目的には合いません。答えがどの場面に基づくかまで確認できることに価値があります。ただし、画像の拡大や再確認は他のエージェントでも行えるため、今回初めて実現した機能とは言えません。
費用についても、入力・出力の単価だけでは結論が出ません。見直しが増えると、読み込む情報や推論の量が増えます。安い単価であっても、最終的な支払額はその消費量次第です。比較するなら、同じ画像や映像について、正しく処理できた件数と合計費用を組み合わせて見る必要があります。
外部ではYFarmXが、Glimpseのトークン数え方を実際のAPI応答で調べ、Qwen系と一致する結果を報告しています。ただし、これは基盤との関連を探る測定で、画像認識の正確さを検証したものではありません。視覚タスクの独立した追試や、利用者が公開した再現可能な成功・失敗の比較は未確認です。YFarmXの測定方法と結果
導入判断に向けては、モデルの名前や総合順位から離れ、何を正しく処理したいかを決めることが出発点になります。Link AIでは、その業務に合った評価条件と費用の整理をAIアセスメントで支援しています。