MiniMax M3.1 FlashとMercury 3の実力、MicrosoftのAI権限管理、LINE WORKS電話受付
MiniMax M3.1 Flashが正式公開。低単価に加え、推論量と誤答の傾向を見る
MiniMaxは10月19日、M3.1 Flashを正式公開しました。API、M Plan、MiniMax Codeから利用でき、モデルの重みは後日公開予定です。匿名モデル「Space Bunny」は初期版だったと説明しており、その利用経験を正式版の評価と同一視することはできません。公式発表
100万トークン当たりの料金は、入力0.15ドル、出力0.60ドル、キャッシュ済み入力0.015ドルです。従来のM3は入力が512K以下の場合、入力0.30ドル・出力1.20ドルだったため、この範囲では入出力の単価が半分になります。M3の長文入力には別料金があるので、文脈長をそろえて比較する必要があります。M3の料金表
一度に扱える文脈は100万トークンで、画像・動画入力にも対応します。ただし、この機能自体はM3にもありました。今回の判断材料は、同種の仕事をどの程度の品質と費用で処理できるかです。API仕様
総合評価は上昇しても、すべての仕事で競合を上回るわけではない
第三者評価機関Artificial AnalysisのIntelligence Index v4.3.2では、M3.1 Flashが42、M3が29です。知識・科学・業務・コーディングなどをまとめた指標であり、正答率42%という意味ではありません。同じ指標での改善を示す一方、各モデルの推論設定を同一の計算予算にそろえた比較ではない点は残ります。M3.1 Flashの評価、M3の評価
MiniMaxが示したソフトウェア開発評価DeepSWE v1.1は73.7です。同社の比較表ではDeepSeek V4.1 Flash-1017が77.0で、M3.1 Flashを上回ります。この評価はコードを理解し、修正し、テストで確かめる能力を見るものです。M3.1 Flashの測定にはmini-SWE-agent 2.4.5と最大512Kの文脈が使われています。安い単価で有力な選択肢になったことと、開発能力で一律に首位になったことは分けて読めます。比較表と評価条件
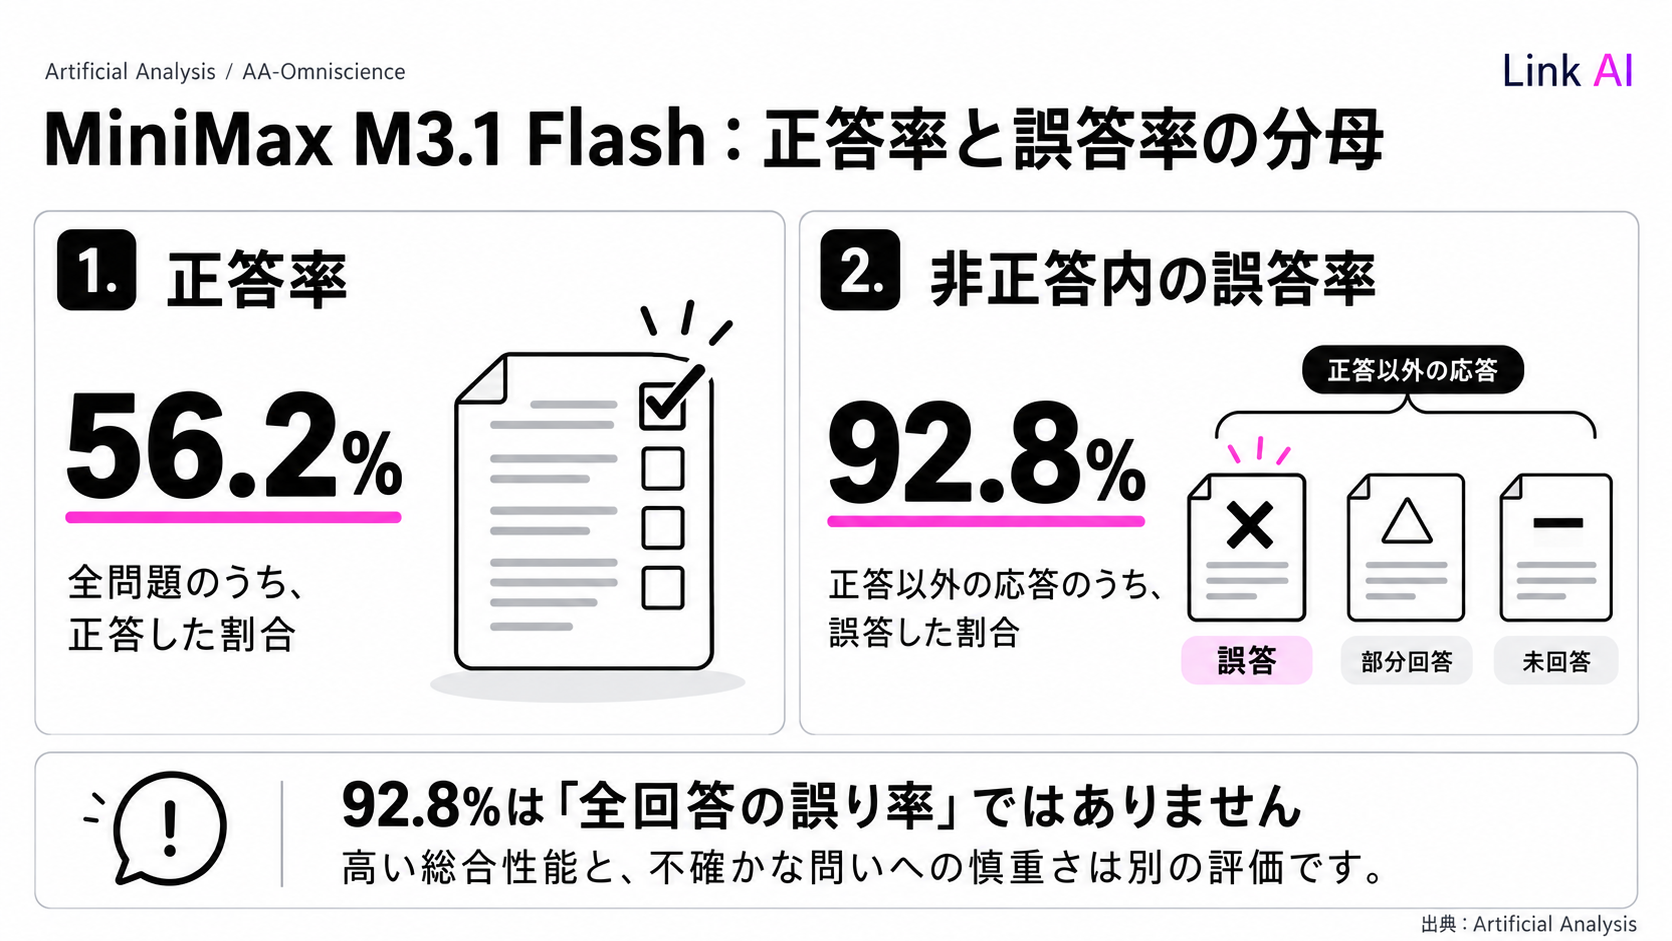
さらにAA-Omniscienceでは、正答率56.2%に対し、正答以外の応答に占める誤答の割合は約92.8%でした。後者の分母は「誤答・部分回答・未回答」であり、全回答の92.8%が誤りという意味ではありません。それでも、答えられない問題で回答を控える傾向が弱いことは、知識をそのまま顧客へ伝える用途では重要です。総合性能が高くても、不確かな回答の扱いまで安心できるとは限りません。評価データ、指標の定義
推論設定で、同じ修正作業の費用と待ち時間が変わる
M3.1 Flashは常に推論を行い、考える深さは5段階で指定できます。省略時は最も深いmaxです。推論を無効にする指定はエラーになり、出力上限には推論トークンも含まれます。短い答えを求めたつもりでも、内部の推論で予算を使う場合があります。公式API仕様
API仲介事業者AIHubMixは、Python関数の2件のバグ修正を各設定で3回実行したと報告しています。設定省略時は平均56秒・0.0045ドル、lowでは9.5秒・0.0006ドルで、どちらも全215件の非公開テストを通過しました。これは同社の接続経路・料金での小規模な実測で、独立した中立評価や難しい開発全般の結果ではありません。ただ、簡単な修正では深い推論を増やしても成果が変わらない具体例にはなります。AIHubMixの実測報告
速度についても、公式の中央値170超トークン/秒に対し、Artificial Analysisの入力1万トークンでの測定は120.1トークン/秒です。条件がそろっていないため差をそのまま性能低下とは読めませんが、公式の速度を自社の待ち時間に置き換えることもできません。単価、推論量、やり直しの回数を合わせて初めて、処理1件の費用と時間が見えてきます。API速度の外部測定
Mercury 3は長文対応と性能を拡大。毎秒1,068トークンの先も確かめる
Inceptionは10月19日、拡散方式の言語モデルMercury 3を発表しました。拡散方式は、文章を1トークンずつ伸ばす方式とは異なり、複数のトークンを並列に修正して回答へ近づけます。Mercuryシリーズは以前からこの方式を採用しており、今回初めて登場した仕組みではありません。Mercury 3の発表、方式の説明
文脈長はMercury 2.5の260Kから100万トークンに拡大しました。提供元が示す生成速度はNVIDIA GPU上で1,068トークン/秒です。ただし2.5の公称値は1,107でした。測定環境が同一と確認できない以上、今回を「前モデルより高速化した更新」とは位置づけられません。高速な生成を維持しながら、扱える文脈と性能を広げた点が中心です。Mercury 2.5の発表
推論設定がmediumでも、強い分野は一様ではない
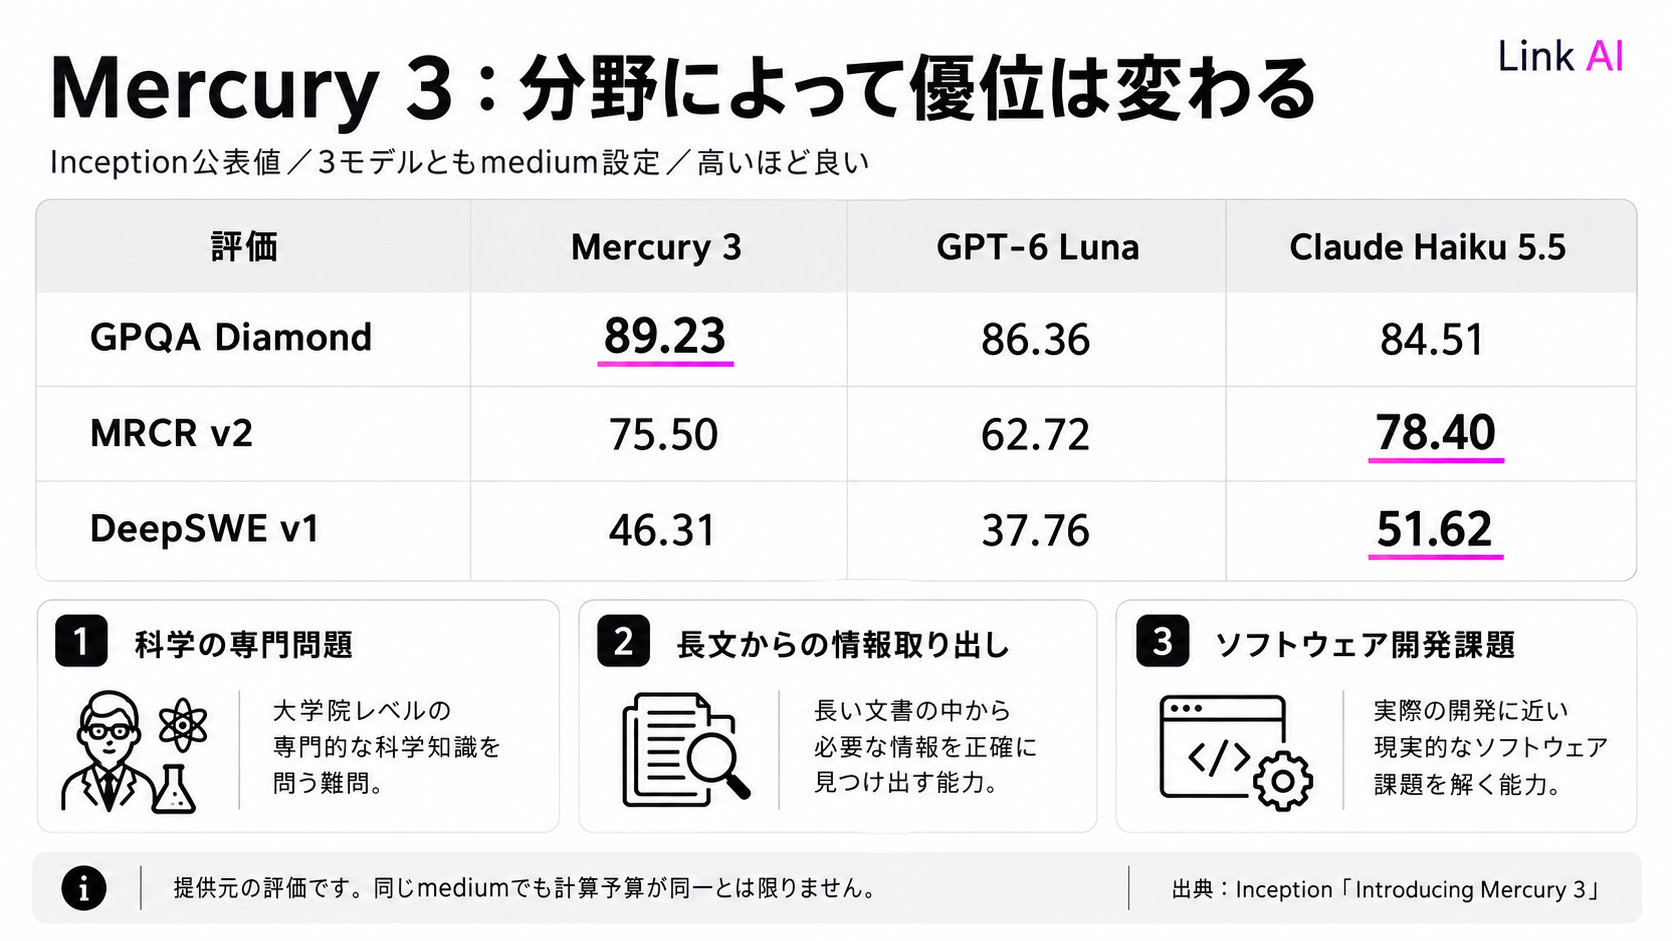
Inceptionの公開表では、Mercury 3、GPT-6 Luna、Claude Haiku 5.5はいずれもmedium設定です。下表はそのうち、得意・不得意の違いが分かる項目です。いずれも高いほど良い値ですが、同じ名前の設定が同じ推論量を意味するわけではありません。
| 評価・測る対象 | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| GPQA Diamond:専門的な科学問題 | 89.23 | 86.36 | 84.51 |
| MRCR v2:長い文脈からの情報取り出し | 75.50 | 62.72 | 78.40 |
| DeepSWE v1:ソフトウェア開発課題 | 46.31 | 37.76 | 51.62 |
提供元の表では科学問題でMercury 3が上回る一方、長文評価と開発課題ではHaiku 5.5が上回ります。評価環境、試行回数、MRCRの入力長ごとの内訳は明記されていません。また、MiniMaxの節で扱ったDeepSWEはv1.1であり、このv1と横並びの順位は作れません。公式比較表
先行利用先TinyFishは、実際のウェブを操作するMind2Webの50課題で完了率50%だったと報告しています。提供元が掲載したパートナーの報告で、第三者による独立追試ではありません。速度が高くても課題は半分残ったという結果から、生成の速さと操作を成功させる能力は別に見る必要があります。Mercury 3の独立した品質・速度の追試は未確認です。
割引価格と旧モデルの終了予定は、移行費用に関わる
APIの通常料金は100万トークン当たり入力0.20ドル・出力0.70ドル、開始時の50%割引では0.10ドル・0.35ドルです。割引の終了日は明示されていません。Mercury 2.5の開始時価格0.04ドル・0.15ドルとは異なるので、「新モデルだから安くなる」とは限りません。現行料金、2.5の開始時料金
現行の案内ではMercury 2と2.5は新規利用者への提供を終え、10月19日より前に利用実績がある顧客は11月15日まで利用できます。企業契約は契約条件に従います。既存利用者には、長文性能の向上だけでなく、移行期限と割引終了後の単価も判断材料になります。提供条件
MicrosoftがGuardian Agentsを発表。利用者とAIの権限を分ける
Microsoftは10月19日、Project Perceptionを拡張し、業務で動くAIエージェントを監視するGuardian Agentsなどを発表しました。人が定める方針や承認範囲に沿って、リスク変化の調査や権限の制限を支援するものです。従来のPerceptionには攻撃・検知・修復を担うエージェント群があり、今回は社内で使うエージェント自身の行動を管理する方向へ広げています。発表、従来の構成
特徴は、社員が持つ権限をAIへ丸ごと渡さず、作業の内容と期間に応じて与える設計です。Dynamic Permissions、Dynamic Agent Risk、Dynamic Conditional Accessを通じ、危険度に応じて書き込みを止め、読み取りを残すなどの制御を説明しています。何かあれば全停止するだけでなく、許可する操作を絞る考え方です。
たとえば経費の確認を任せる場合、書類を読む権限と支払いを承認する権限には違いがあります。外部文書に含まれる不正な指示にAIが影響されても、承認操作の直前に別の仕組みが権限を検査すれば、モデルの回答だけで処理が進むことを防げます。この原則自体は新しくありません。今回の変化は、エージェントの活動情報と複数の管理製品を結び、実行中も権限を調整する構成を示したことです。
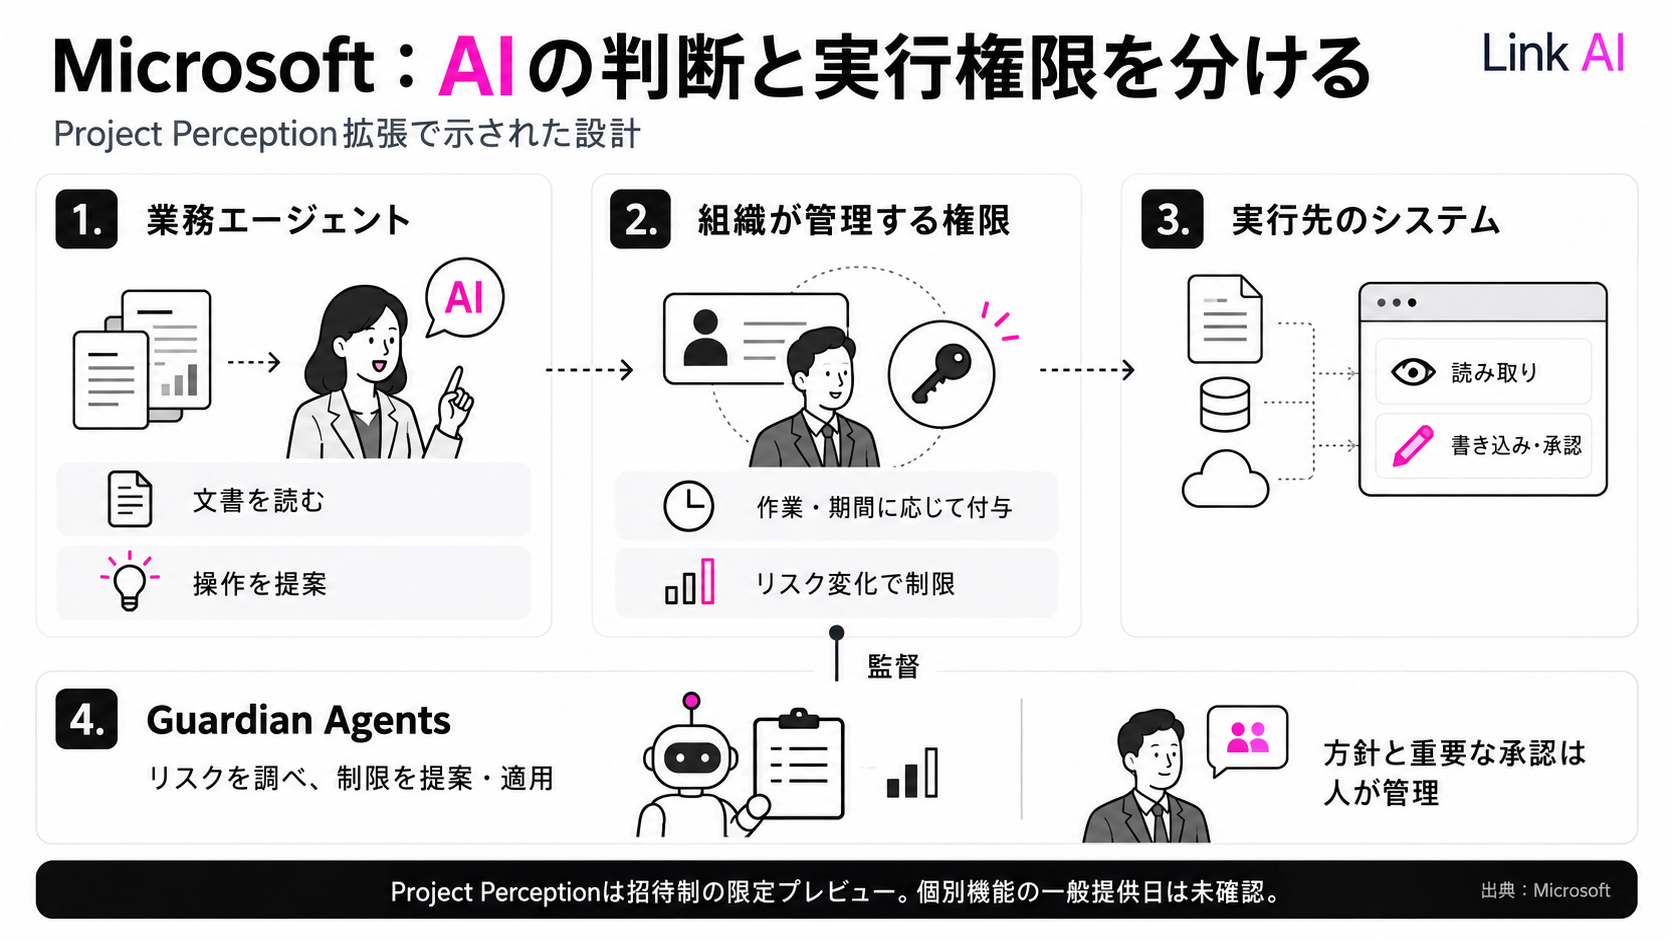
ただし、Project Perceptionの公式文書は招待制の限定プレビューとしています。今回発表された機能がすべての契約で利用可能になったとは確認できず、料金や個々の機能の一般提供日は未確認です。また、監視側のAIも誤り得るため、Guardian Agentsが全事故を防ぐとまでは言えません。提供段階、出力の限界と人による監督
エージェントを導入する企業にとっては、「どのモデルを採用するか」と別に「誰の権限で何を実行させるか」を設計する必要性が、具体的な製品機能として表れた発表です。
LINE WORKSのAI電話受付が正式提供。無料期間後の料金と折り返し対応を確認する
LINE WORKSは、10月15日に発表していた「LINE WORKSキャッチコール」の正式提供を19日に開始しました。AIが電話の用件や氏名、折り返し先を聞き取り、文字と音声を記録して通知します。既存番号からの転送で利用でき、LINE WORKSを契約していなくてもメール通知を使えます。提供開始のお知らせ
電話受付の自動化自体が初めて可能になったわけではありません。同社は先行版を2月から提供しており、正式版では聞き取り項目の設定、対応状況の管理、CSV出力などを備えます。留守番電話の録音を個別に聞く運用と比べると、用件と折り返し先を文字で共有し、誰が対応したかを残せる点が判断材料です。正式版の発表
通常料金は年間1,800コールで月額8,900円から、年間契約が必要です。金額は税別で、上限に達すると追加購入か上位プランが必要になります。1年間無料のキャンペーンもありますが、トライアル後の申し込みと契約が必要で、適用条件があります。無料期間後は通常料金となるため、永続的な無料サービスとしては扱えません。料金・キャンペーン
このサービスの中心は、顧客との用件を聞き取って担当者へ渡す一次受付です。問い合わせをその場で解決することと、折り返しに必要な情報をそろえることは異なります。営業時間外の着信や少人数の事務所には検討価値がありますが、急ぎの問い合わせで折り返しを待てるか、聞き取りを誤った際に録音から確認できるかが適合性を左右します。正式版の日本語聞き取り精度や、導入後の対応完了率を比較した独立評価は未確認です。
自社の用途に合わせてモデルの評価条件や運用上の権限、サービスの費用を整理したい場合は、Link AIのAIアセスメントでご相談いただけます。