DeepInfer公開、Geminiに事業者向け機能。源内のエージェント展開とAI安全対策
DeepSeekは10月20日、大規模サービスで使う推論基盤「DeepInfer」をオープンソースで公開しました。モデルを自社設備で動かす企業にとって、処理を速める実装を調べられる範囲が広がります。ただし、公開物だけで商用APIと同じ運用環境が完成するわけではありません。
DeepInfer公開。モデルを動かす技術と、サービスを支える設備を分けて考える
DeepInferは、学習済みモデルに入力を渡して回答を生成するためのソフトウェアです。今回の公開版はDeepSeek-V4.1-Flashのオフライン推論に対応し、ライセンスはApache 2.0。NVIDIA SM100 GPUとHuawei Ascend 950 NPUを対象としています。10月17日のモデル更新に続く発表ですが、今回はモデルの賢さではなく、モデルを実行する基盤の公開です。公式リポジトリ
公開された機能には、計算の最適化、複数の計算装置への処理配分、JSONなどの形式を守る出力制御が含まれます。一方、過去の計算結果を再利用するKVキャッシュの管理システムや、画像処理・入力処理・回答生成を分けて稼働させる仕組み、リクエストの負荷分散は、完全なサービスにするために別途必要です。
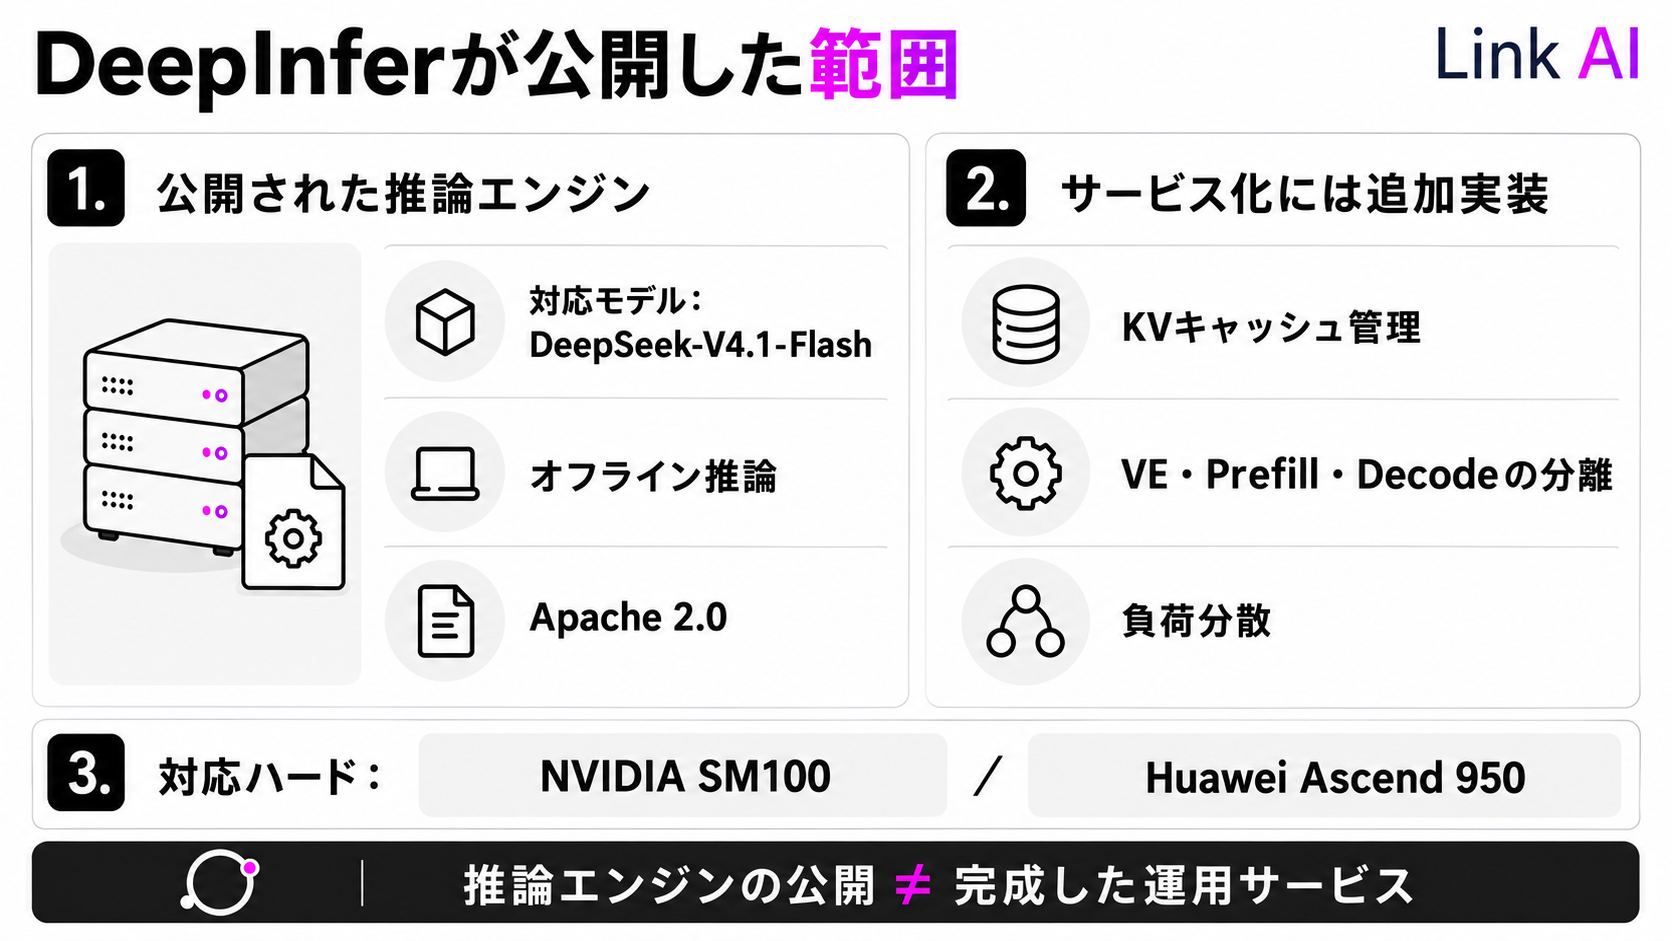
自社運用を検討するうえで注目したいのは、コードとともに公開されたデプロイのQ&Aです。DeepSeekは、効率を重視した構成の最小単位として入力処理用64基と生成用64基のGPUを挙げています。これは、あらゆる試験実行に128基が必須という意味ではありません。多数の利用者に低遅延で応答する本番運用の設計と、単にモデルを動かすための条件が異なることを示しています。
公式の性能グラフも、入力処理はSM100を4基、生成処理は64基で測定しています。この条件の違う数値を、単一GPUの速度やHuawei機での実測値として読むことはできません。独立した追試による速度・費用の優位性は未確認です。既存のvLLMやSGLangからの移行を判断するには、同じモデル、ハードウェア、入力長、同時処理数、許容待ち時間をそろえる必要があります。
公開の価値は、モデル提供元の最適化と設備設計を、自社の技術者が具体的に検討できることです。ソフトウェアのライセンス料と、設備・運用の総費用は別に見積もる必要があります。小規模利用でもAPIより安くなる、という結論までは今回の発表から導けません。
Geminiに事業者向けの入口。ブランドの見た目を保持し、業務アプリにつなぐ
Googleは10月20日、Geminiアプリに小規模事業者向けの専用ページを設け、マーケティングや財務のスキル、外部アプリ連携を拡充すると発表しました。全Geminiアプリ利用者を対象に、世界各地で数日内に順次展開する予定です。日本の個別アカウントで利用可能になる日時や、連携先ごとの契約条件を一律に保証する発表ではありません。Googleの発表
具体的な変更は、企業のサイトやブランド資料、フォント、配色を読み込ませ、そのスタイルを保持して画像を生成できることです。Nano Banana 2.1と組み合わせ、繰り返しガイドをアップロードする手間を減らします。財務面では、表計算や領収書、購買記録からグラフや操作可能なモデルを作る機能を案内しています。
Google Business Profile、Google Ads、Workspaceに加え、Canva、Shopify、Xeroなどとの接続も打ち出しています。ただし、接続先が今回すべて初登場したわけではありません。たとえばXeroは10月14日にGemini連携を発表済みです。今回の変化は、事業者向けの入口とスキル、ブランド表現をまとめて使いやすくする点にあります。Xeroの先行発表
専任の制作担当者がいない会社にとって、商品画像を作れるだけでなく、配色や書体を毎回説明し直さずに済むことには意味があります。一方、ブランドの見た目がそろうことと、商品仕様や価格が正しいことは別の品質です。今回のスタイル保持機能について、制作物の一貫性や修正回数を測った独立評価は未確認です。
Googleが紹介する事業者の活用談は、同社が選んだ事例です。既存のGemini利用による成果を、新機能だけの効果としては扱えません。また、組織的な管理機能が必要な企業向けには別の案内があるため、個人向けアプリの利用条件と企業向けの管理・データ保護を同一視せず、利用する契約で確かめる必要があります。
「源内」がエージェント環境を展開。政府内の提供と民間向け公開は時期が違う
デジタル庁は10月20日、政府職員約18万人を対象とする「ガバメントAI 源内」で、AIエージェント利用環境の提供を始めると発表しました。手軽にエージェントを作成・実行する「エージェントチャット」は同日から各府省庁等へ順次導入し、高度な構築・実行を行う「源内工房」は12月頃までの導入を目指します。対象人数は、既に全員が新機能を利用している人数を示すものではありません。デジタル庁の発表
自治体や民間事業者が利用・改変・再配布できる「源内OSS Ver.2.0」の公開は、2027年2月頃を予定しています。したがって、政府内の提供開始を受けて、民間企業が新しい環境一式を直ちに導入できるわけではありません。既存のエージェント製品でも可能な作業が初めて実現したという発表ではなく、一般の政府職員が業務に合わせて作り、使える共通基盤へ展開することが変化です。
同時に公表された「源内基準」は、利用者・管理者・開発者の責務を分けています。企業のDX推進担当が参考にできるのは、エージェントを使う人の注意だけで運用を成立させようとしていない点です。処理できる範囲が広がれば、許される操作を決める管理者と、その制限を実装する開発者の役割も必要になります。政府向けの基準を自社へそのまま適用するのではなく、誰が利用範囲を決め、誰が実装・確認するかを整理する際の比較材料になります。新環境の導入後の成果や、事故抑制の効果を測る第三者評価は未確認です。
リコーの安全性判定モデルが小型化。入力と出力では改善の方向が異なる
リコーは10月20日、日本語の入力や回答に有害な内容が含まれるかを判定するセーフガードモデルの改良版を発表しました。基盤をLlama系から「gemma-4-E4B-it」に替えて小型化し、11月から「RICOH オンプレLLMスターターキット」に順次標準搭載する予定です。旧モデルの無償公開実績を、そのまま今回の新版の配布条件と見なすことはできません。リコーの発表
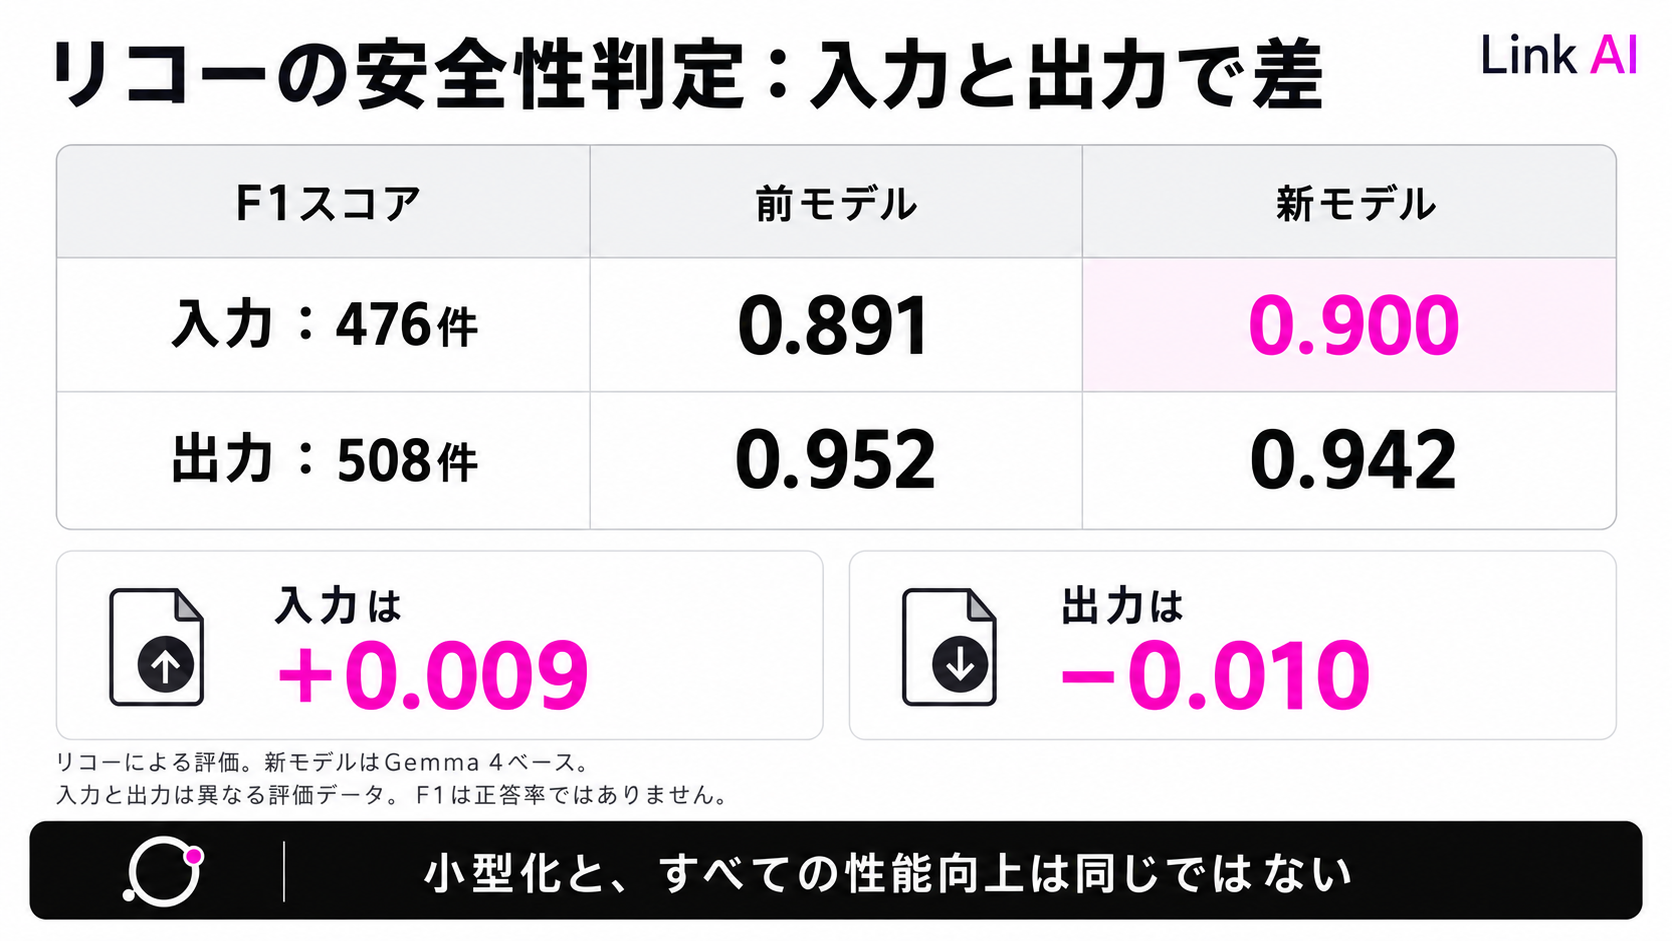
リコーが公表した比較は次の通りです。F1スコアは、有害と判定した内容が実際に有害だった割合と、有害な内容を見逃さず検出した割合の両方を反映する指標で、単純な正答率ではありません。
| モデル | 入力のF1 | 出力のF1 |
|---|---|---|
| Llama guard3 | 0.556 | 0.618 |
| Qwen3Guard-8b | 0.834 | 0.851 |
| Llama-Ricoh-SafeGuard-20260520 | 0.891 | 0.952 |
| 新モデル(Gemma 4ベース) | 0.900 | 0.942 |
入力はAnswerCarefully Dataset v2.0とリコー製データを合わせた476件、出力はリコー製データ508件を使った同社の評価です。新モデルは入力で前モデルを0.009上回る一方、出力では0.010下回ります。公表された競合モデルより高い数値ですが、リコー独自のデータを含む評価であり、日本語のあらゆる用途で優れることを示したものではありません。計算資源の削減率や応答時間、第三者の追試も未確認です。
もう一つの変更は、危険性の判定基準です。リコーの技術解説では、専門的な話題に触れることと、有害な行為を具体的に促すことを区別したと説明しています。追加学習なしで独自の判定ラベルを加える機能もあります。
これは、安全性を高めるほど一律に多く拒否すればよい、という設計を見直す材料になります。社内の専門文書を扱う場合、必要な説明まで止めると業務上の価値が失われるためです。ただし、集計されたF1だけでは「必要な回答を止めた誤検知」と「有害な回答を通した見逃し」の内訳は分かりません。導入先のポリシーに合うかは、両方の誤りを自社の文書で分けて確かめることが重要です。
Claude EnterpriseのInference hooksが一般提供。検査の仕組みと判定役は別
Anthropicは10月20日の更新で、Claude Enterprise向け「Inference hooks」のベータ提供終了を告知しました。対象の会話がモデルで処理される前に、組織やセキュリティ事業者が運営する検査サーバーへ会話内容を送り、許可・拒否の判定を受ける機能です。新しい検出モデルの発表ではなく、組織の検査をClaudeの利用経路に組み込む機能の一般提供です。リリースノート
Claude.aiやCowork、Claude Codeなどの管理対象リクエストに適用でき、端末ごとの導入を必要としません。一方、Claude PlatformのAPI組織、Amazon Bedrock、Google Cloudは対象外です。送られるのは会話のテキストや添付資料から抽出された文字などで、画像だけの内容は検査されません。プロンプトを自動修正・墨消しする機能でもありません。機能と制限
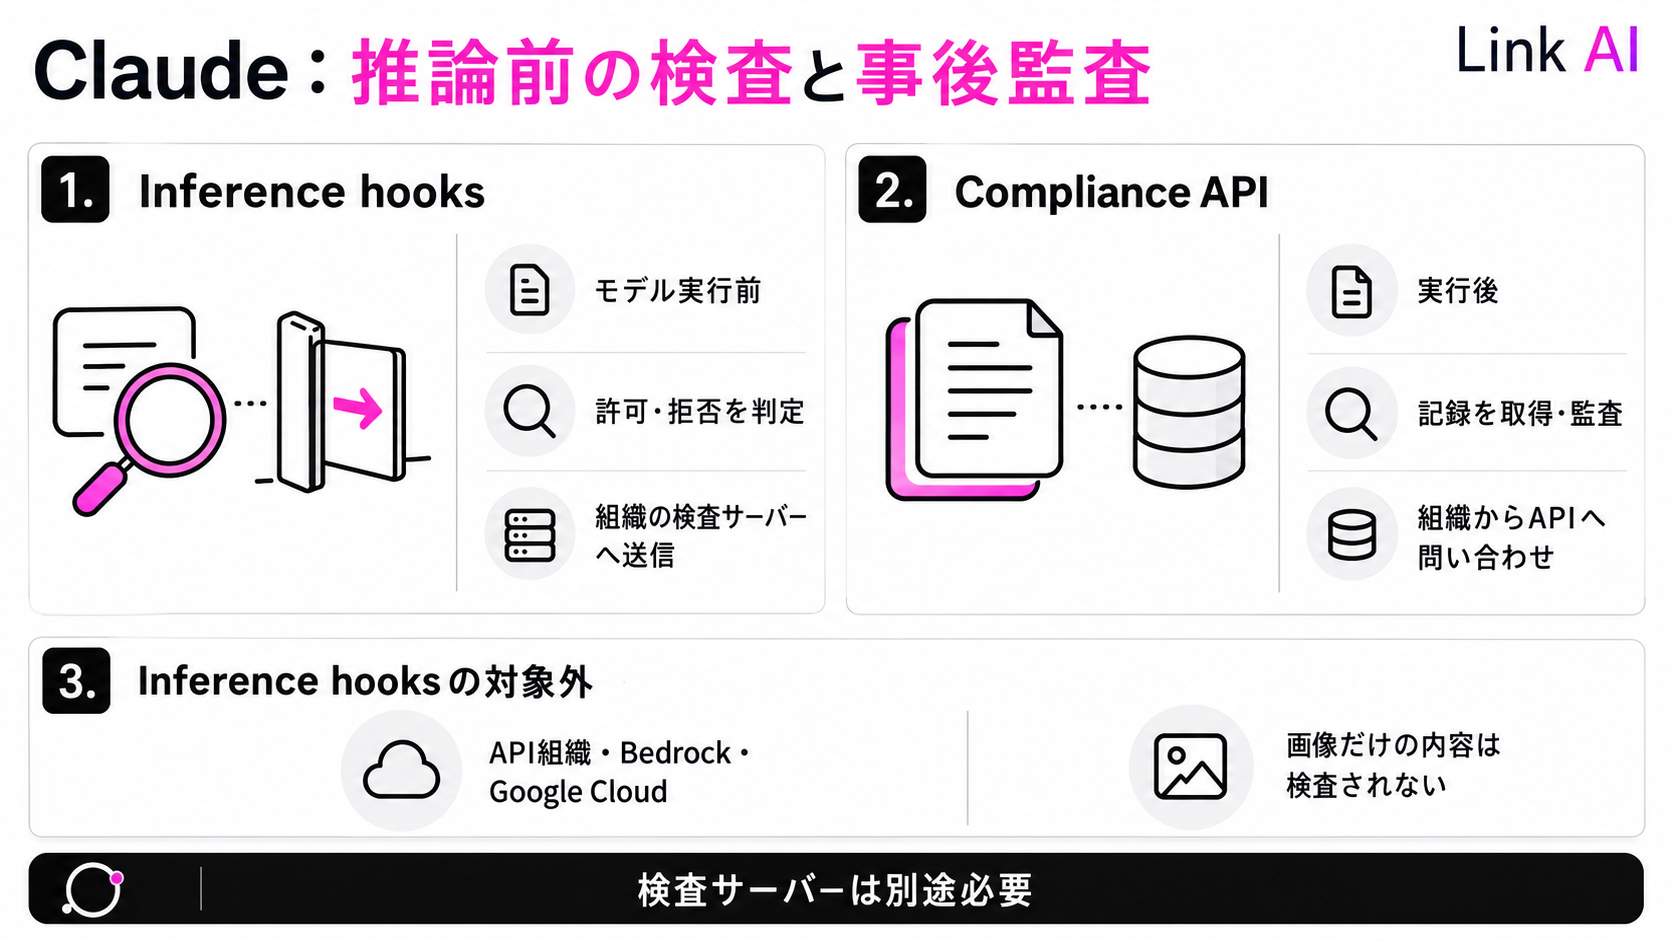
事後に記録を取得するCompliance APIに対し、Inference hooksはモデル実行前に止められる点が違います。ただし検査はAnthropic側のサーバーで呼び出されるため、端末からAnthropicへの送信自体を防ぐ仕組みとは異なります。機密情報をそもそも外部送信できない用途では、この位置の違いが重要です。
運用を左右するのは、検査サーバーが応答しない場合の設定です。公式設定ガイドでは、初回保存時の既定値は「未検査のまま許可」、待ち時間は5秒とされています。停止を優先する設定にも変更できますが、その場合は検査系の障害がClaude利用の停止につながります。設定ガイド
既存の情報漏えい検知や社内ルールを会話に適用したい企業には、検査を差し込む場所がそろうことが利点です。一方、検出精度は接続する判定システムに依存し、一部の内部ツール呼び出しやホスト型レビューなど対象外の処理もあります。一般提供になったことを、全処理を漏れなく検査する保証とは読めません。実環境での遅延や誤遮断を比較した独立評価は未確認です。
自社でAIを運用する際の設備、評価条件、データ管理を整理したい場合は、Link AIのAIアセスメントでご相談いただけます。