GPT-6.1 Terraの費用と弱点、Siri AIの日本語対応|AIニュース
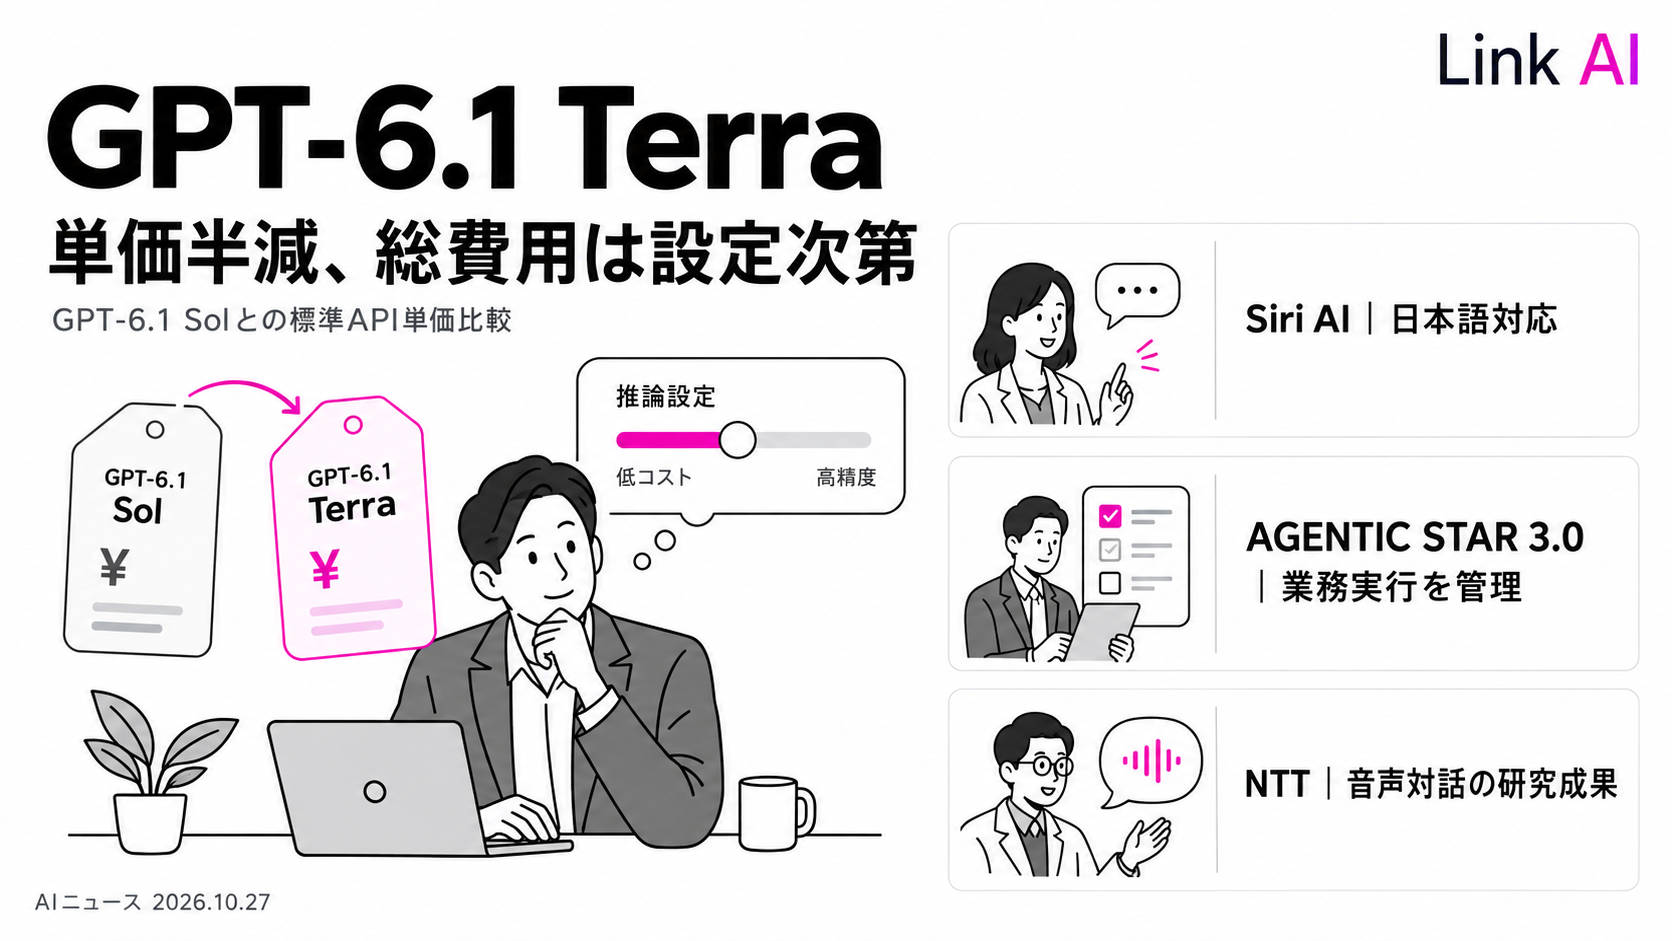
OpenAIは10月26日、画像の理解やコンピューター操作を得意とする「GPT-6.1 Terra」を公開しました。標準API料金は入力100万トークンあたり1ドル、出力は5ドルで、GPT-6.1 Solの半額です。ただし、第三者評価を見ると、推論を長く行う設定ではSolの方が安く同程度の総合スコアに達する組み合わせもあります。単価の引き下げと、仕事を一つ終えるための費用は分けて見る必要があります。OpenAIの発表、Artificial Analysisの比較
GPT-6.1 Terra:費用効率は改善、会計処理には弱さも
何が変わったのか
GPT-6.1 TerraはGPT-5.6 Terraの後継で、画面の読み取り、アプリの操作、文章作成、コーディングを改善したモデルです。ChatGPT WorkとCodexではPlus、Pro、Enterprise、Eduの利用者に提供され、APIでも利用できます。従来のエージェントにもコンピューター操作はできました。今回の焦点は、その能力をより少ない費用で利用できる範囲が広がったことにあります。公式発表
APIでは推論の強さを「none」から「max」まで6段階で指定できます。標準料金は入力1ドル、キャッシュ済み入力0.05ドル、出力5ドルですが、入力が27万2,000トークンを超えると、リクエスト全体の入力・キャッシュ料金は2倍、出力料金は1.5倍になります。大量の資料を毎回読み込ませる使い方では、見出しの単価だけで費用を見積もれません。モデル仕様・料金条件
Amazon Bedrockでも同日に一般提供が始まりました。AWSの認証・監査の仕組みで運用する企業にとっては、既存の環境で比較する選択肢が増えます。利用可能なリージョンや料金はBedrock側の条件を確認する必要があり、OpenAI直販APIの条件をそのまま適用できるわけではありません。AWSの発表
GitHub CopilotでもPro、Pro+、Max、Business、Enterprise向けに順次展開されます。企業向けプランでは管理者のモデル設定が利用可否に関わります。GitHubの提供条件
推論を最大にすれば、いつも割安になるわけではない
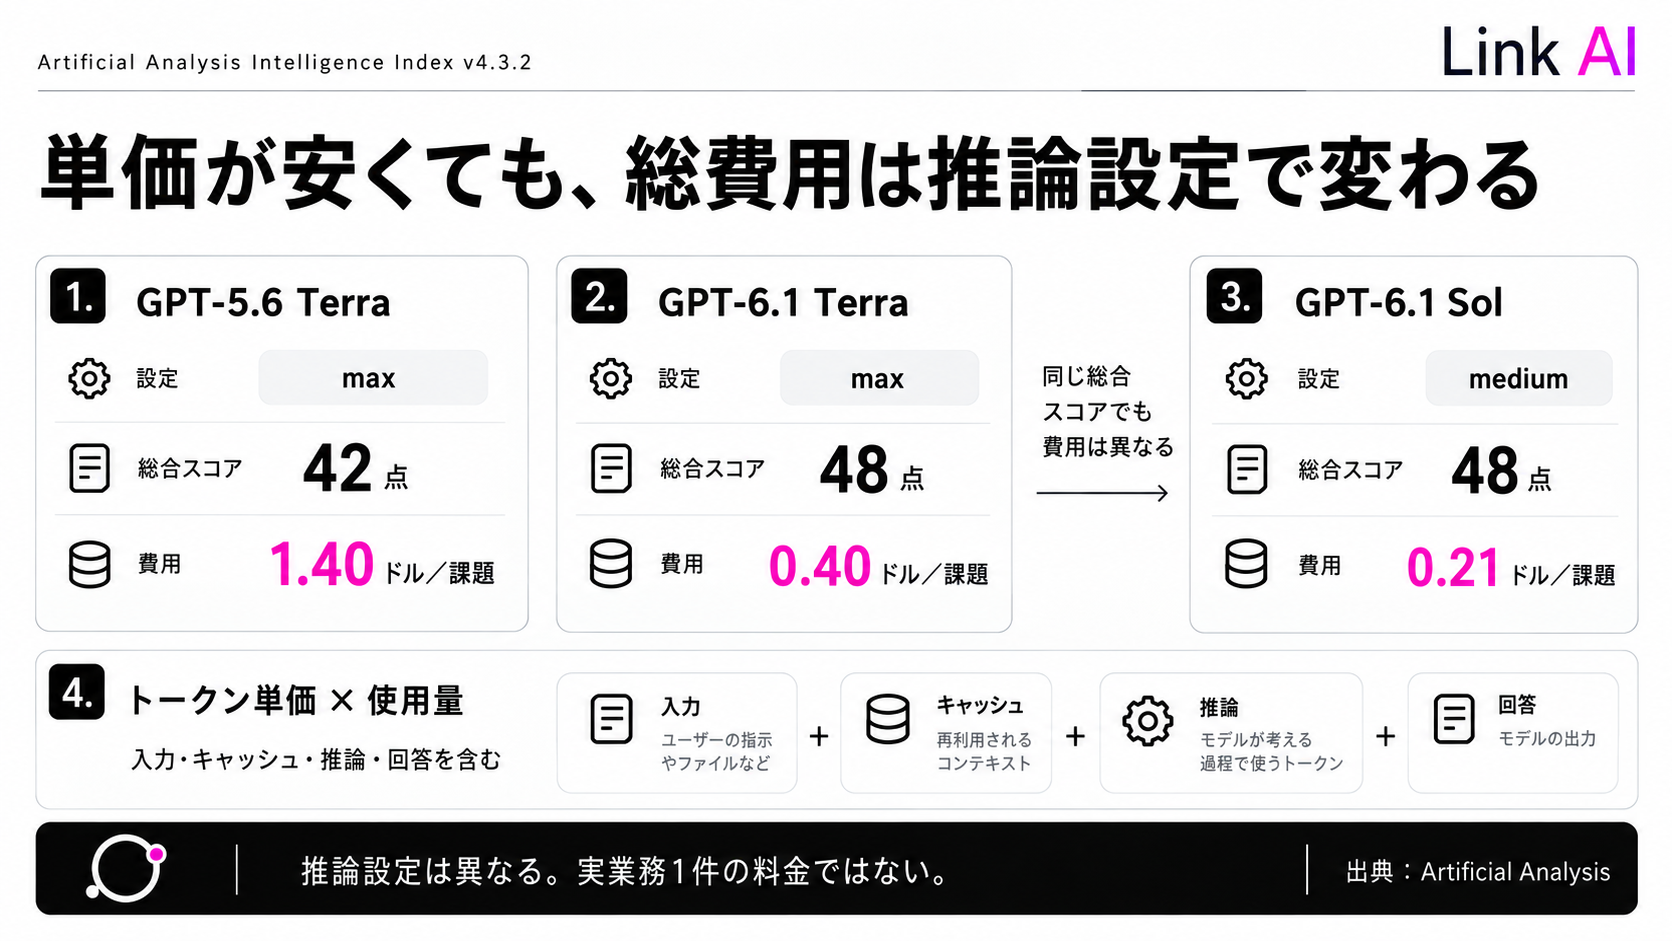
独立評価機関のArtificial Analysisは、総合指標「Intelligence Index v4.3.2」でTerraのmax設定を48点と評価しました。旧Terraから6点上昇し、同評価の1課題あたり費用は1.40ドルから0.40ドルに下がっています。一方、GPT-6.1 Solはmedium設定で48点、0.21ドルです。丸められた総合スコアが同じでも個別の得意分野は異なりますが、小さいモデルに長く考えさせる方が常に安い、とはいえません。AAによる新旧比較、Sol mediumの評価
| モデルと推論設定 | 総合スコア | 1課題あたり費用 |
|---|---|---|
| GPT-5.6 Terra/max | 42 | 1.40ドル |
| GPT-6.1 Terra/max | 48 | 0.40ドル |
| GPT-6.1 Sol/medium | 48 | 0.21ドル |
これは同じ総合評価内の比較で、推論設定をそろえたモデル単体の比較ではありません。指標は知識、業務、コーディングなど10種類の評価を組み合わせたもので、費用は入力・キャッシュ・推論・回答のトークン料金を加重平均しています。実際の業務1件の料金ではありません。AAはTerraのlow・medium設定を、総合性能と費用の釣り合いがよい選択肢と位置づけています。評価構成と費用の定義
改善の中身にも違いがあります。AAの知識評価「AA-Omniscience」では、答えを知らない場面で推測して答える割合が旧Terraの88%から38%へ下がった一方、正答率の上昇は2ポイントでした。知識そのものが大幅に増えたというより、分からない問いへの対応が改善したと読むのが適切です。この38%は、日常の全回答が誤る割合を意味しません。AAの分析
総合評価と、任せたい仕事の評価は一致しない
会計ソフトを提供するDualEntryの独自評価では、Terraの総合合格率は78.2%、1課題平均16.1秒、費用は0.042ドルでした。取引分類は13問中13問に合格したものの、買掛金処理は13問中7問、売掛金処理は12問中7問にとどまっています。比較対象のSolは総合81.2%、Gemini 4 Argonは91.1%でした。DualEntryの結果
この評価は架空の会社の101課題を同じ会計ツール・指示で3回ずつ実行し、2回以上合格した課題を成功と数えます。採点は固定の正解と検査規則に基づきますが、Terraの推論設定の詳細は公開本文では分かりません。会計ソフト事業者による特定環境の評価であり、日本企業の経理全般にそのまま当てはまる順位ではありません。それでも、取引の分類ができることと、債権・債務の処理を安定して任せられることは別だと分かります。評価方法と限界
具体的な制作例でも、成功と失敗が分かれました。Adam Holter氏がCodex CLI 0.164.0、xhigh設定で試したブラウザゲーム制作では、初回はJavaScriptの構文エラーで起動しませんでした。同じ元の指示を使った再試行では建物の設置、移動、最初の夜の戦闘を確認できた一方、後半の難易度やゲームのクリアは未検証としています。個人の少数例ですが、完成物らしく見えることと、最後まで動くことを分けて確認する必要性が具体的に表れています。実行結果・元の出力・動画
Terraへの切り替えを検討するなら、まず現在のモデルが安定して終えられる仕事で、同じ入力と合格条件を使って比べるのが合理的です。料金の節約が再試行や修正の手間で消えないかを見るためです。特に経理処理や複雑なコード変更では、総合スコアだけで既存モデルを置き換える根拠にはなりません。
Siri AIが日本語に対応:端末の情報とアプリ操作がつながる
Appleは10月26日、「Siri AI」の日本語提供を開始しました。iOS、iPadOS、macOS、watchOS、visionOSの27.2でベータ版として利用でき、対応デバイスでApple Intelligenceを有効にする必要があります。メッセージやメールなどの個人情報を文脈として参照し、画面上の内容について質問したり、対応するアプリで操作したりできます。Appleの発表
日本向けの例として、Yahoo!乗換案内での経路案内、FirstSeedタスクへのタスク追加、Kotobaでのメモの検索・編集が挙げられています。以前からSiriに対応していたアプリの操作も引き続き使えます。今回の意義は、音声操作が初めて可能になったことではなく、日本語で個人の文脈や画面の内容を踏まえて依頼できる範囲が広がることです。
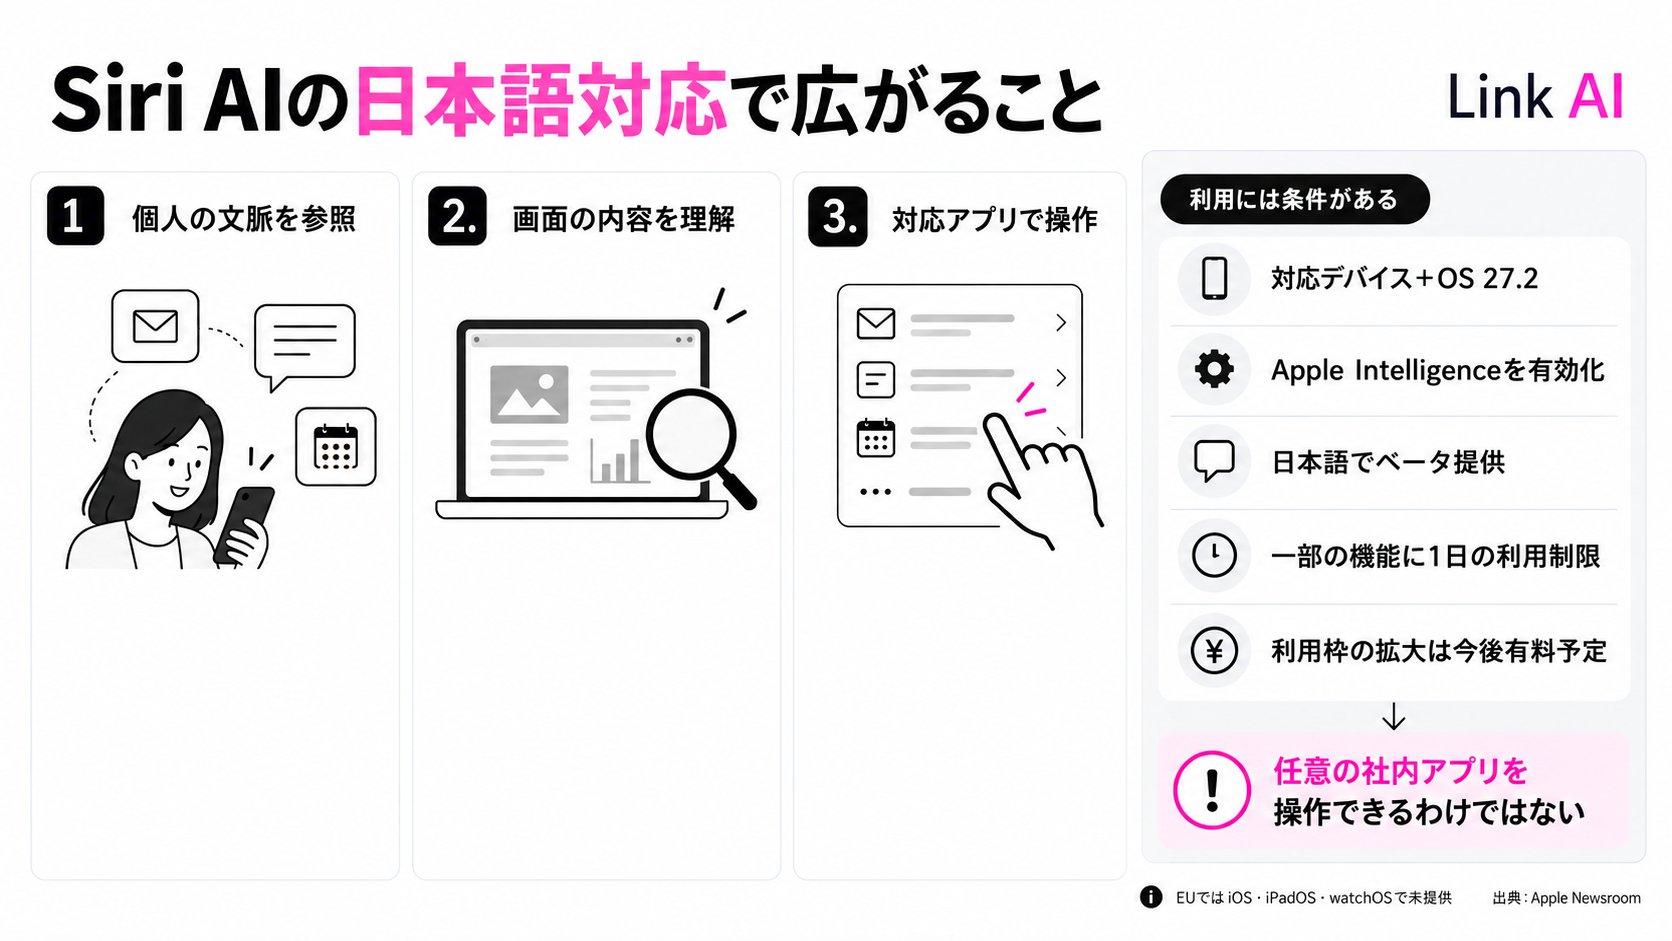
ただし、Siri AIが対応する操作と、任意の社内アプリの操作は同じではありません。たとえば会議場所の情報から経路を調べる場合も、必要な情報にアクセスでき、使うアプリがその操作に対応していることが前提です。対応するOSへ更新するだけで、あらゆる業務システムを操作できると見込むのは早計です。
利用量にも条件があります。サーバー側のモデルに依存する機能には1日の利用制限があり、リクエストの複雑さやシステム負荷などで変わります。Appleは利用枠を広げる有料提供も予告していますが、今回の発表に価格はありません。EUではiOS・iPadOS・watchOSのSiri AIは利用できません。会社の端末で使う際は、必要な操作が対応しているかに加え、地域と利用量の条件まで見て判断する必要があります。提供条件、利用制限の説明
AGENTIC STAR 3.0:チャットから、履歴を追える業務プロジェクトへ
ソフトバンクは10月26日、法人向け「AGENTIC STAR 3.0」の提供を開始しました。新しいプロジェクト機能では、AIの実行と人の判断・確認を組み合わせて複数工程の業務を設計できます。工程と処理結果を履歴として蓄積し、完了件数、失敗件数、処理時間も確認できます。ソフトバンクの発表
AIと人を組み合わせたワークフロー自体は、エージェント製品に共通する考え方です。今回の変化は、従来のAGENTIC STARのチャット利用に加え、継続して実行する業務をプロジェクトとして管理し、その経過を追えるようになった点にあります。途中の処理結果が残ることには、失敗した仕事を調べ、どの工程を直すべきか切り分ける意味があります。
一方、完了件数が増えただけで導入効果が高いとは限りません。処理が完了していても、人が出力を修正している場合には、その確認・修正時間も含めて比べる必要があります。今回追加された実行履歴や処理時間は、その検証の材料になりますが、業務上の正しさや費用対効果を自動的に保証する指標ではありません。
料金は従来のチャット機能とは異なる体系です。具体額や課金単位は発表されていないため、既存のチャット契約と同じ費用で利用できるとは判断できません。プロジェクトの実行回数と人による確認の負担を合わせて、継続利用の費用を確認したい変更です。サービスと料金に関する発表
NTTの音声対話研究:0.43秒の応答と、「待つ・止まる」の両立
NTTは10月26日、相手の音声を聞きながら発話できる、全二重型の音声対話AI技術を発表しました。相づち、相手の発話待ち、割り込みへの対応に加え、指示文で応対の内容を指定し、対話中にデータベースやCRMの情報を参照・更新する仕組みです。指示文を変えることで、モデルを再学習せずに業務ごとの応対へ対応するとしています。NTTの研究発表
NTTが日本語のコールセンター応対を模した400対話で測定した平均応答時間は0.43秒でした。比較した商用サービスより50%以上短く、日本人オペレーターの0.31秒に近づいたとしています。ただし、比較先の製品名や実行環境は発表に示されていません。ほかの音声モデルが公表する応答時間とは、言語、会話データ、平均か中央値かなどをそろえずに優劣を決められません。
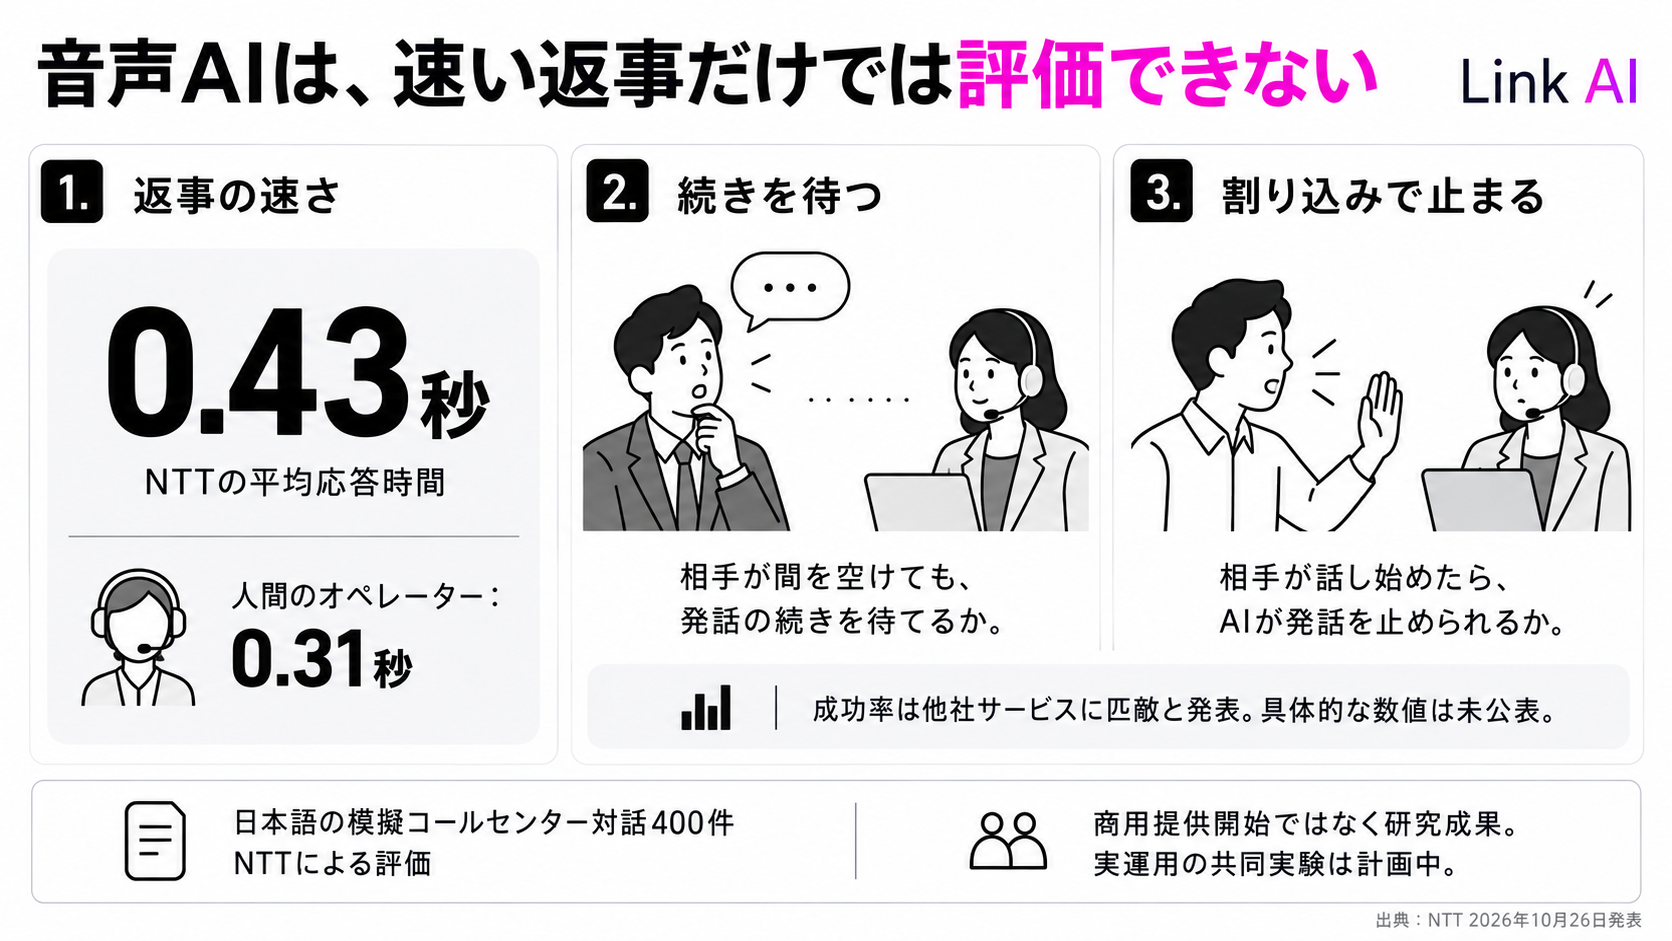
この研究で注目したいのは、速さと一緒に「発話待ち成功率」「割り込み成功率」を測っている点です。発話待ちは、相手が言葉の途中で間を空けたときに続きを待てるか、割り込みは、相手が話し始めたときにAIが発話を止められるかを表します。返事が速くても、考えている途中に話を遮られたり、訂正を聞いてもらえなかったりすれば、電話応対は使いにくくなります。
NTTは、この二つの成功率も比較先に匹敵したと説明していますが、具体的な数値は示していません。また、今回示された中心的な評価は会話のテンポであり、顧客の用件を最後まで正しく解決した割合ではありません。商用提供の開始日・料金は未発表で、コールセンターでの共同実験は計画中です。即座に導入できる新サービスではなく、日本語の音声AIを評価する観点が具体化した研究成果として捉えられます。実験条件と今後の計画
モデルやエージェントを選ぶ際に、実際の処理の合格条件と費用を整理したい企業向けに、Link AIではAI導入・活用のご相談を受け付けています。