
Mistral Large 4の重み公開、ChatGPTの利用枠拡大とSarashinaの推論性能
Mistralは10月29日、主力モデル「Mistral Large 4(Le Chonk)」の重みを公開しました。10月6日のプレビュー版に追加学習を施し、自社設備で動かせるようにするとともに、API料金も引き下げています。モデルの選択肢が広がっただけでなく、性能、実行費用、運用する場所を別々に比較できる材料が増えました。Mistralの発表
Mistral Large 4の重み公開――コーディングの改善と、自社運用の条件
公開されたモデルは、テキストと画像を受け取り、テキストを返す約1兆パラメータのモデルです。一度の処理ですべてを動かす構造ではなく、実際に使う部分は埋め込み・出力層込みで約520億パラメータ。推論の深さはlow・medium・highから選べ、最大コンテキストは100万トークンです。ただし、モデルの上限と、個別の機材で実用的に扱える長さは同じではありません。公式モデルカード
Mistralが示す改善の中心は、コードを書くエージェントの成功率とトークン効率です。端末上で作業を完了できるかを測るTerminal-Bench 4.0では、プレビュー版の28%から41%に上がり、出力トークンは30%減ったとしています。ただし発表図では旧版が自社報告値と明記されており、公開資料だけで新旧の実行条件が完全に同一とは確認できません。改善を示す発表として読み、厳密な再現試験とは分ける必要があります。
競合との違いも、一つの順位では説明できません。発表に掲載された比較では、Coding Agent Indexは48%でGLM-5.3とほぼ同水準とする一方、サイバー分野の指数は51%で、DeepSeek V4.1 Flash 1017の57%やMiMo-V2.6-Proの56%を下回ります。財務関連の作業を測るFinchも73.3%へ改善していますが、Kimi K3の77.3%には届きません。評価別の比較図
独立評価のArtificial Analysisでは、high設定の総合指数v5が26、同指数の1課題当たり費用が2.06ドルです。これは複数の評価を重み付けした指標で、一般的なAPI呼び出し1回の料金ではありません。総合指数には業務文書、知識、端末操作、コード修正など異なる課題が含まれます。コーディングでの強さを、そのまま全用途での優位性と見なさないために役立ちます。Artificial Analysisの測定結果・評価方法
APIの新単価は100万トークン当たり、入力0.70ドル、キャッシュ入力0.07ドル、出力2.10ドルです。単価が下がっても、長い入力や推論の量によって1作業の費用は変わります。一方、自社運用ではAPI料金の代わりに機材と運用の費用を負担します。料金を含む公式発表
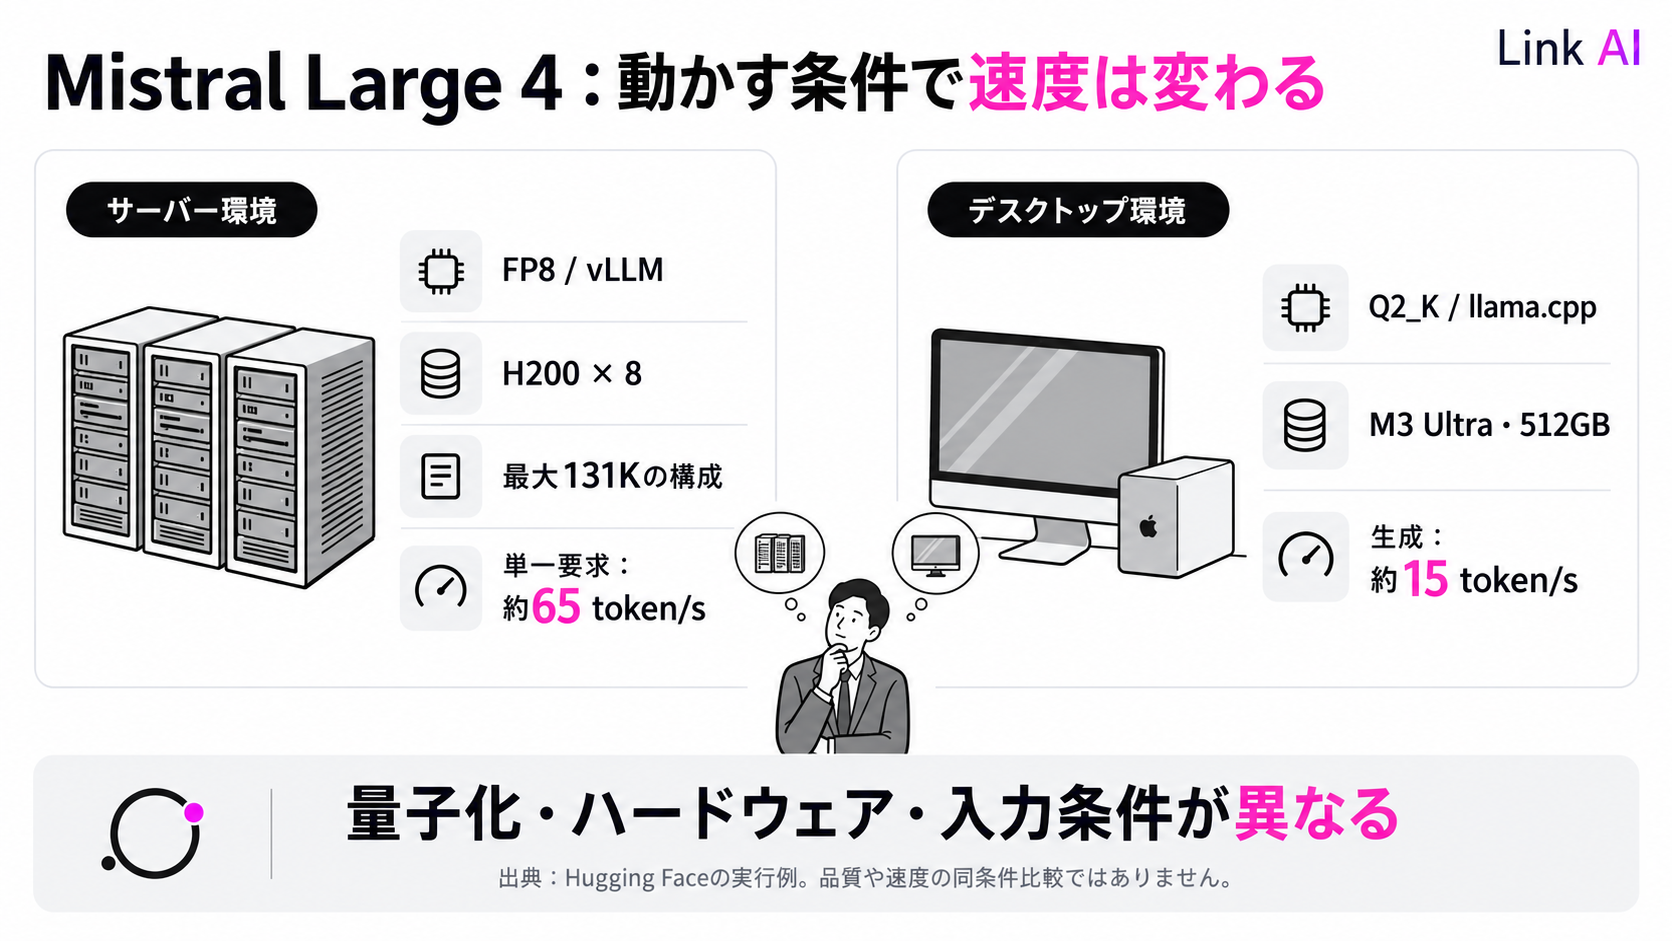
配布・実装を支援するHugging Faceは、具体的な実行例も公開しています。H200を8基使うFP8版の構成では、最大131Kのコンテキストを設定し、単一要求の生成は約65トークン/秒。M3 Ultraの例ではQ2_Kという強く量子化した版を使い、約15トークン/秒でした。2ビット系の単体Mac実行には512GBの統合メモリが必要とされています。また、別の4基のRTX 6000 ProによるIQ2_XXS実行例では、短い入力時の生成約30トークン/秒に対し、長いコンテキストでは約3トークン/秒まで落ちています。Hugging Faceの実行報告
これは「手元で動く」という成功例であると同時に、入力の長さによる速度低下の例でもあります。量子化や機材が異なるため、APIと同じ品質を同じ速度で得られるという証明にはなりません。社内にモデルを置く必要がある企業には選択肢が増えますが、公開重みだけで導入費用まで小さくなるわけではない、というのが今回の判断点です。
ライセンスにも条件があります。Mistral Ecosystem Open-Weight LicenseはMITを基にした独自ライセンスで、Model-as-a-Serviceを営む企業やその関係会社の商用利用には別契約が必要です。内部利用やMistral公式製品経由の利用には例外があり、特定機能に組み込んだエンドユーザー製品も定義上区別されています。「重み公開」と「どの商用サービスにも無条件で使えること」は分けて判断すべきです。ライセンス原文
ChatGPTは利用枠を拡大――APIクレジット特典とは別に確認する
OpenAIは10月29日、ProとBusiness PremiumのWork・Codex利用枠の拡大を発表しました。Pro 100とPro 500は従来の2倍です。Pro 200については、9月29日のメールで予告していた削減を撤回。すでに高い利用枠が適用されていた契約は維持され、低い枠だった契約は2倍になり、同じ上限に揃うと説明しています。ChatGPTリリースノート
したがって、以前の削減予告だけをもとにPro 200から乗り換える判断は、見直す余地があります。ただし、この「2倍」は各契約の従来枠との比較です。全プランの作業量が等しくなるという意味でも、任意のモデルを無制限に使えるという意味でもありません。
これとは別に、10月28日には対象のPro・Business契約にAPIクレジット特典が追加されました。APIは、自社アプリやシステムからモデルを呼び出すための仕組みです。対象プランを契約しているだけで自動的に初回残高が発行されるのではなく、API組織と紐付けて有効化する必要があります。API特典の公式案内
| 対象契約 | 月額契約の全期間分のAPI特典 |
|---|---|
| Pro 100/200/500 | それぞれ100/200/500ドル |
| Business Standard | 有料席1席につき20ドル |
| Business Premium | 有料席1席につき100ドル |
| Business全体 | 席種を合算し、ワークスペース当たり最大500ドル |
有料契約が7日以上継続していることが条件で、初回は請求期間の残りに応じて按分されます。月次の未使用分は繰り越せません。Businessの年払いは年間分をまとめて付与し、上限は6,000ドルです。Businessではワークスペースと受取先API組織の両方の所有者が手続きし、提供対象の国・アカウント群による違いもあります。適用条件と付与額
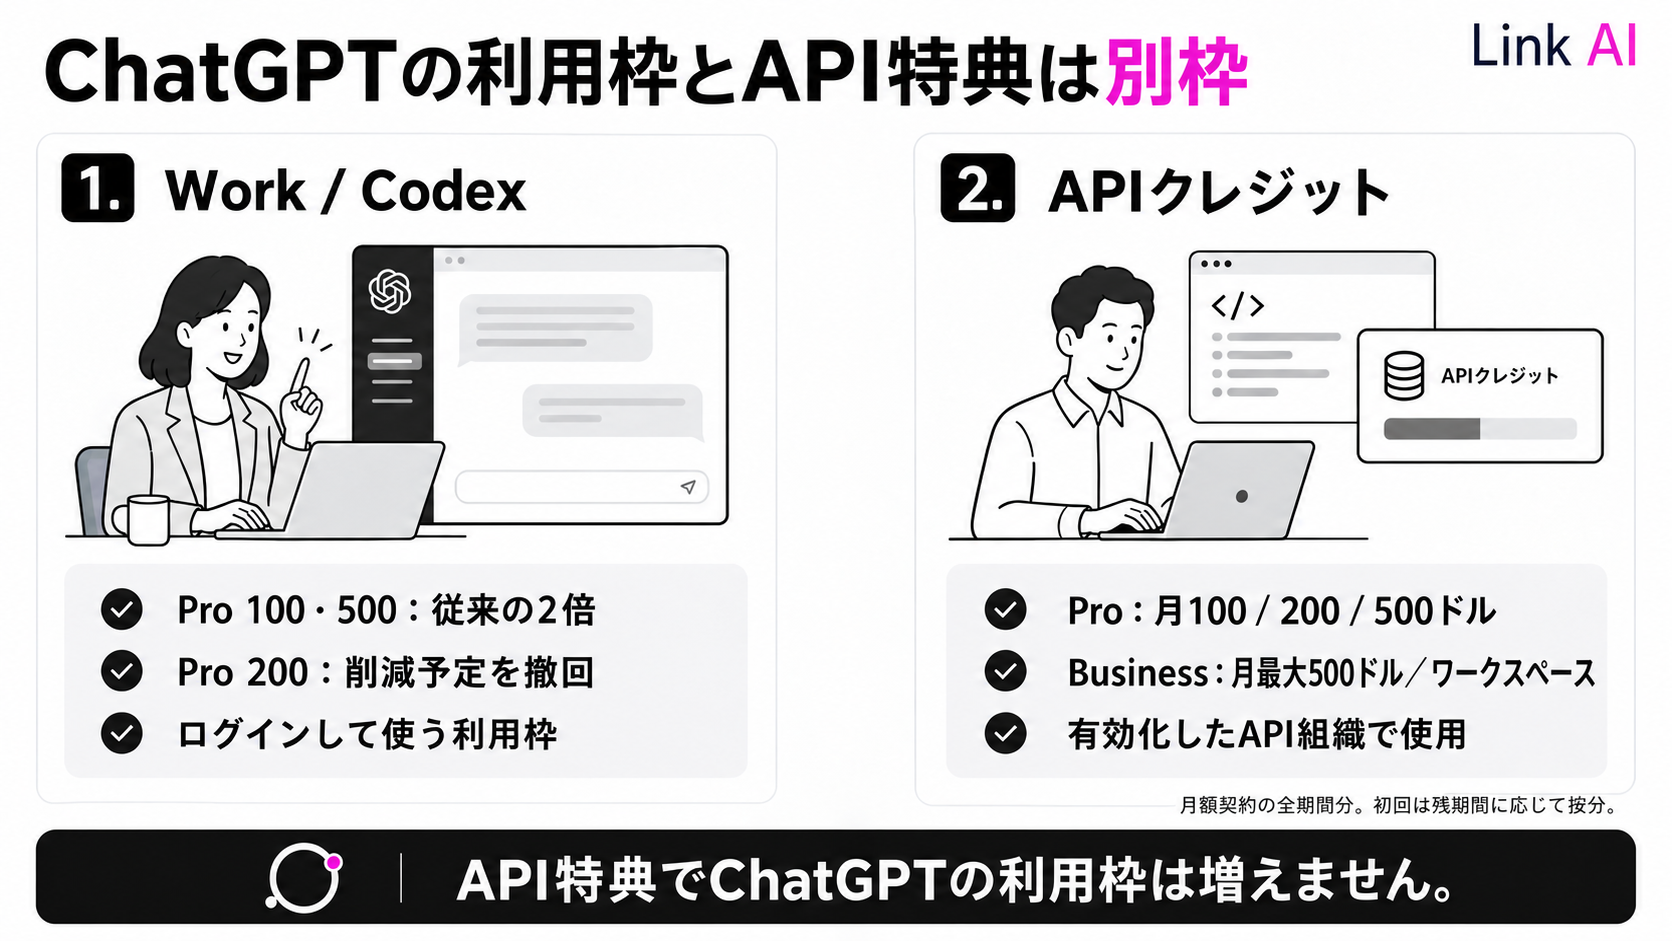
この特典はChatGPTやログイン型Codexの利用枠を増やすものではなく、APIキーを使うCodexの利用も対象外です。自社アプリのAPI費用を抑える特典と、担当者がChatGPT上で使える量の増加を混同しないことが重要です。アプリ開発の予算ではAPI組織の残高と期限を確認し、業務用アカウントの契約判断ではWork・Codexの上限を見る、という別々の管理が必要になります。対象範囲の説明
NVIDIAの文字起こしモデル――公開重みの強さと、測定条件の違い
NVIDIAは10月28日、「Nemotron 3.5 Transcribe」を公開しました。最大1時間の録音を処理し、日本語を含む40言語の文字起こし、翻訳、話者の区別などを扱うモデルです。言いよどみを残すか、読みやすく整えるか、専門用語をどう記すかを自然言語で指定できます。会話の途中を逐次処理するストリーミング型とは異なり、録音をまとめて処理する用途です。NVIDIAの発表
開発元以外の評価も出ています。Ocular AIはNVIDIAの研究チームと事前のセットアップを行い、米国英語の2人会話4本をConverse-STT v2で測定しました。単語の置換・削除・挿入の割合を示すWERは2.95%で、比較した公開重みモデルでは最良でしたが、Scribe v2の1.22%には届きません。同社は他モデルと同じ音声・正解文・正規化・採点を使っていますが、日本語の会議で同じ差になることまでは示していません。Ocular AIの先行評価
この試験では、相づちの「hm」という綴りが正規化で消えず、57件の挿入誤りとして残ったことも報告されています。単語を聞き取る能力だけでなく、相づちを残すか、表記を揃えるかという採点上の扱いも順位に影響します。議事録として読みやすい文章が必要なのか、発話を忠実に残す記録が必要なのかによって、望ましい出力は異なります。
配布はOpenMDW 1.1ライセンスで、商用・非商用の利用に対応します。軽量化したNVFP4版は96GBのRTX PRO 6000 Blackwellで動かす構成が示され、転写評価の誤り率はBF16版より相対的に3.6%高いとされています。また、宣伝される最大処理速度は最適化済みNIMによる測定で、その最適化は公開コードにまだ含まれていません。公開重みを入手すれば同じ速度と精度がそのまま得られる、と解釈しないことが大切です。モデルカードの精度・機材・実装条件
録音を外部サービスへ送れない企業にとって、出力形式を調整できるモデルを自社設備で動かせることは検討価値があります。一方、重みを利用できることと運用費がゼロであることは別です。既存の文字起こしAPIとの比較では、同じ録音・同じ表記規則での精度に加え、機材費と処理時間を確認する必要があります。
Sarashina初の思考モデル――ツール利用の伸びと、日本文化QAの低下
SB Intuitionsは10月29日、「Sarashina3.2 mini thinking」を発表しました。無償ベータ版のSarashinaサービスでAPI提供する、シリーズ初の思考モデルです。回答前に検討する量をlow・medium・highで調整でき、最大コンテキストは128Kトークン。従来のSarashina3 miniにもツール呼び出しはあり、今回のポイントは、その機能の新設ではなく、推論を加えた性能改善です。公式発表、新旧モデルの仕様
開発元の比較では、J-tauとBFCL v3というツール利用・関数呼び出しの評価で、比較対象中の最高スコアを示しました。一方、日本文化の知識を問うJamC-QAは前世代より低下。科学分野の難問を含むGPQA-Diamondや日本語の複数ターン対話では、Qwen3-235B-A22B-Thinking-2507やGPT-5.4 miniに及ばないとしています。評価結果と弱点
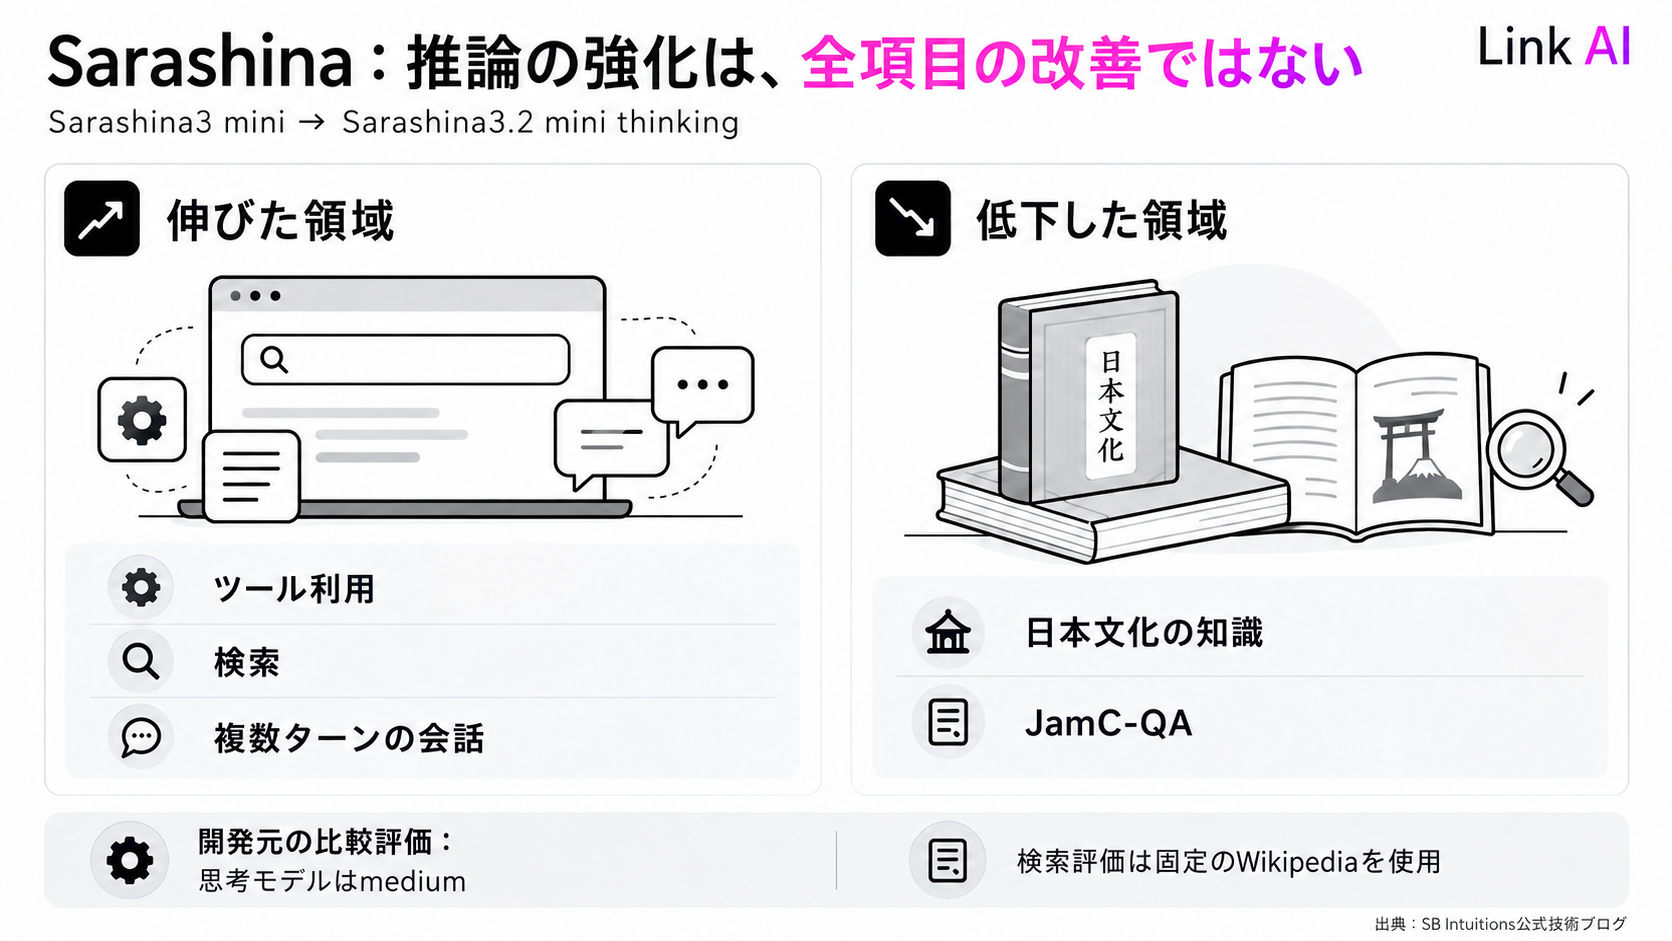
評価では、調整可能な思考モデルの設定をmediumに揃え、旧Sarashina3 miniは思考なしで測っています。図の数値は0〜1に正規化されており、単純に100倍して実務の成功率とは読めません。さらに検索評価のJEMHopQAは、2021年8月20日時点の日本語Wikipediaを固定して検索する試験です。現在のWebを自由に検索して正答する能力とは、対象も条件も異なります。評価の注記
「考える量を増やせば、日本語のあらゆる用途で前モデルを上回る」とは言えない結果です。特に、日本固有の知識を答える仕事と、取得済みの情報を使ってツールを選ぶ仕事では、評価すべき能力が違います。現時点では開発元の評価を中心に判断する段階で、新モデルの独立した追試による優位性は未確認です。
提供条件も本番運用とは分けて見る必要があります。APIは契約主体とモデルの組み合わせごとに毎分30要求が上限です。また無償版の入出力は学習に利用され得るため、社内の機密データを扱うサービスと同じ前提では使えません。性能評価用の公開データで比較できる機会が増えた、と捉えるのが適切です。レート制限、データ利用条件
OpenAIがWebサイトの学習方針を共通化へ――対応は今後数カ月
OpenAIは10月30日、WebサイトがAI学習への希望を示す共通の信号に対応する方針を発表しました。サイト運営者がrobots.txtで複数の参加事業者へ同じ意思を伝えられるようにするもので、IETFのAI Preferencesに関する議論を踏まえています。実装は今後数カ月を予定しており、発表時点ですべてのサイトに適用済みではありません。OpenAIの発表
価値があるのは、AI事業者ごとに個別のルールを維持する負担を減らせる点です。ただし任意の取り組みであり、すべてのAI事業者による取得を一括して阻止する仕組みではありません。既存のクローラー別設定も引き続き尊重すると説明しています。
企業サイトでは、「AIの学習に使ってよいか」と「検索結果で見つけてもらいたいか」を分けることが重要です。OpenAIは学習用GPTBotと検索用OAI-SearchBotを別々に制御できるようにしています。今回の対応予定を理由に既存設定を削除するのではなく、自社のコンテンツを何の用途に提供するかを先に決め、その方針を設定へ反映する必要があります。クローラーの公式説明
モデルを自社設備に置く場合とAPIで利用する場合では、性能以外の費用やデータの扱いも変わります。Link AIでは、こうした条件を踏まえたAIエージェント開発・導入支援を行っています。自社の要件に合う構成の検討は、お問い合わせからご相談ください。